


 役員SNS

Turing TechTalk#47 ストリーミング学習で実現する自動運転AI開発の高速化
はじめに
チューリングは、大規模な走行データを用いて自動運転モデルを学習し、実車で検証するサイクルを高速に回し続けています。モデルの試行回数はそのまま開発速度に直結するため、1回の学習にかかる時間をいかに短縮するかは、自動運転AI開発において極めて重要なテーマです。
今回のTech Talkでは、CTOの山口 祐とMLOps3チームのマネージャーである加藤 祐二が登壇。Amazon S3のRange GETと動画のインデックス、先読みと並列GET、帯域とレイテンシーの計測まで、MLOpsチームが取り組んできた学習パイプライン高速化の実践をご紹介します。
※本記事は「Turing Tech Talk #47」の内容をもとに、一部編集のうえお届けします。
今回は学習の高速化がテーマ
山口:皆さん、こんにちは。Turing Tech Talk第47回「ストリーミング学習で実現する自動運転AI開発の高速化」を始めていきたいと思います。今日はMLOps3チームの加藤さんに来てもらっています。加藤さん、今日はよろしくお願いいたします。
加藤:よろしくお願いします。
山口:今日は学習の高速化がテーマです。前回までは、例えばエッジ、自動車に乗せる計算機の方で、GPUの中で実行速度をいかに上げるかという話題を取り上げてきました。今日は、我々が自動運転AIのモデルを作るときに学習をさせるわけなんですけども、この学習側をいかに高速化するかがテーマになってきます。加藤さん、簡単に自己紹介の方をお願いしてもよろしいでしょうか。
加藤:はい。加藤 祐二といいます。今はチューリングでMLOps3チームのマネージャーをしています。もともとキヤノン株式会社で10年以上、XR(Extended Reality)やHMD(ヘッドマウントディスプレイ)とかCG、コンピュータービジョン、3D再構成とかの研究開発に従事してきました。最初は3DGS(3D Gaussian Splatting)を用いたクローズドループシミュレーターの開発をやっていました。その後、今やっている自動運転モデルの学習基盤の高速化とか効率化、スケーラビリティ向上に取り組んでいます。
山口:チューリングの開発の話題では、自動運転AIを作っているということはよく知られていますが、時々このMLOpsという言葉がでてきます。加藤さん、このMLOpsというのはそもそも何なんでしょうか。
加藤:チューリングにはMLエンジニアがいるんですけれども、そのMLエンジニアが学習をしたりデータセットを作ったりしています。そこのオペレーションをやりやすくするために、学習基盤やデータセットを作るところを担当しているエンジニアをMLOpsチームと呼んでいますね。
山口:加藤さん含めてこのMLOpsをやっている人は、チューリングの中では大体何人くらいいるんでしょうか。
加藤:今7人くらいですね。
内容紹介
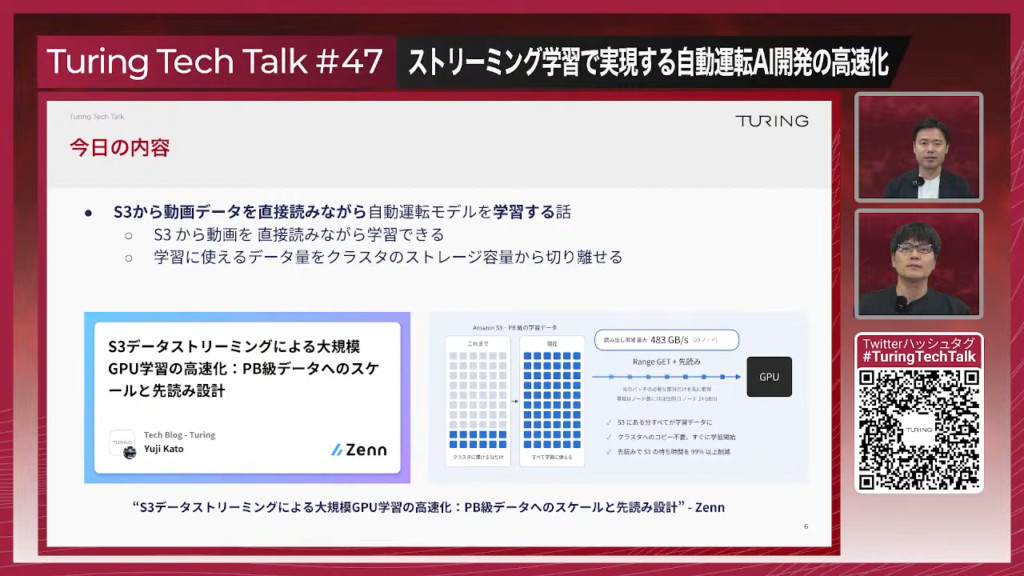
加藤:本日の内容としましては、S3から動画データを直接読みながら自動運転モデルを学習するという話をしたいと思います。ここでのポイントとしては、まずS3から動画を直接読みながら学習できるんだよというところ。それから、S3から読めるようになると、学習に使えるデータ量をクラスターのストレージ容量から切り離すことができるよという話をしたいと思います。この話は先日ブログに書いて出していますので、詳しい数値とかが見たかったら、こちらのブログを参照していただければなと思います。
S3はAWSにあるオブジェクトストレージです。ローカルにあるSSDとかとは違って、ほぼ無限のデータを置くことができるストレージになってますね。
山口:AWSのストレージサービスは、いろいろたくさんのマネージドなものが出ていますけれども、その中で最も歴史があって最もよく使われているのがこのS3といったところで合ってます。我々チューリングのデータも、このS3にあったりするってことですか。
加藤:そうですね。基本的には撮ったデータ、動画データだとか他のログのデータもS3に置かれるようになっています。
山口:チューリングが自分たち独自で走行データを取りためているというお話は、テックトークの度にさせていただいているんですけれども。この動画データ、あるいはそれに関連するようなデータも、基本的にはこのS3に元データが取りためられているということですね。
加藤:そういうことになります。
自動運転モデルの学習とは ─ 7カメラの映像と分散学習の待ち時間
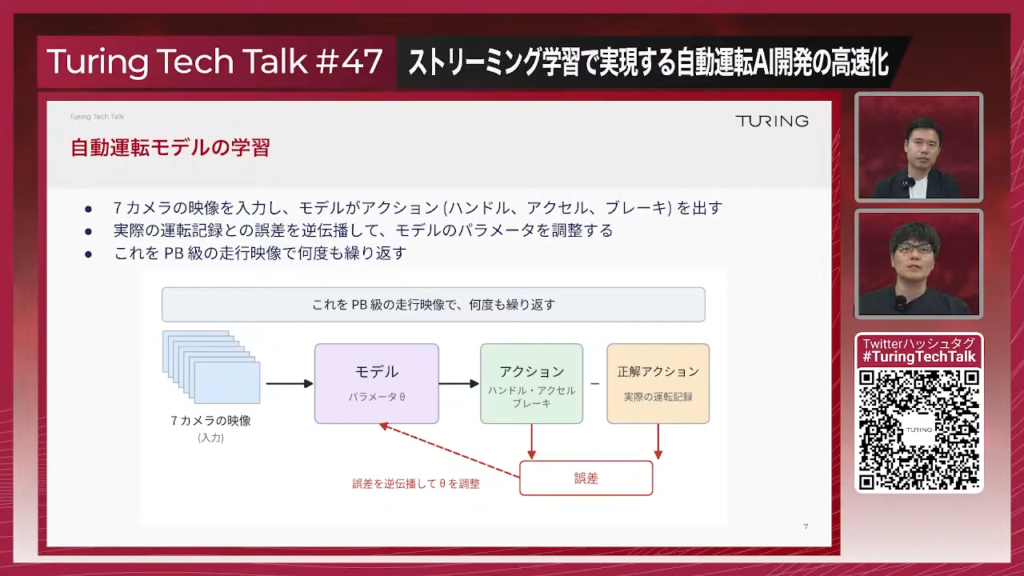
加藤:モデルに対して7カメラ分の走行した映像を入力して、モデルがアクション、どんな形でもいいんですけど、ハンドルとかアクセルといったアクションを出します。これに対して実際に運転した記録で、ハンドル操作とかの記録があるので、それとモデルが予想した誤差をモデルのパラメータに対して伝播してあげて、パラメータをどんどん調整していく。これをペタバイト級の走行データで何度も何度もモデルのパラメータを更新していくと、自動運転できるモデルができあがります。
山口:正解になるのは、人間のドライバーの人が手動で運転したものというイメージであってますか。
加藤:はい、合ってます。
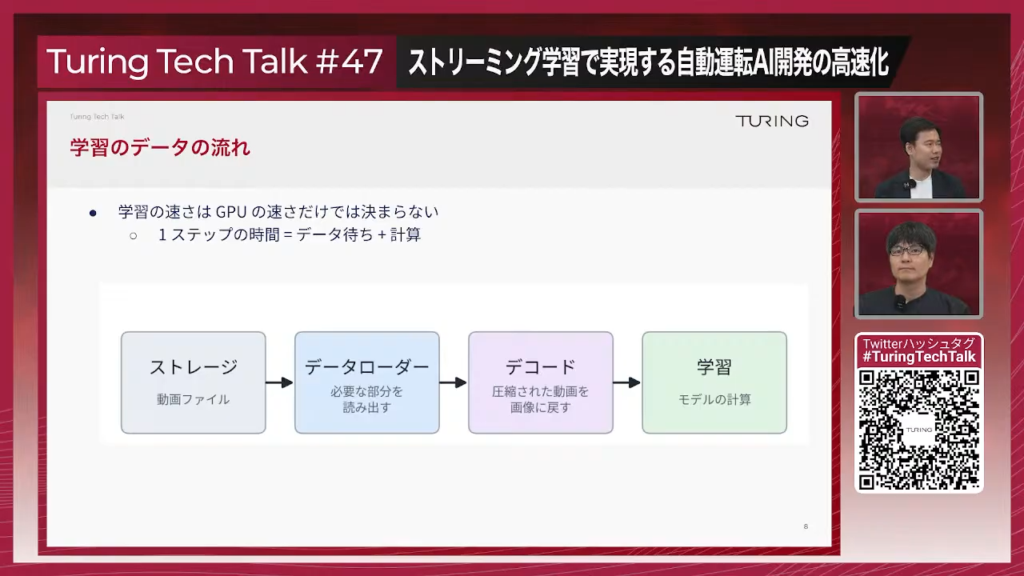
加藤:ストレージには基本的に動画ファイルが置かれていて、それをデータローダーで必要な部分だけ読み出します。圧縮された動画からデコードして元の連番の静止画に戻してやって、それをモデルに入れてやるという形です。このときのデータを待つ時間と、GPUで実際にモデルが計算する時間が、学習時間に効いてきます。
山口:これは静止画で持っていたらダメなんでしょうか。
加藤:静止画で持つという方法もあると思いますし、以前はやっていたんですけれども、静止画で持っているとまずファイル数がかなり多くなってしまう。画像に落とすと劣化もしてしまいます。基本的にJPEGなどで劣化すると画質が悪くなってしまうといった点もあるので、もともとの撮影したままの動画ファイルを持っていて、それを学習に使うときに処理してやろうという方針にしています。
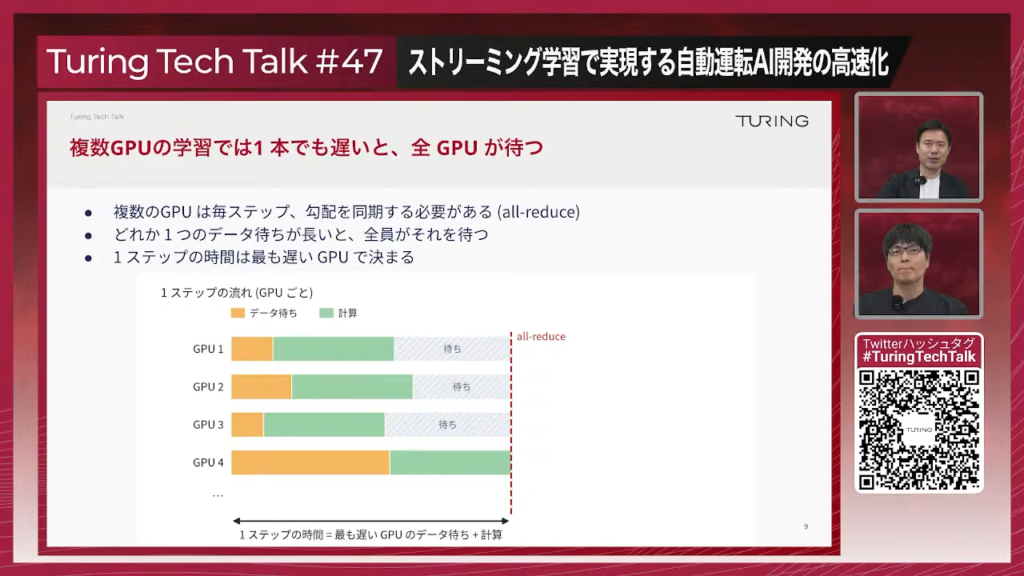
加藤:学習時間を左右するもう一つの要素が、複数のGPUで並列に学習する分散学習です。各GPUの勾配は毎ステップall-reduce(全GPUの計算結果を集約して共有する通信)で同期されます。
学習の時はGPU一つだけじゃなくて、例えば80ぐらいGPUを使ったりします。最後にその80個のGPUから出てきた勾配という誤差を集めて平均してやる必要があります。一つでも遅いものがあると全員がそれを待ってしまって、1ステップ全体としては一番遅い時間で決まってしまいます。
これまでの構成と課題 ─ Lustreへのステージングとストレージ容量の壁
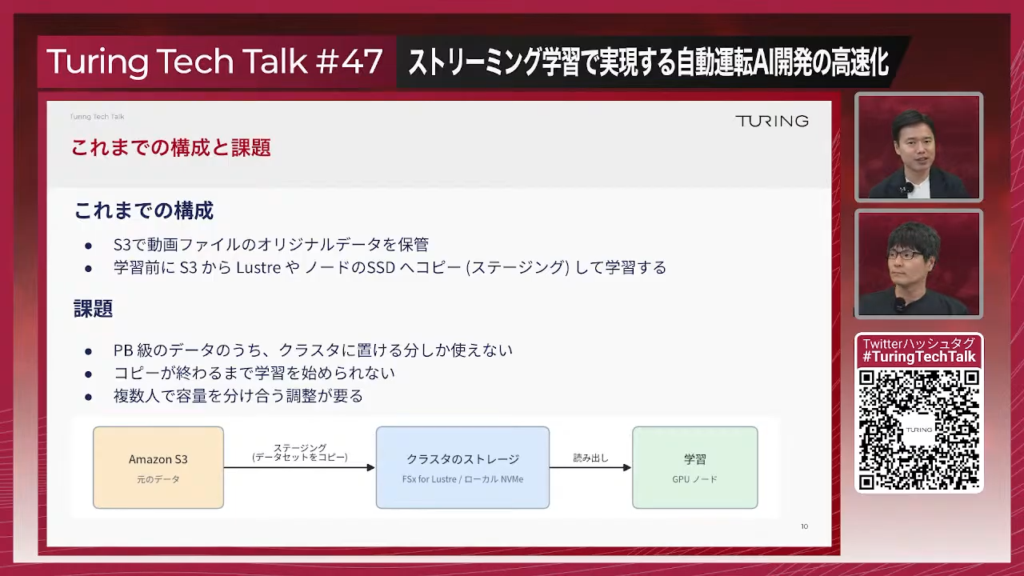
加藤:これまでの学習では、動画をGPUの近くにある高速なストレージへいったんコピーしてから使っていました。そこで使われていたのが、Lustre(並列分散ファイルシステム)です。
学習前にS3からLustreとかノードのSSDに使うデータをコピーして、それから学習を始めるという形になっていました。これだとペタバイト級のデータがあったときに、クラスターに置ける分しかデータとしては利用できない。コピーが終わるまで学習も始められない。AIエンジニアもたくさんいるので、複数人でストレージの容量を分け合って、ちょっと調整をしてから置いて使わなきゃいけないという、いろいろ面倒なところがありました。
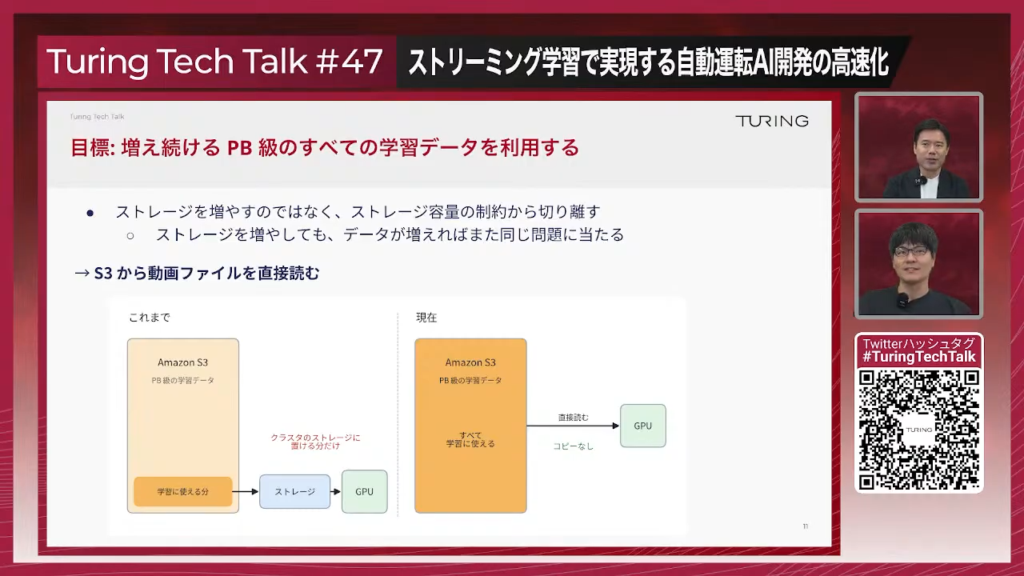
加藤:走行データを毎日取っているので、どんどんどんどん増え続けてしまう。Lustreを増やしていくというのもあるんですけど、金銭的コストもあったりとか、毎日増えていくデータに対してクラスターを増やしていかなきゃいけなくなってしまう。そこでS3から直接読めないかというチャレンジが、今回の話になります。
山口:これはすごい大胆な考えではあって、普通はやらないと思うんですけれども、なんでこれをやろうと思ったんですか。
加藤:これはもう置けなくなってしまうという課題が目に見えていたからですね。
山口:これはちなみにいつ頃やろうと思ったんですか。
加藤:7月ぐらいだったと思うんですけど。多分昔から、何とかしないとデータは増えていって置けなくなるよねという話はあったんですけど、ずっと誰も手をつけていなかった。7月ぐらいにやってみるかというので、急にやることになりました。
S3から動画を直接読む設計 ─ Range GET・インデックス・先読み
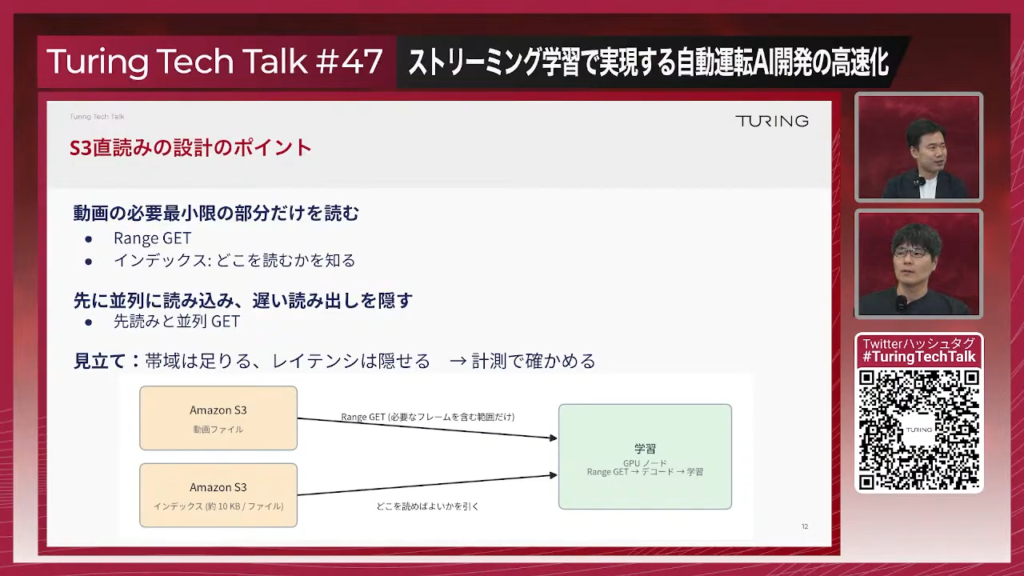
加藤:設計の柱は3つでした。必要なバイト範囲だけを取るRange GET(ファイルの一部のバイト範囲を指定して取得するリクエスト)と、どこを読むかを事前に記録したインデックス、そして先読みと並列GETです。
ポイントとしては動画のファイルを全部持ってくるんじゃなくて、必要最小限の部分だけ読んでくる、Range GETするというところ。それからちゃんと欲しいフレームに対してどこを読むかを知れるように、インデックスを作っておくというところですね。あとは基本的にS3から読むともちろんLustreやローカルのSSDよりも遅いので、その読み出しを隠すために先読みと並列ゲットをします。見立てとしてS3は結構帯域があって、帯域は足りるだろうと。レイテンシはちょっとどれぐらいあるか分からないんですけど、先読みの数を深くしていけば隠せるだろうということで、ここら辺を計測して実際に実装していきました。
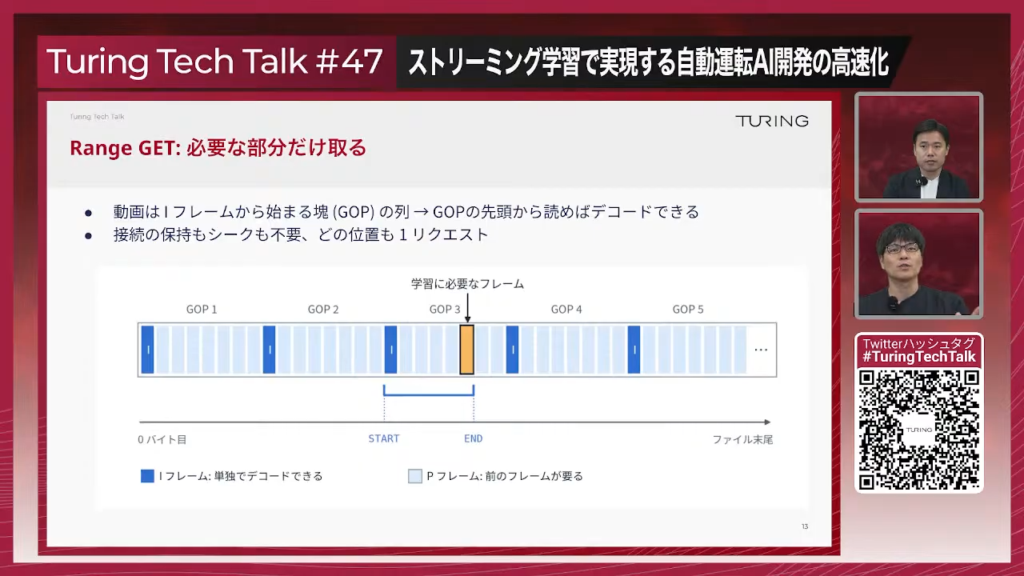
加藤:動画ファイルは、単独で画像に戻せるIフレームと、そこからの差分を記録したフレームの組であるGOP(Group of Pictures)の連なりでできています。
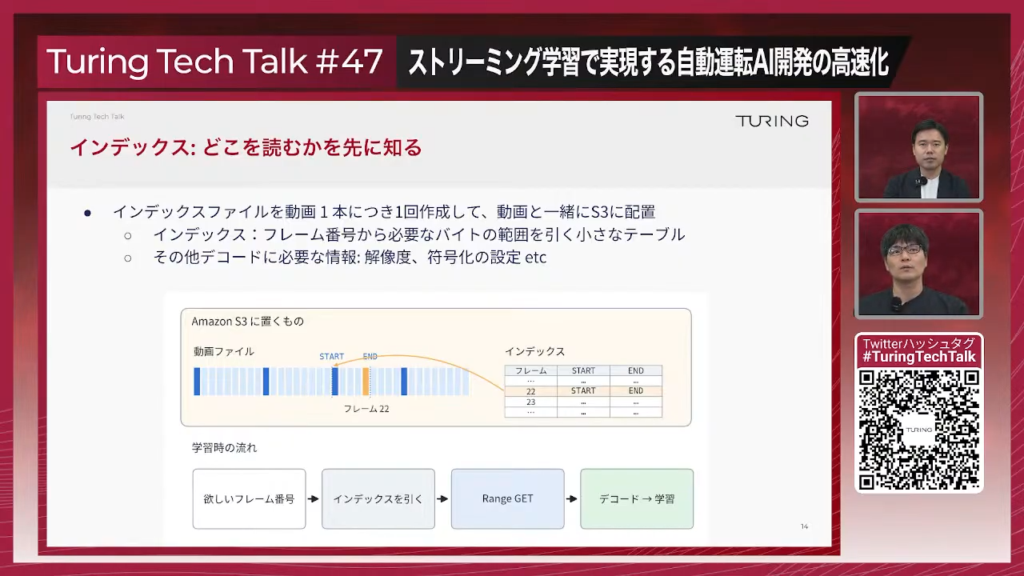
加藤:欲しいフレームだけ抜き取っても画像には戻せなくて、その欲しいフレームの前のIフレームから全部持ってこないと画像に戻せない状態になっています。インデックスファイルというものを動画1本につき1回ずつ、学習よりもずっと前に作成しておきます。動画と一緒にS3に保管しておくという形で、インデックスを引けるようにしています。欲しいフレーム番号が22番だよと決まったら、表のフレームの22に書いてあるスタートとエンドを持ってきて、そこをRange GETします。インデックスファイルには、ついでにその他デコードに必要な解像度とか符号化の設定とかも全部入っています。
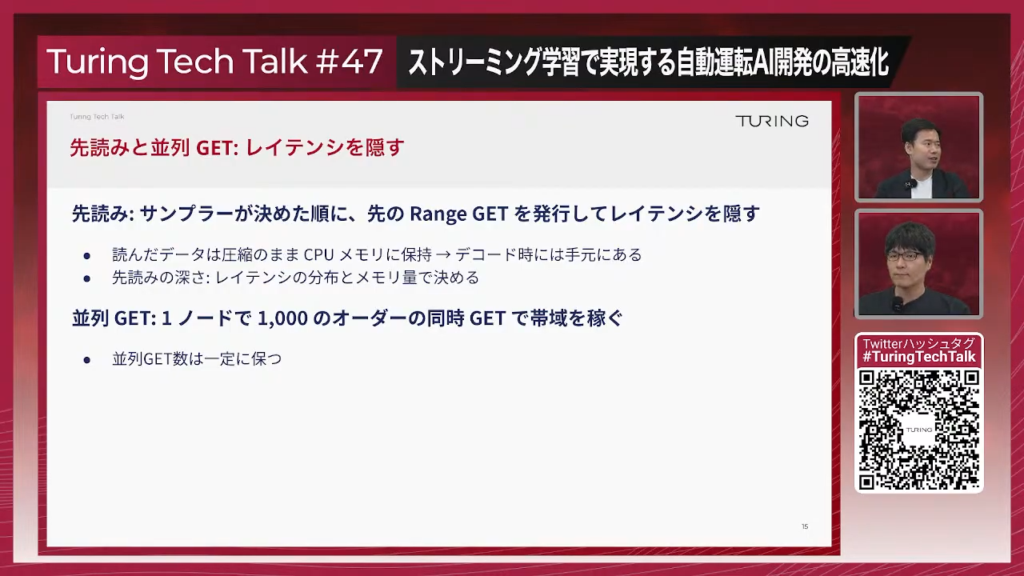
加藤:学習をするときはなるべくランダムに動画データを選んでモデルに入れてあげたいんですけれども、それを選ぶのがサンプラーです。サンプラーが与える動画の順番は決まっているので、それを見て先にRange GETを発行して読んでおく。読んだデータは圧縮のままCPUメモリに入れておいて、使うときにメモリから持ってくるだけで済むようになっています。先読みは深ければ深いほどレイテンシは隠せるんですけど、深くしすぎるとメモリを使うので、この辺は実際には実装やレイテンシの分布を見て決めます。並列は設計するときは確か1ノードで1000ぐらい一気にゲットしておけば帯域も稼げるといいよねということで、1000ぐらいに設定して始めています。
S3の帯域とレイテンシーを測る ─ 1ノード24GB/s、99%は350ms以内
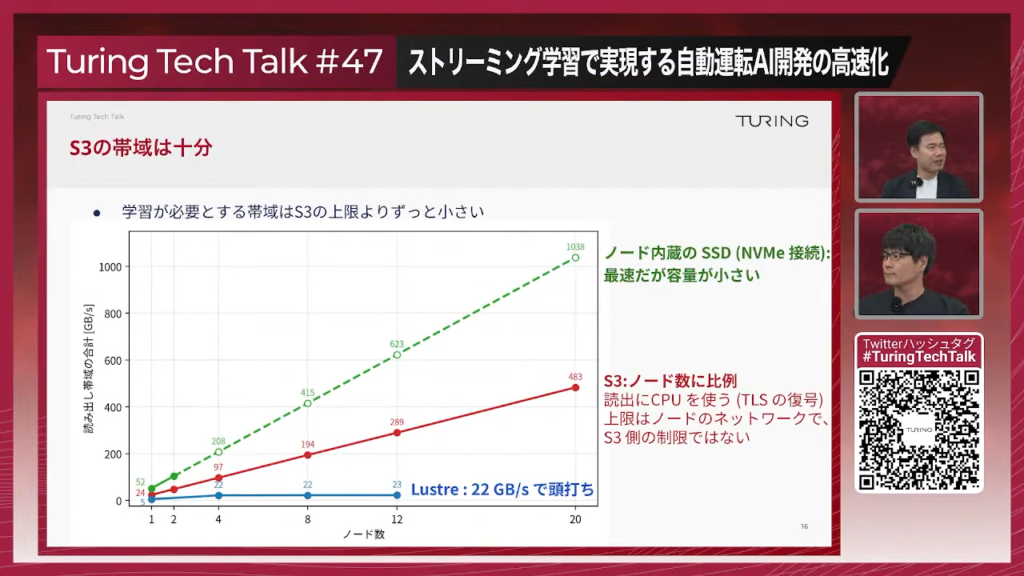
加藤:これは結構驚きの結果だったんですけれども、1ノードで読んだときに24GB/s出ていて、これはネットワークのカードの上限ぐらいで、S3側には問題がありませんでした。しかもノード数20まで並列にS3から読み出すのを試しているんですけど、線形に伸びていて、20台使えば20倍の帯域が出るという結果が出ています。それに対してLustreは、Lustre自体が1台なので、今回やったときは22GB/sで頭打ちでした。Lustreもお金を払えばどんどん上げていくことは可能なんですけれども、S3は特に気にせず帯域が十分出ているという形になります。
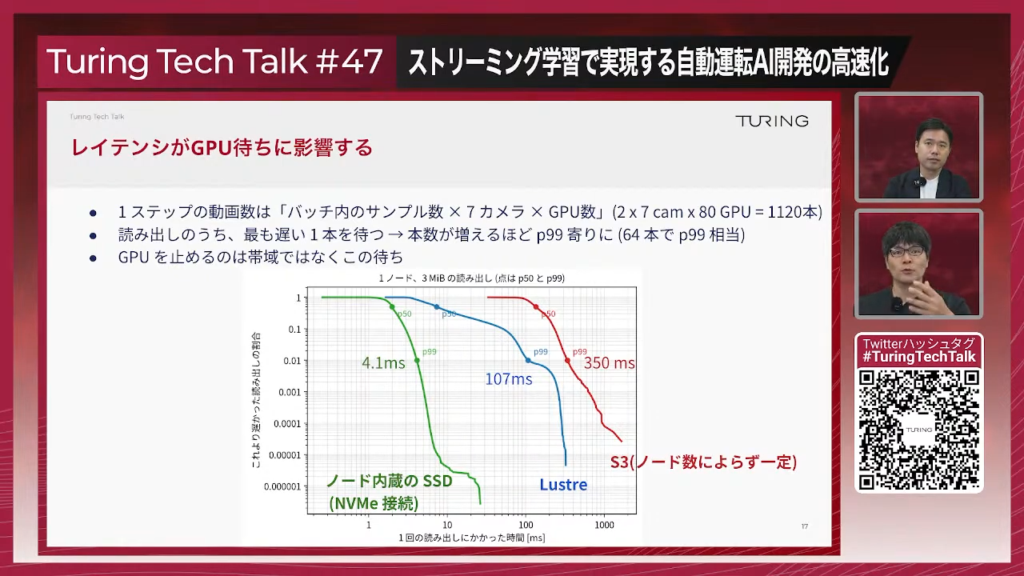
加藤:実際に問題になるのがレイテンシです。S3は100本ぐらいダウンロードしたら、99%は350ms以内に返ってきますよという形です。ノードのSSDだったらほとんど4msで返ってきて、Lustreだと100msぐらいあれば大体返ってきますよと。例えばサンプル数2で7カメラ80GPUだったら、1回で1000本ぐらいを持ってこなきゃいけない。そうするとどれか遅くなると全体が遅くなっちゃうという問題があります。350msとか、正直遅いとき1秒かかったりとかもあるので、ここを気にしていかなきゃいけません。
山口:私の直感で言うとS3のレイテンシはもっとあるのかなと思ってたんですよね。これを見るとS3も普通に結構レイテンシ悪くないなという感じです。ストレージにも得意なアクセスパターンと不得意なアクセスパターン、得意なブロックサイズと不得意なブロックサイズがあるので、なかなか一概に全てのファイルでこのようになるとは言えないです。今回のような動画のある特定のフレームだけピンポイントで取ってくる、これがたくさん発生するケースだと、こういった状態になるというのがこのグラフのポイントです。
先読みでデータ待ちはほぼゼロに ─ AIエージェントと詰めたGIL・GC・認証の壁
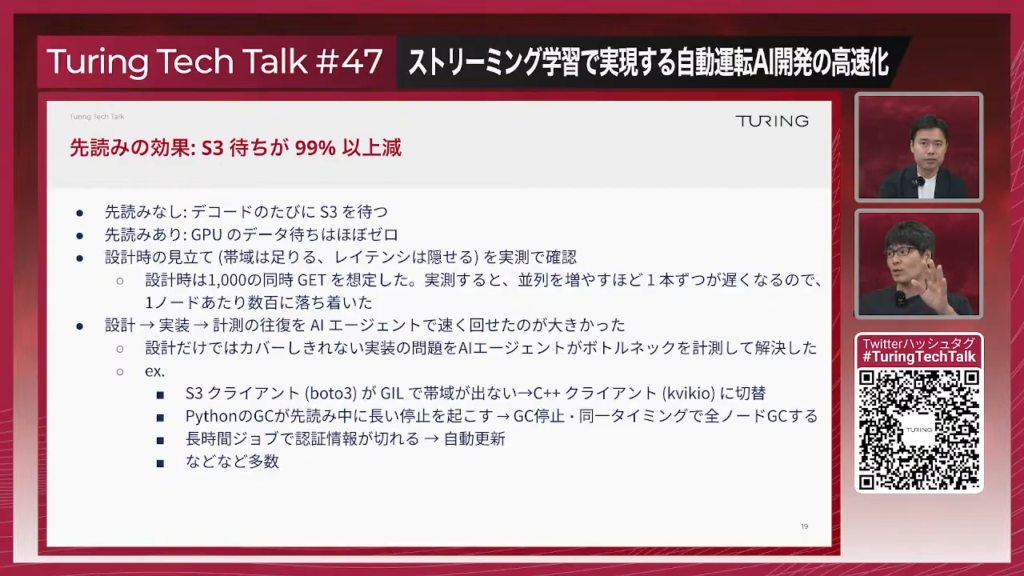
加藤:先読みありだとGPUのデータ待ちはほぼゼロになりました。設計時の見立てはちゃんと確認できましたよと。ただ実測してみると並列数を増やすとだんだん1本ずつ返ってくるのが遅くなったりしていきます。結果的には1ノードあたり数百とか、そういうオーダーに落ち着いたかなというところですね。実際にこれを試すので大きかったのは、やっぱり設計から実装、計測という往復をAIエージェントがすごく速く回してくれることで、これがかなり大きかったかなと思います。設計といっても、ほとんどポイント3つとかで始めているので、カバーしきれないところがいっぱいありました。そこにぶち当たるたびに、AIエージェントが計測して解決していくということをずっと繰り返していました。
壁の一つは、Pythonで複数のスレッドが同時に動けないようにするGIL(Global Interpreter Lock)でした。もう一つが、不要なメモリを自動で回収するガベージコレクション(Garbage Collection)です。
例えばS3のクライアントでboto3とかを使うと、Pythonを使っているとGILで帯域が全然出ない。変なところでGILに引っかかってしまうので、C++のクライアントに切り替えてやったりだとか。あとはPythonがガベージコレクションを先読みしている間に起こしたりすると、80GPUとかあったら、どれかがガベージコレクションしたら他も止まってしまう。そうしたら同一のタイミングで全ノードを1回ガベージコレクションしてあげたりとか。学習は結構長いので、途中で認証が切れてしまってゲットできなくなるのは、自動更新できるようにしたりとか。最初は想定していなかったところが結構出てきたんですけど、それも勝手に結構解決してくれたりして、こういうのを試すときにはすごく役立ちました。
山口:意外とこういう大規模な学習をしようとすると、Python自身のプログラミング言語としての制約にもボトルネックが当たりやすいんですね。
設計で気をつける点 ─ GETの課金とDNS、向くケースと向かないケース
加藤:実装してみて分かった注意点もありました。
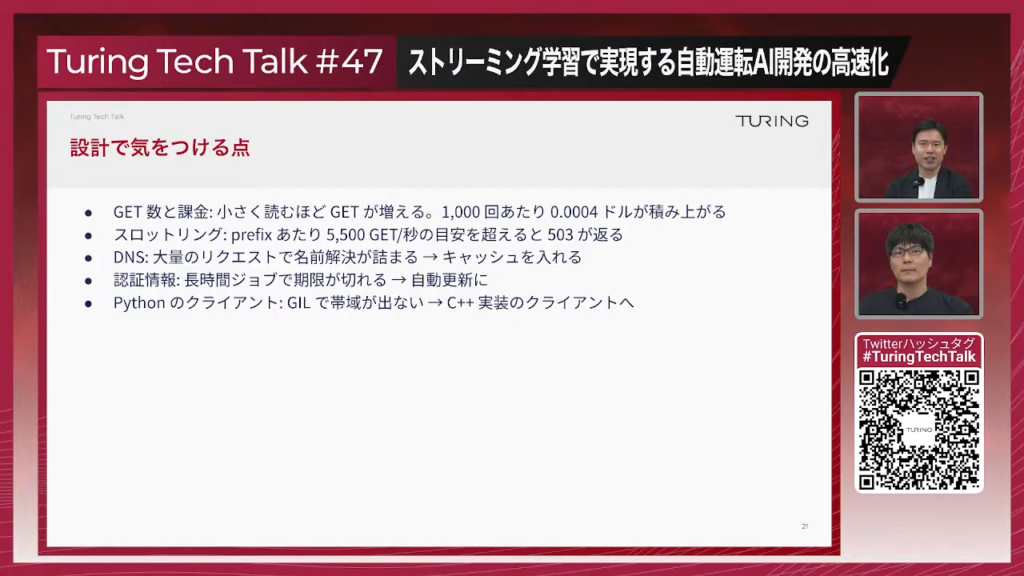
加藤:ファイル1つを1GETで読むのと、欲しいフレームだけをGETしてくるのとではGET数が全然違うので、小さく読むとGET数がめちゃくちゃ増えます。最初設計したときはGETは無料のような気持ちで設計したんですけど。軽い気持ちでこれをやると本当にすごい数のゲットが発生するので、ちょっとそこも意識した方がいいかなという気がします。
山口:1ペタバイトのデータを非常に細かいバイト数、フレーム単位で全部のデータで何回もなめることを考えると、とんでもない量のゲットのリクエストを投げなければいけない。これが普通に無視できない金額になりますし、これはもう解消しようがないですよね。ここの見積もりは正確にやった方がいいかなと。
加藤:DNSとか名前解決も大量にやりすぎると詰まってしまうことがあるので、ノード内で解決できる仕組みを持って、キャッシュを持っておくといった対策もあったりします。
山口:どこでDNSが必要になってくるんですか。
加藤:どこで詰まってるかちょっと分からなかったんですけど、どこかでDNSのエラーが出てきてしまうんですよ。
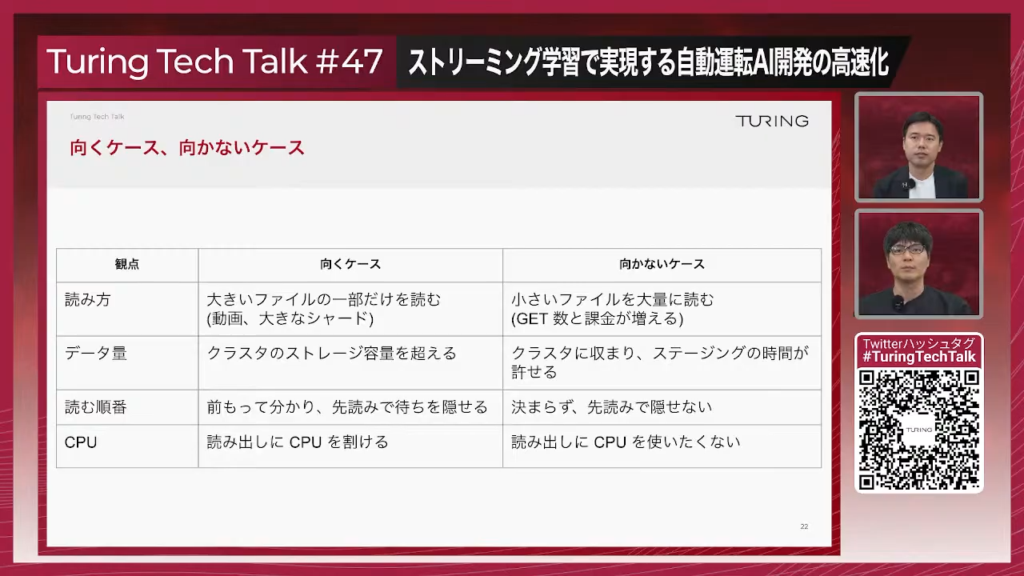
加藤:向くケースはやっぱり、大きなファイルの一部だけ読むときに、全部取ってくる必要がないというところです。小さいファイルを大量に読まなきゃいけないというのは、あまり向いてないかなと思います。クラスターに収まって、ステージングもコピーもしてもいいのであれば、やらなくてもいいかなというところではあります。あんまりお話ししてないんですけど、S3から読むと読み出し時にCPUを結構使うんですね。なのでCPUがカツカツの処理に対してこういうことをしようとすると、そこが問題になるかなと。
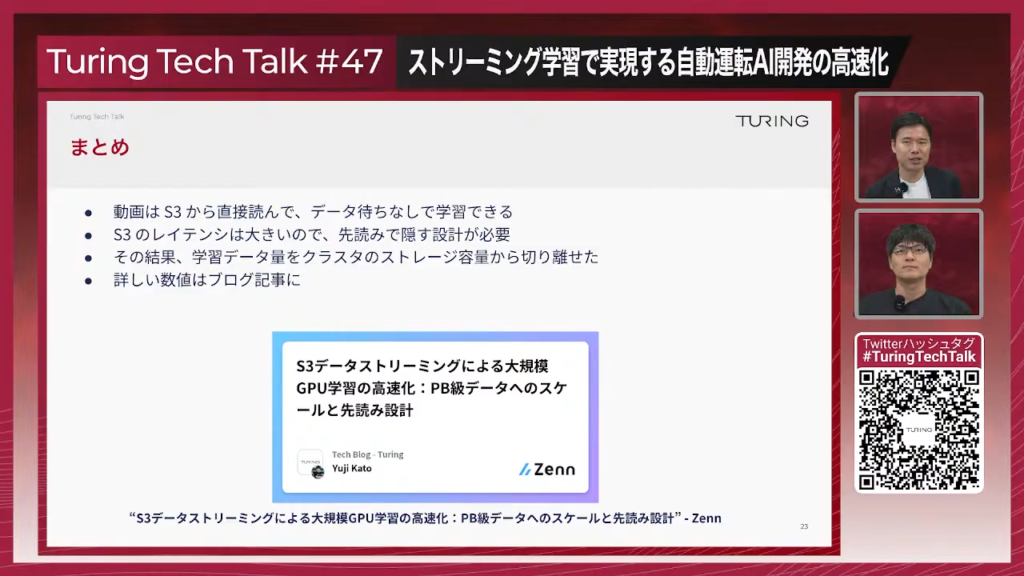
加藤:動画はS3から直接読んで、データの待ちなしで学習できるようになりますよと。そのときのポイントとしては、S3のレイテンシーが大きいので、先読みで隠すという設計が必要になります。
ペタバイト級のデータであっても、クラスターのストレージ容量から切り離して学習することができるようになります。
余談:4年前のテックブログとつながった
山口:ところで余談なんですが、チューリングのテックブログ、最初のテックブログって何だか分かりますか。
加藤:最初にカメラ映像で運転したよとか、そういうやつですかね。
山口:まさにそうです。ウェブカメラを車につけてハンドルを動かすことで、実際に車を動かしたというテックブログが最初なんですよね。2番目のテックブログは何か分かりますか。
加藤:次は、データをどうやって持つかですかね。
山口:その通りです。2番目のテックブログは私が書いたものなんです。S3からデータを直読みするにはどうしたらいいかというところで、ベンチマークを取って書いてあるんですね。このときのチューリングはGPUを全く持っていなかったので、全く机上の空論だったんですね。今日説明してもらったことが、今4年の時を経て実現されているということで、私として結構感慨深いものがあるなと思います。
ちなみに当時は、S3から直読みはちょっと苦しいよねという結論を言っていました。
Q&A一覧(一部抜粋)
配信中は視聴者のQAに回答していきました。詳しくは動画をご覧ください。
・トレーニングの際の対象はインデックス化された部分に限られるとのことですが、ここで疑問なのは、データを分割する処理は一体誰あるいは何が行っているのかという点です。
・S3のAPIリクエスト数のリミットには当たらないのでしょうか。
・自動運転の学習データは時系列データなのでしょうか。Range GETのお話を聞くに、1フレームあたりでAIが判断しているのかなと思ったのですが、どうなのでしょう。
・事前に学習の計画、誰がどのデータで学習を回すかを立てて実行しているのでしょうか。
・動画以外のデータもS3に保存されており、インデックスをもとに必要な情報を取ってきていると思ってよろしいのでしょうか。
チューリングでは、完全自動運転の技術を共に創る仲間を募集しています。今日お話ししたMLエンジニアはもちろんのこと、機械学習エンジニア、リサーチャー、ソフトウェアエンジニア、組み込みエンジニア、インフラエンジニアなど、非常に幅広いエンジニア職種で仲間を募集しています。ご興味のある方は、ぜひ採用ページをご確認ください。多様な職種がありますので、ご自身がどれに当てはまるか、ぜひチェックしてみてください。


