


 役員SNS

Turing TechTalk#46 車載AIの計算資源を拡張する ─ eGPUで加速する自動運転モデル開発
はじめに
チューリングの自動運転AIは、車載計算機の上でリアルタイムに推論しています。その周期は1秒間に10回(10Hz)です。
モデルのパラメータサイズを大きくすれば性能が上がると期待される一方で、既存の車載計算機では10Hzに間に合わないモデルもあります。大きなモデルをいかに早く実車で試せるようにするかが、大きな技術的課題になっています。
今回のTech Talkでは、CTOの山口 祐とDriving System3チームの猪狩 恒貴が登壇。eGPUの構成やOCuLinkによる接続、推論エンジンtinygradによる高速化まで、大きなモデルを実車で動かす車載推論システムを詳しく紹介しました。
※本記事は「Turing Tech Talk #46」の内容をもとに、一部編集のうえお届けします。
四輪ロボットの自律制御から、自動運転へ
山口:本日はDriving System3チームの猪狩さんに来てもらっています。今日のタイトルの計算資源は、どちらかというと学習のために使うというよりも推論、つまり車の中で実際にモデルを予測させる、動かすところでどう最適化するかがテーマです。猪狩さん、簡単に自己紹介のほうをお願いします。
猪狩:Driving System3チームの猪狩 恒貴と申します。大学のときはロボコンのサークルに所属していて、四輪のロボットの自律制御などをやっていました。大学の3年生ぐらいの頃からインターンとしてやっていて、それからずっと自動運転のシステム周りを特に見てきました。最近は自動運転システムの中でも、特にモデルの推論の高速化を結構メインで見ています。
山口:猪狩さんのいるDriving System3チームは、大体何人ぐらいのチームなんでしょうか。
猪狩:今は正社員では3人で、インターンが1人か2人ぐらい。そのぐらいの規模感になっています。
eGPUとは何か ─ 外付けGPUという「第三の選択肢」
山口:このeGPUという単語を知らない人も聞いている人の中には多分結構いるかなと思うので、まずこれについてだけ説明してもらえますか。
猪狩:eGPUというのは、ExternalGPUの略です。普通の使われ方だと、ノートパソコンなどに何かしらのケーブルでGPUをつないでノートPCなどでも強いGPUを使えるようにする技術です。結構安く、それなりのGPUを使った環境を手に入れたいという人向けに使われていたりもします。
山口:eGPUはオンボードのGPUとも、後付けのPCIe(PCI Express:拡張カードの接続規格)のGPUともまた違う第三の選択肢ですね。
猪狩:そうですね。ただ、使われ方としては結構ディスクリートにちょっと近い形です。PCIeなどがなくても、一応ノートPCなどでも動かせる選択肢になっているかなと思います。
山口:割と最近は、このeGPUはそんなに流行っていないですね。商品としても多分昔ほどはブームではないと思っているんですけれども、それが今なぜこの自動運転で使われているのか。ここから先は猪狩さんにバトンタッチして解説をします。
Orinを積んだ既存の車載計算機 ─ 10Hzの制御周期という制約
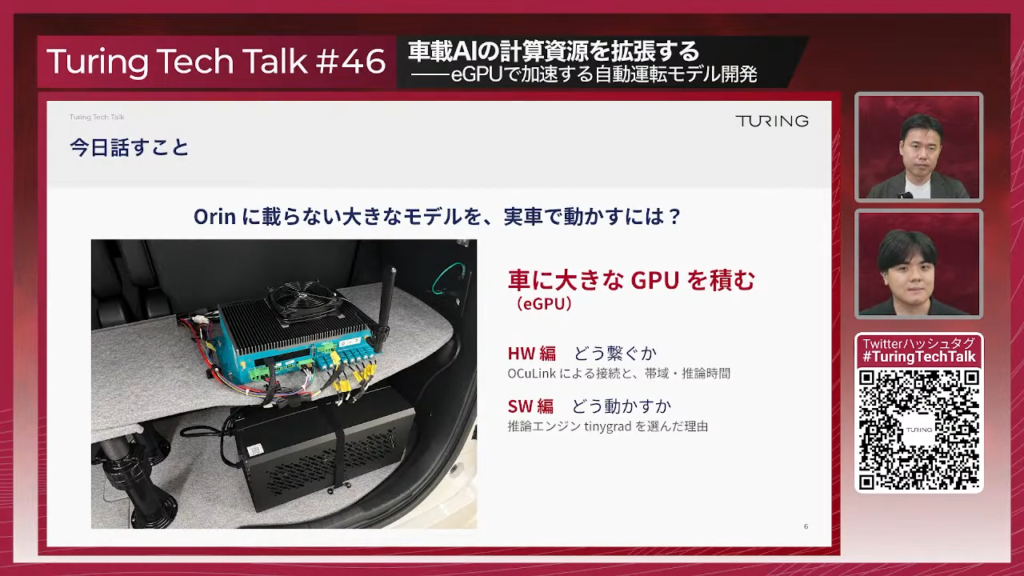
猪狩:eGPUの写真をここに載せています。上段にある水色の箱は普段使っている車載計算機で、これはeGPUとは関係ありません。Orinを積んでいる、通常の自動運転開発で使われる車載計算機です。下の段にある箱が、今回話すeGPUです。上の車載計算機とケーブル1本でつなげて動かすもので、こんな感じで結構コンパクトに車載ができます。ノートPCにeGPUをつなぐとなったときに結構問題として出てくるのは、PCとGPUの間の通信が当然発生するので、ちょっと遅いなというものです。あとソフトウェア的にはドライバーが噛み合わなくて、安定して動かない、そもそもGPUを認識してくれないといった問題が結構あります。それらについて今回の構成ではどうやって対処していったかを話せればと思います。
山口:Orinという単語が出てきましたけど、このOrinというのは何でしょうか。
猪狩:NVIDIAが作っている、組み込み向けのGPUになっています。
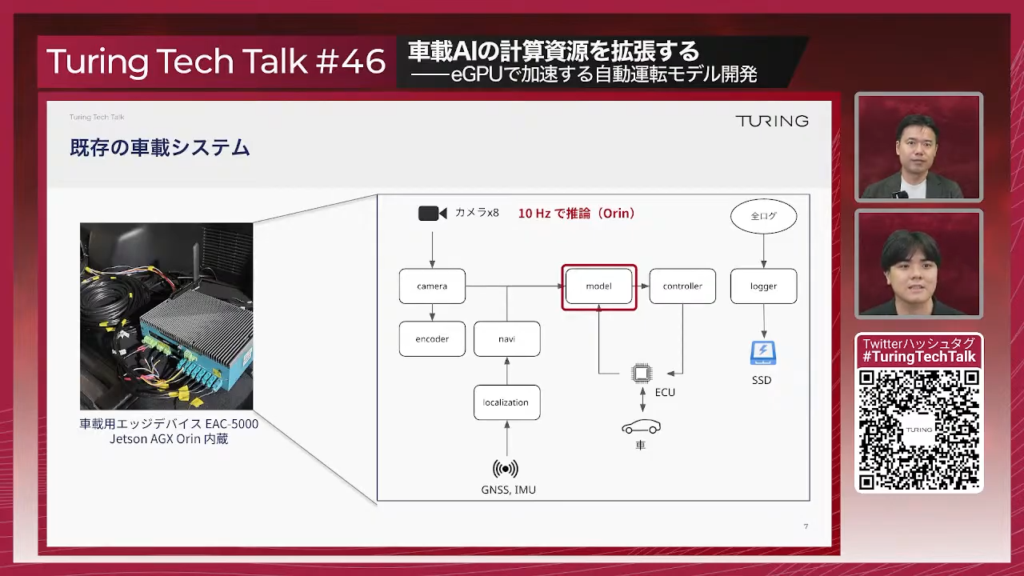
猪狩:基本的にはシステム自体は上段にあった水色の計算機ですべて完結するようになっていて、この中ではいろいろなプロセスが走っています。その中で特にモデルを推論させるプロセスが、基本的に今回の話の主題になるかなと思っていて。これがシステム全体の制御周期にちゃんと間に合うように動かなければならないという制約がある中で、どうやって高速化するかという話になっていきます。
山口:基本的にはこの計算機だけで、10Hzでモデルがリアルタイムに動くように今の既存のシステムが作られているということですね。じゃあ、これで作られているんだったらもうこれで十分じゃないかと思っちゃうんですけれども。そういうわけにはいかないですか。
なぜ大きなモデルを実車で動かしたいのか ─ 量子化に頼らず検証する
猪狩:結局モデルのパラメータサイズなどを基本的には増やしていくと、性能が上がると期待されます。その中で大きいパラメータのモデルを載せられるものなら載せたいよね、という話があって。やっぱりこのOrinでは全然10Hzに間に合わないようなモデルも動かしたいよ、という要望が社内でもあったりして。それでこういうものを作ることに至っています。
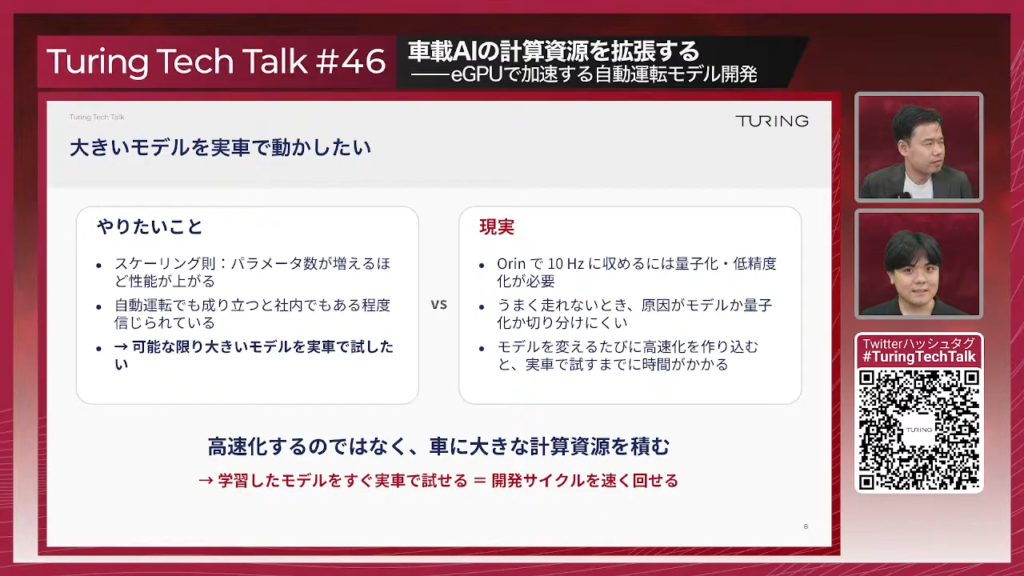
猪狩:やっぱりとにかく大きいモデルを一旦は載せてみたい、という需要があるんです。当然ある程度実際に量産などをする話になったら、載せる計算機のコストなどは限られてくるんだけども。それはそれとして、一回パラメータを増やしたらどれくらい性能が良くなるのかを見たいという需要があります。もちろん、計算機そのものを増やすことに頼らずとも、Orinで頑張って推論させる、アルゴリズムの高速化の方を頑張っていく方向性もあり得るわけです。それこそ速いCUDAカーネル(GPU上で実行される計算処理の単位)を頑張って開発したり、量子化(数値を少ないビット数で表して計算を軽くする手法)をやってみたり、いろいろやる余地はあります。
ただ、そもそもモデルのパラメータサイズを大きくして性能が良くなったかを見たいのに、量子化したことによって精度が下がるということが起こるかもしれない。それじゃ検証にならない、というのが一つ。あと完全にカリカリにチューニングされたCUDAカーネルを書くのは、結構開発のコストにもなっちゃう。大きい計算機を載せて、ちょっと多少は無駄があるかもしれないけども計算機が大きいから動く。そういう状態になっていた方が、モデルの開発サイクルとしては早くできるんじゃないか。そういう思惑があります。
山口:であればもともと強いワークステーションのようなものを載せて動かしたらいいじゃん、とか思っちゃうんですけども。そういったことは試したことはなかったんですか。
リモート推論からeGPUへ ─ 計算機2台構成とLANの帯域という壁
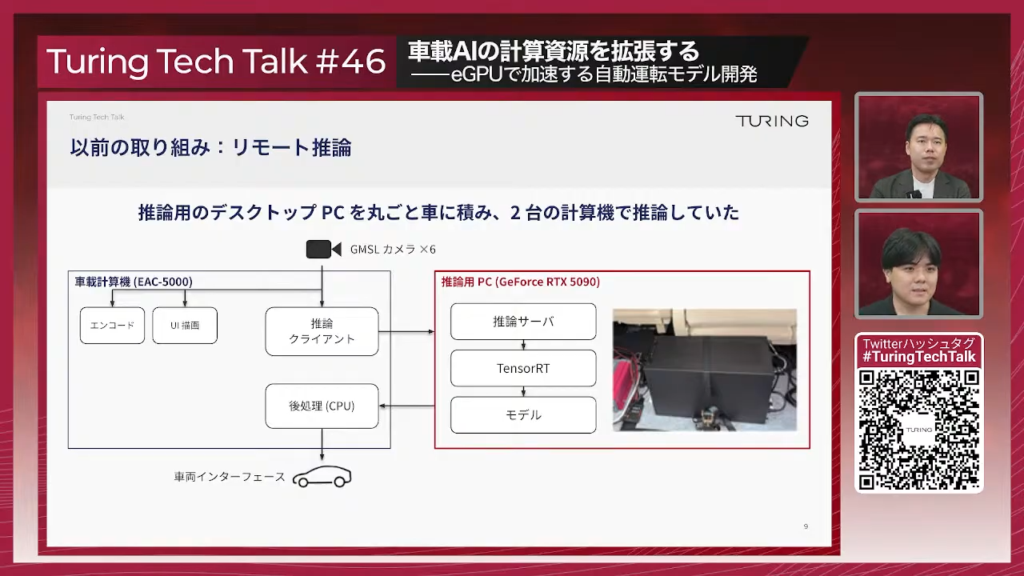
猪狩:本当に過去、まさにそういうことを試していました。デスクトップのPCを車に載せて、このPC自体を推論のサーバーのように運用し、車載用のPCとLANケーブルでつないでネット越しに推論させる。そういう取り組みは実際に存在しています。
山口:これは力技ですけど、普通に思いつきそうな話かなと思っているんですけど。これはなんでダメだったんですか。
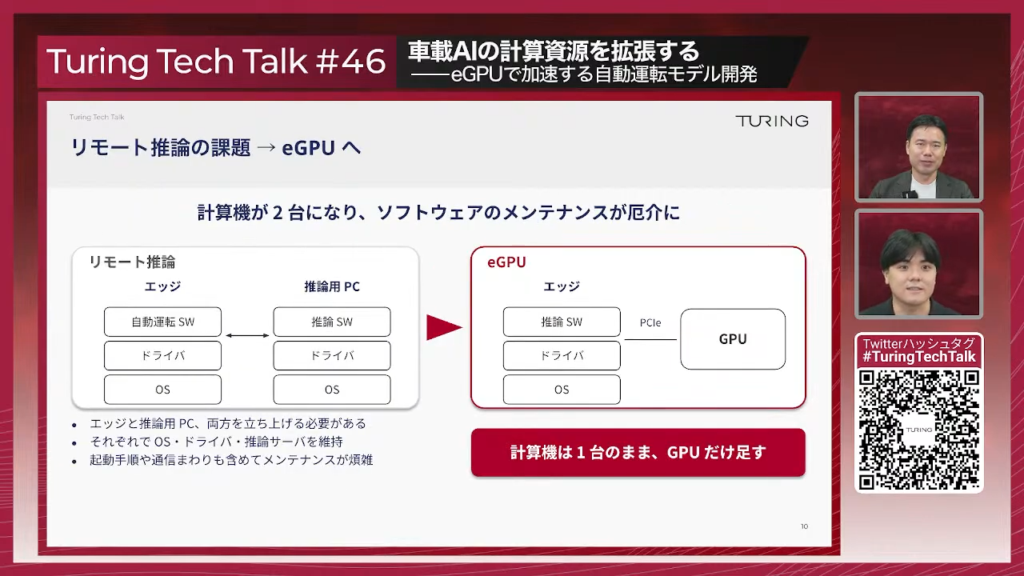
猪狩:結局、PCが2個に増えちゃうわけですね。PCもソフトウェアも2つに増えて、2つのソフトウェアをうまいことタイミングを合わせて立ち上げるようなことが必要になってしまう。結構2つのソフトウェアを管理するという、ソフトウェアのメンテナンス上でもちょっと大変という話が出てきてしまったのが、まず1つあります。あとちょっとここにも書いていないんですけども、通信ですね。結局推論を別のPCにオフロードするので、カメラの画像などを別のPCに送りつけなきゃいけない。LANケーブルでつなぐとどうしてもそんなに速さが出ないので、結局そのレイテンシ的にもあんまり良くないという話もあったりして。もうちょっとシンプルな構成の方が、管理もしやすくて早く動かせたりするんじゃないか。そういう経緯があって、eGPUの開発をするに至っています。
山口:例えば普通のイーサネットケーブルの1ギガの帯域で通信したとすると、1Gbpsなので125メガバイトが1秒間に送れる。10ヘルツでやろうとすると、0.1秒で12.5メガバイトしか1ギガのイーサネットケーブルではデータを送れないんですよね。我々の車って、カメラが何個付いているんでしたっけ。
猪狩:今使っているのだと、7個は使っていますね。
山口:少なくとも7個のカメラの映像を1秒間に10回はどんどん送りつけなきゃいけないから、イーサの1ギガなどの細い帯域だと結構厳しい。それが、結構そもそもシステム上の制約としてあるわけですね。
eGPUの構成とOCuLink ─ GPUだけを外付けする
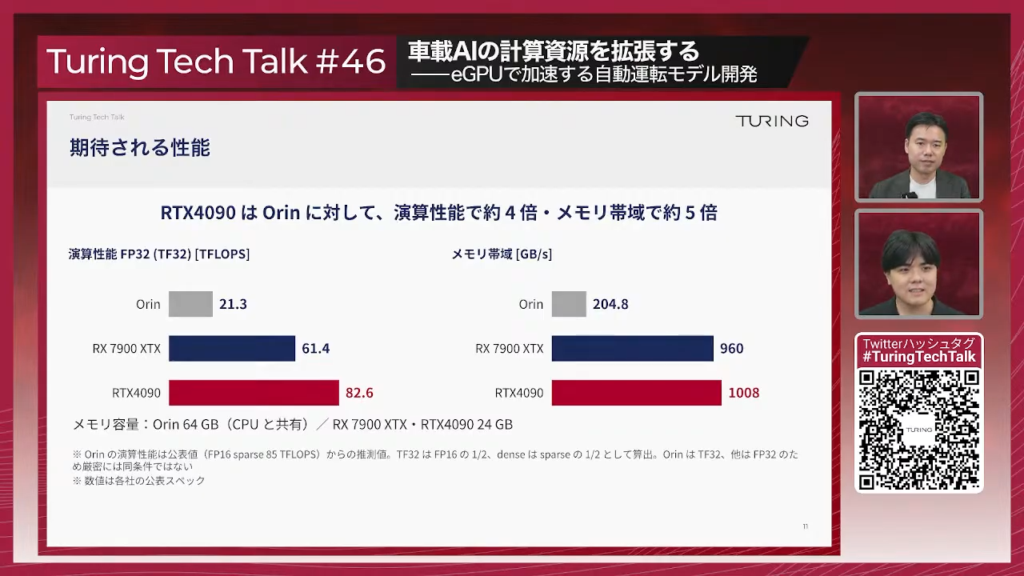
猪狩:一応これはカタログスペックなんですけども、大体単純にTFLOPS、つまり秒間で計算できる値で比較します。RTX4090を載せた場合でも、Orinと比べて4倍とかそれぐらいの性能があることは期待できます。メモリーの帯域、VRAMの帯域でも5倍ぐらいあるので、単純にOrinでやるのと比べると相当性能が上がることが見込めます。それはカタログスペック上でも確かめられます。
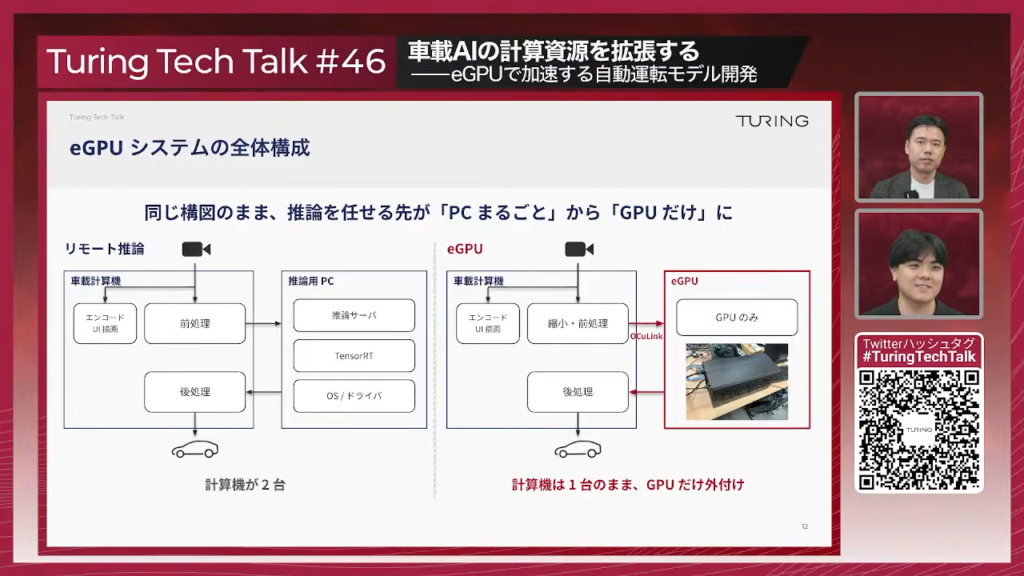
猪狩:もともとの構成ではデスクトップのPCに推論サーバーを立てて、推論ソフトウェアとしてまるっと動かす形になっていました。ここの部分を本当に必要なGPUだけにして、GPUに直接画像を送り付けて推論結果を得るというシンプルな構成になっています。
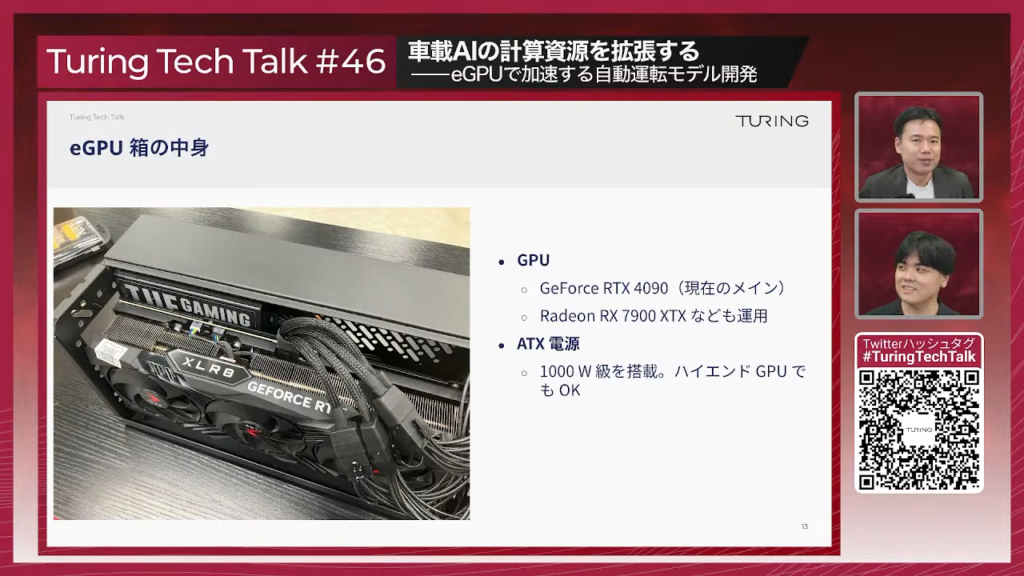
猪狩:eGPUの中身は、見ての通りGPUとATX電源だけが入っているという形になっています。
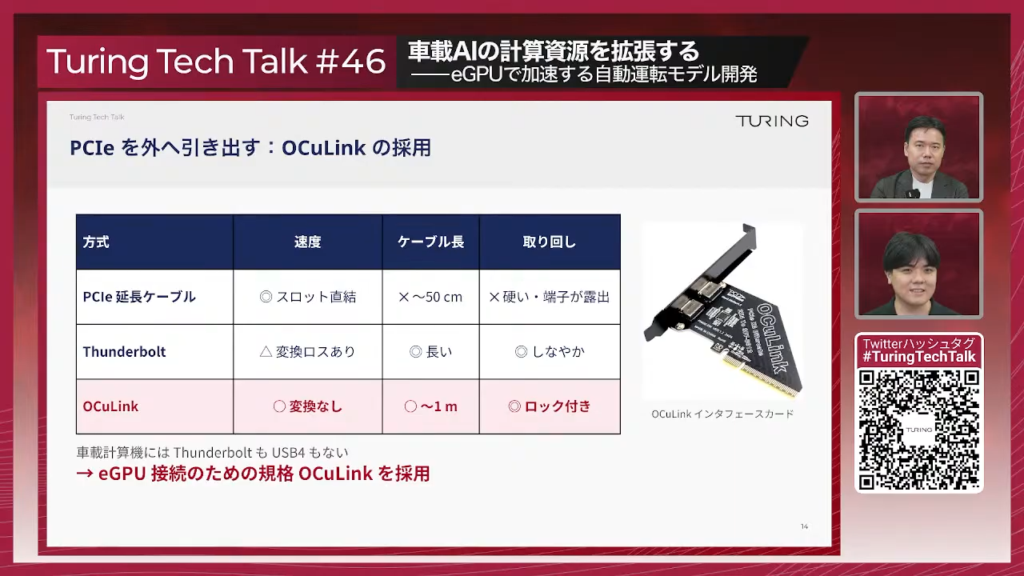
猪狩:車載計算機とGPUをつなげるケーブルについては、本当に普通のノートPCにつなげるeGPUと同じ候補が考えられました。一番いいっちゃいいのは、PCIeをそのまま延長してしまうことでした。ただ、これはさすがに車載するとなったときに安定して組み付けられる気が全くしないぞ、というところで。Thunderbolt、USBでつなぐのは配線の取り回し的には一番いい選択なんですけども。とはいえ帯域も、ThunderboltはPCIeとはまた違う形式なので変換が挟まるんですね。それによってレイテンシーが挟まってしまうので、これもちょっと見送りました。OCuLinkという、本当にeGPUのために考えられた規格なんですけども、PCIeをそのまま外に出せるケーブルを採用しています。
推論時間の比較 ─ 転送時間を加えてもOrinの1/4以下に
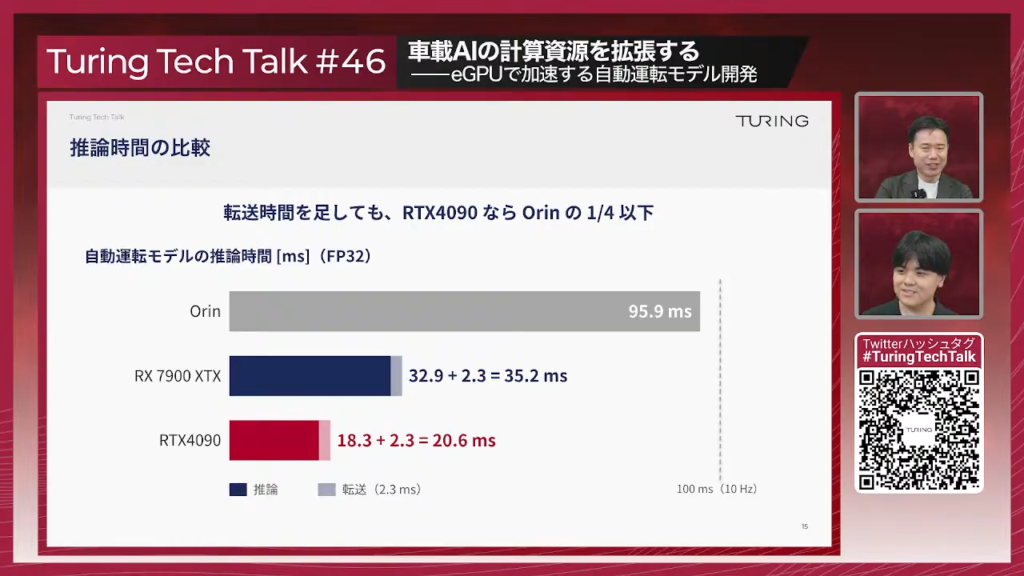
猪狩:こちらが実際に、とあるよく使われている自動運転のモデルの推論時間の比較を示したものです。推論時間といっても、eGPUで推論する場合には推論時間の本体に比べて画像を転送するというものもあるので、それも含めた図になっています。この転送にかかる時間が大体2.3msぐらいになるんですけども、それを加味してもそもそものやっぱりGPUの性能がOrinと比べて4、5倍あります。全体としても、本当に推論時間が1/4ぐらいになるようなものができています。
山口:このOrinで動かすのは95.9msとあるので、ほぼほぼ100ms。10Hzだと、これはかなりギリギリですよね。4090やRXの7900などを使うとだいぶ余裕ができるというか、場合によっては30Hzぐらい出るんじゃないかという感じになっていますよね。転送速度もだいぶ速いですね。
推論エンジンにtinygradを選んだ理由 ─ カーネルを手書きせず探索する
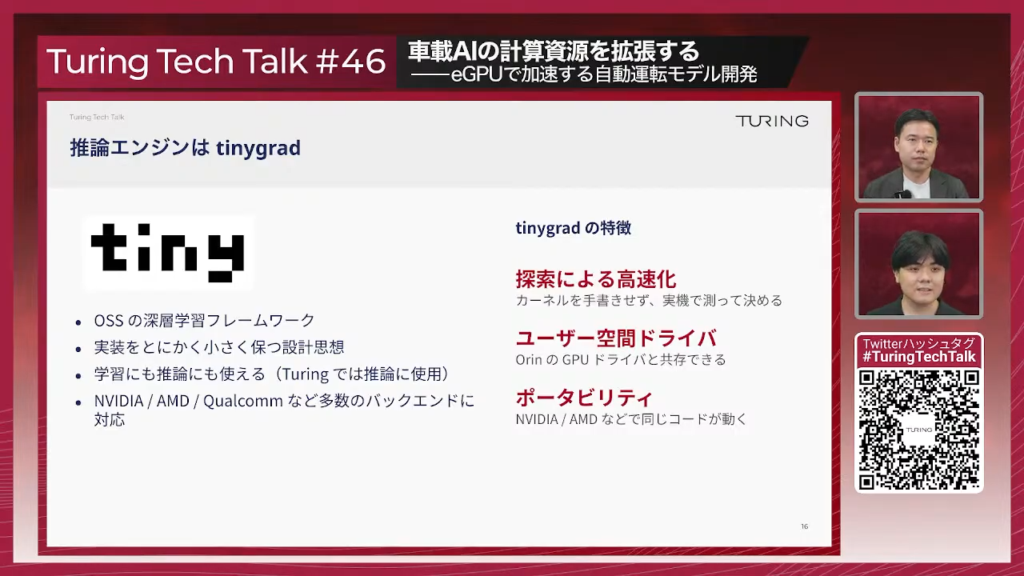
猪狩:このモデルの推論には、tinygrad(OSSの深層学習フレームワーク)というソフトウェアを採用しています。
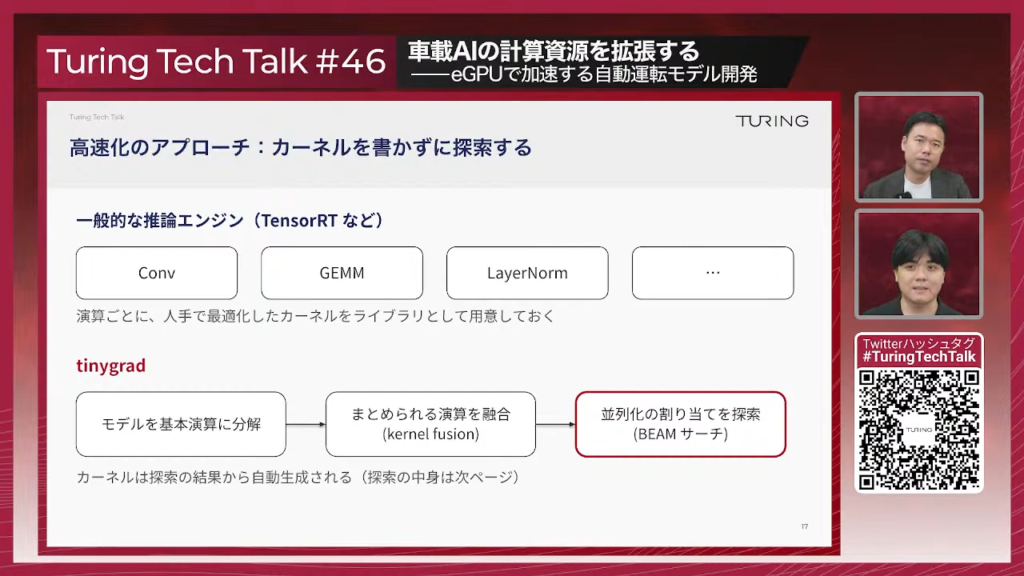
猪狩:大体一般的な推論エンジンは、モデルの各層の各演算に対してこういうCUDAのカーネルを対応させて速く動かす形になっているものが多いんですけども、このtinygradは、基本的に速い計算の仕方を探索するというアプローチをとっています。モデルをもうちょっと最初に足し算や行列積など本当にそれぐらいの単位に一度分解してから、まとめられる演算をまとめていきます。一つの演算単位について速い計算の仕方を探索する、というアプローチになっています。この探索に使われているアルゴリズムが、BEAMサーチ(有望な候補を一定数ずつ残しながら探索を進める手法)と呼ばれるものです。
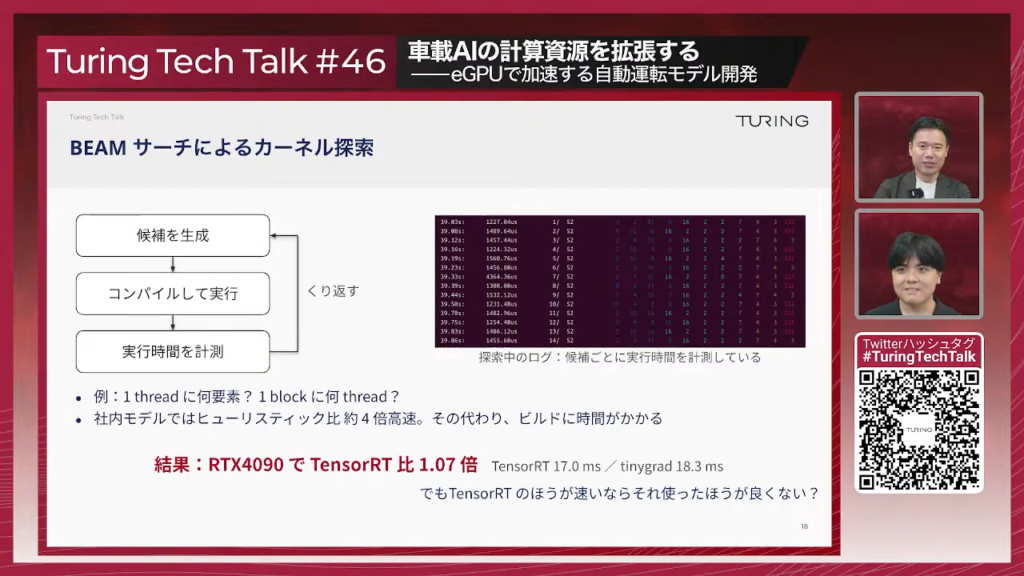
猪狩:NVIDIAのGPUで推論するのであれば、TensorRT(NVIDIAの推論最適化ライブラリ)などを使うと高速にある程度モデルを実行することはできるんですけども。それと比べても遜色ないような速度が、我々が使っているモデルに関して言えば出るというところが確かめられています。
山口:ビルドの時間がめっちゃかかりそうなイメージがあるんですけど、実際どうですか。
猪狩:実際めっちゃかかります。TensorRTでも今使っているモデルで、最適化のオプションなどにもよるんですけども、普段運用しているものだと10分から20分ぐらいはかかります。これもtinygradで同じことをやると、結構1時間、2時間ぐらい。2時間あれば一応大体終わるかなという感じになっています。
山口:探索しているときは、やっぱりCPUも使ったりするんですか。
猪狩:というか、CPUが基本的にもう一番ボトルネックというかですね。探索したものに対して全部コンパイルしているので。
山口:そうなると、結構CPUリッチな環境じゃないとビルドするのも大変だけど、でもこれはエッジでビルドしないと多分ダメですよね。
猪狩:これに関しては今あんまり調べきれていないので、そうなっているんですけども。一応技術的には当然使っているGPUが同じなので、例えばCPUリッチなデスクトップの環境でビルドしてそのままエッジに持ち込むようなことも一応技術的には可能です。ただまだ運用はできないんですけども、そういうのもいずれできるようにしたいなというのはありますね。
山口:4090の1.07倍、これは時間が1.07倍だから、ちょっと遅いということです。「TensorRTの方が速いならそれを使った方が良くない?」とめっちゃ思ったんですけど、何で使わないんですか。
ユーザー空間ドライバとポータビリティ ─ Orinを活かしたままeGPUを動かす
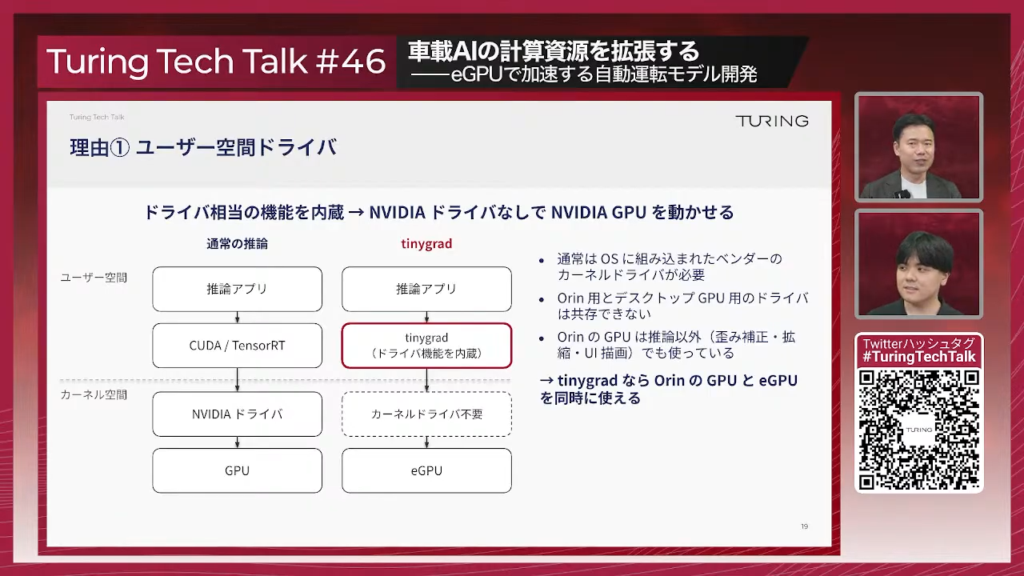
猪狩:使わないんじゃなくて、結構そもそも使えないという話があるんですよね。これがtinygradを採用する現状一番大きい理由なんですけども。tinygradはユーザー空間ドライバー(OSのカーネルではなくアプリケーション側で動くドライバ機能)で動作するというところがあります。普通にTensorRTなどを使うと、大体あらゆるものをNVIDIAのスタックに乗っかる必要があって、要はNVIDIAドライバーを環境にインストールすることが当然前提になるわけです。
もしこの構成で計算機にeGPUを載せることを考えたら、eGPUのGPUのドライバをインストールしなければいけないことになってしまう。ただそもそも今の計算機にはJetson Orinが載っていて、当然そのJetson Orinのドライバがいる状態になっているんですよね。Jetson Orinのドライバーを活かしつつ、さらに新しいドライバーを入れるのがどうしてもできないという事情があって。この構成でTensorRTを使って推論ソフトウェアを書くことはできませんでした。
でもtinygradはドライバーがやる機能に相当するものをtinygrad自身のソフトウェアが持っているので、ドライバーをインストールしなくても動くというところがすごい特徴になっています。それで車載計算機についているOrinを活かしつつ、さらにeGPUの推論が動かせる。現実的にそれができる構成になっていたので、これを採用したという背景がありました。
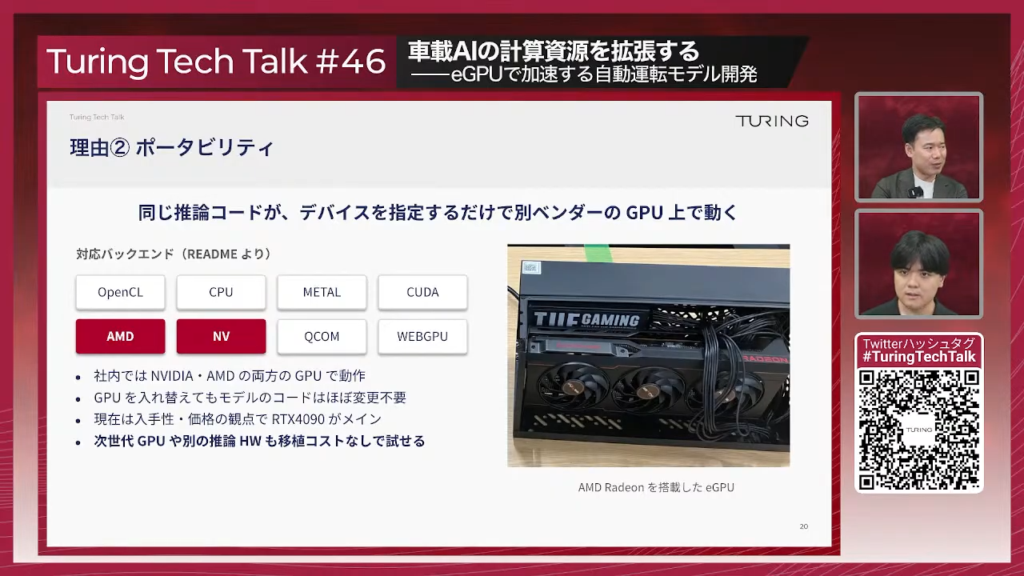
猪狩:あともう一つ、特徴的で採用するに至っていいなと思っているところがあって。それはポータビリティのところにもあるかなと。これは結構さっきの探索による最適化に全部振っているところとも絡んでくるんですけども、要は基本的に「どうせこのハードウェアだからこのカーネルが速い」ということをやっていない。そのため、例えばNVIDIAのGPUのほかにAMDのGPUなどを使ったとしても、ハードウェアに合わせた最適化ができるので、いろんなハードウェアで動かすことができるようになっているのが大きいです。単純に推論する環境として提供するんだったらNVIDIAでいいじゃないか、というのはもちろんあるんですけども。我々のチームとしていろいろな推論ハードウェアの探索をしていきたいとなったときに、探索的にいろいろ使える余地もあるので、結構便利かなというところはあります。
本当にこうやって物理的に物を差し替えるだけで、そちらの部分はほぼ変更を入れずに動かすことができるので、とりあえず動かす環境としてだいぶいいかなと思いますね。
今後の展望 ─ VLMや大きな基盤モデルも実車で試したい
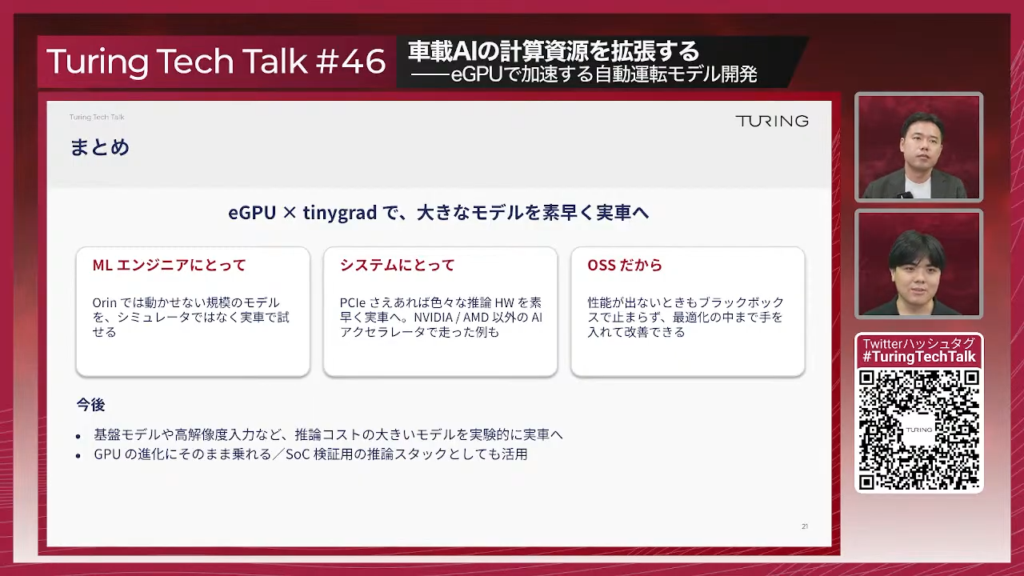
猪狩:結構このシステムは、いろいろな人にとって面白いかなと思っていて。当然MLエンジニアにとっては、大きいモデルを素早く試せる環境になっているかなと思います。一方で我々のように高速化などをする人にとっても、いろいろなハードで試せたり高速化のアルゴリズムの中身をOSSなので見ることができたりする。これで今後もっと、それこそVLM(Vision-Language Model)だったり、大きい基盤モデルのようなものだったり。そういうものをこういう環境で実車で動かしてみたりというのは、やっていけたらいいなと思っています。
山口:ちなみに動かそうと思うと、どのくらいのパラメータサイズのモデルまで動かせるものなんですか。
猪狩:動かすというのは、要はその推論を10Hzで動かしたいかというところにもよります。
山口:とりあえず動かす、という意味です。そういう意味で、どのくらいのモデルサイズまでいけるのかなというのは個人的には気になりますね。
猪狩:これはもう使うGPUのメモリのサイズによるかなと。使うGPUのメモリに入るなら使える、というところになってくるかなと思います。例えば4090だったら24GBですし、5090だったら32GBのVRAMに入るサイズのものだったら動くことになります。例えばInt8で量子化したモデルを動かすんだったら、1パラメータが1バイトなので、32GBぐらいが動かせるというところになってくるかなと思います。
山口:なので5090などをeGPUでつけると、いわゆる30BぐらいのLLMやVLMだったら、結構この環境でおそらく動くだろうという想像もあるということですね。
猪狩:これはでもまさに今も試している部分もあったりしていて、結構気になるところではありますね。
チューリングでは、完全自動運転の技術を共に創る仲間を募集しています。今日お話ししたDriving System3チームはもちろんのこと、非常に幅広いエンジニア職種で仲間を募集しています。職種は、機械学習エンジニア・リサーチャー・ソフトウェアエンジニア・組み込みエンジニア・インフラエンジニアなどです。ご興味のある方は、ぜひ採用ページをご確認ください。多様な職種がありますので、ご自身がどれに当てはまるか、ぜひチェックしてみてください。


