


 役員SNS

Turing TechTalk#45 Databricksで加速するAI開発基盤 ─ MLOps基盤とデータセット作成パイプライン
はじめに
自動運転AIの性能は、モデルだけでなく、どのようなデータで学習するかに大きく左右されます。チューリングは走行時間にして数万時間、動画だけで数ペタバイトのデータを自社の車両で収集しており、そこから学習用データセットを素早く再現性高く作り続けられるかが、E2E自動運転モデルの改善速度を決めます。今回はこの「データセットを作る」部分に絞り、Databricks Serverless、DAB、MosaicML Streamingを組み合わせた設計と運用に迫ります。
今回のTech Talkでは、CTOの山口と、MLOps1チームでマネージャーを務める岩政が登壇。Serverlessの制約と対処、開発環境と本番環境の分離、ゴールデンデータによる回帰テスト、壊れにくいパイプライン設計、半年で139回のリリースと3,906件のデータセットに至った実績を語りました。
※本記事は「Turing Tech Talk #45」の内容をもとに、一部編集のうえお届けします。
MLエンジニアからMLOpsへ
山口:今日はMLOps1チームのマネージャーの岩政公平さんに来てもらっています。前回出てもらったのは確か第18回で、E2E自動運転のモデル開発の話をMLエンジニアとして話してもらいました。簡単に自己紹介をお願いします。
岩政:岩政公平と申します。チューリングに関わり始めたのは4年前ぐらい、当時は九州大学の大学院にいました。入社は2023年4月です。最初から「E2E自動運転を作るぞ」という気持ちでやっていたんですけど、そのためにはデータ基盤や学習基盤、GPUクラスターが必要で、最初からデータ基盤回りを見てきました。
山口:今回のテーマは「加速のカギはDatabricks」と銘打っていて、企業案件みたいですけど、お金をもらっているわけじゃないですよね。
岩政:むしろ僕らが払っているという(笑)。
データパイプラインの全体像と、「ガルーダ」v2の前提
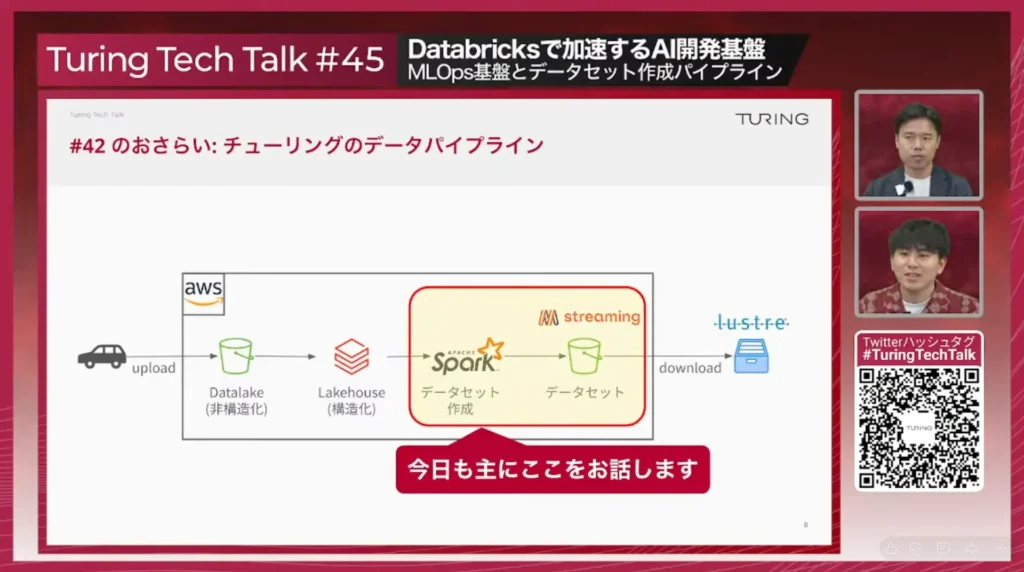
岩政:今日の内容は「Databricksを活用して堅牢なデータセット作成パイプラインを組むには」です。テックブログ(Zenn)で公開した記事が主な内容で、第42回で安本さんが話した「ペタバイト級データセットの作り方」を詳しく話す回になります。車両のデータをS3にアップロードしてもらい、Databricksで加工して学習用データセットを作り、各GPUクラスターに配布する。今回はこの「データセット作成」をどう堅牢に作るかという話です。
山口:綺麗なテーブルが車からポンと出てくるわけではなくて、バラバラな形式のものを整えて、レイクハウスで標準化されたテーブルになる。今日の話はその後、どうスケールさせるかですね。
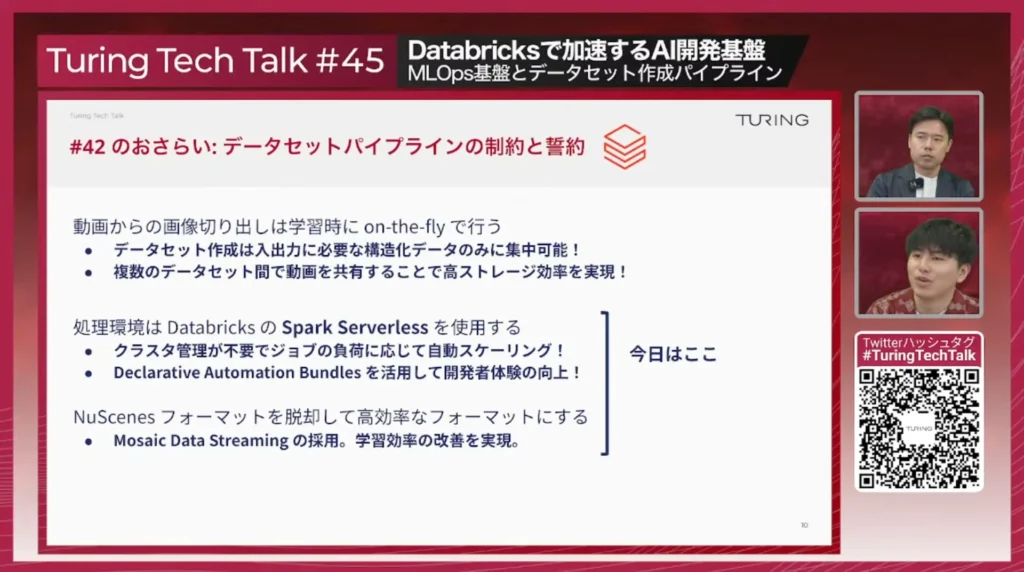
岩政:僕らはコードネームを「GARUDA」と呼ぶデータセットを作っていて、以前のパイプラインをよりよく作り直そうということで今回のプロジェクトが始まりました。データの大部分は動画で、以前は画像を切り出すのにもクラウド側のリソースが必要でしたが、それを「学習時に行いましょう」としました。この仮定を置くとデータセット作成がかなりシンプルになる。処理環境はクラスター管理が不要なDatabricksのSpark Serverless。かつDeclarative Automation Bundlesで、ジョブやパイプライン、CI/CD(継続的インテグレーション/デリバリー)をコードで管理できる。最後にMosaicMLのMosaic Data Streamingを採用し、学習効率のいいフォーマットにできました。
山口:つまりGARUDAは、いわゆるバージョン2として用意したものだということで合っていますか。
岩政:そうですね。バージョン2です。
Databricksのいいところは、Sparkという分散処理エンジンを完全にマネージドなサービスとして出しているので、ホスティングを考えずに、どうやって処理するかだけに集中できることです。
Databricks Serverlessを選んだ理由と、その落とし穴
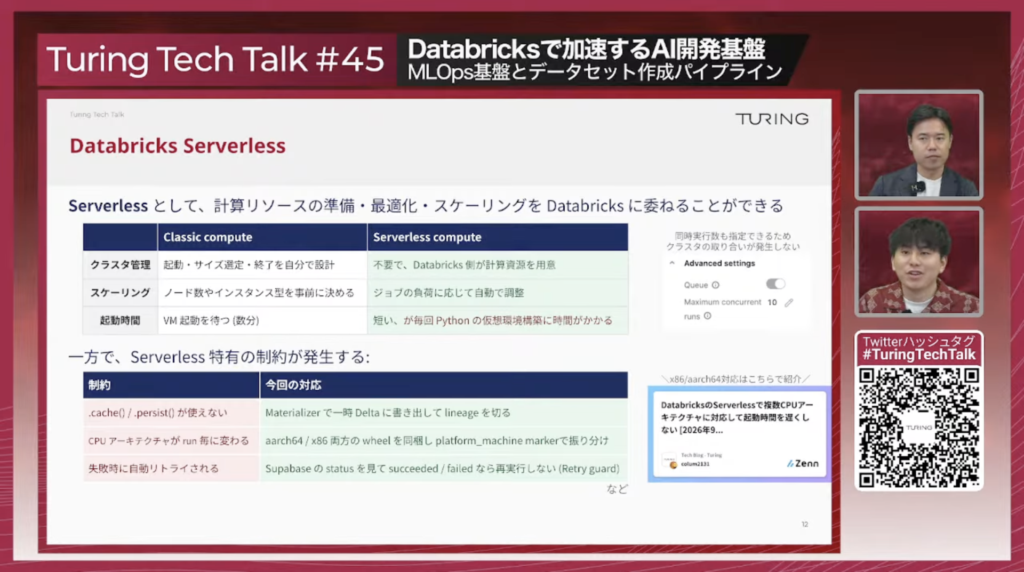
岩政:Databricksにはクラシックとサーバーレスの2つのコンピュートがあります。サーバーレスを選んだ理由は、数千時間分を一気に作りたいユーザーもいれば、評価用に1時間もないデータを作りたいユーザーもいて、1個あたりのサイズが大きく違うからです。同時実行数も指定できるので、一気に処理したい要望にも応えられる。起動時間を短縮できるのも嬉しいポイントです。
一方でサーバーレスには制約もあって、例えばPySparkで「.cache」を叩くと中間結果をマテリアライズしてくれるんですけど、それが使えない。Sparkはチェーン評価でデータフレームを作るので、何回か呼び出される深いものだと毎回作り直しになり、処理が増えるほどCPUやRAMが足りなくなります。Databricks側からサーバーレス用のキャッシュ機能は提供されていないので独自に作りました。一時的にDelta(Delta Lake)へ保存して計算グラフ(lineage)を一度切り、中間結果も裏側ではS3にあるので、そこから毎回読む形で対応しました。
あとは9月4日のアップデートでCPUアーキテクチャにaarch64も登場し、確率的に変わってしまう問題がありました。これはどうにかなったので、ぜひテックブログを読んでください。最初に作るときは大変で、「クラシックコンピュートだったらこんな思いしなくていいのに」という気持ちでやっていました。
山口:ご質問をいただいています。「pipelineの本番運用でも、サーバレスを使用するのでしょうか。コストが爆発したりしませんでしょうか…?」
岩政:データセットを作るところもそうですし、データパイプラインもサーバーレスで実行しています。そちらで爆発することはあまりなかったんですけど、過剰なシーン数を指定したり、バグで計算がループしたりしてコストが跳ね上がることはありました。なのでタイムアウトをしっかりやることと、Sparkのクエリのログを取って無駄を削ること。あとはコストをほぼ毎日監視しています。
山口:コストは爆発する可能性はあるけど、これまでは爆発していない、と。
Goldの外に置いた、データセット作成ジョブ
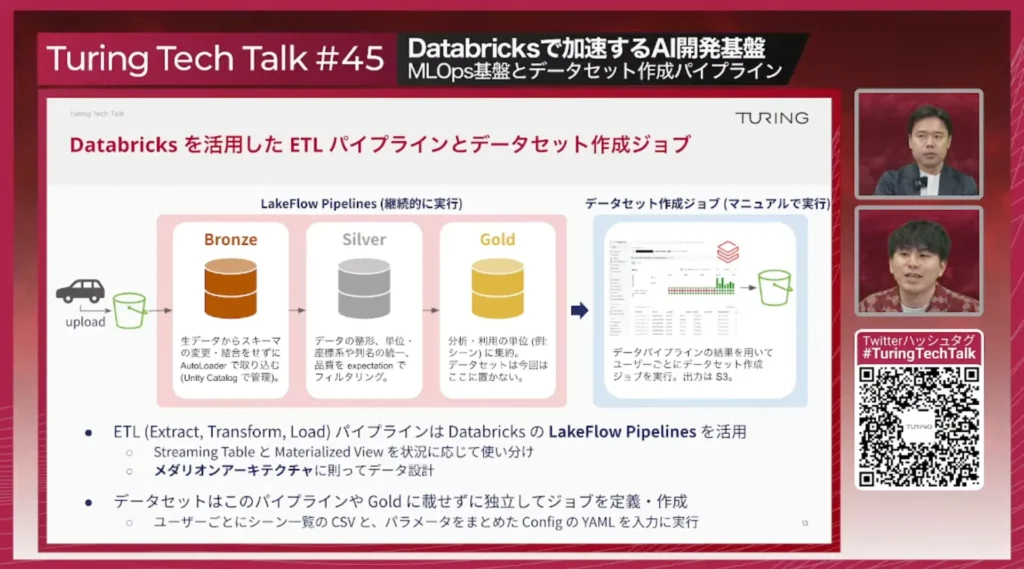
岩政:車から上がったデータは、まずETL(Extract, Transform, Load)のパイプラインで処理されます。DatabricksのLakeflow Pipelinesで、メダリオンアーキテクチャのBronze・Silver・Goldですね。Bronzeは生データを何も処理せず構造化データに変換して置く。Silverで整形し、単位や座標系、列名を統一したり品質をフィルタリングする。最終的にGoldとして分析や利用の単位で集約します。社内では収集データを「シーン」という単位で区切っているので、ここで明示的にシーンを作ります。今回話すデータセット作成ジョブは、そこで得られたUnity Catalog上のテーブルを使って別個に生やし、マニュアルで実行します。
山口:やり方はいろいろあると思うんですけど、例えばGold自体にデータセットを置くユーザーさんも多いと思います。そっちの方が直感的な気がしますね。
岩政:むしろそっちの方が継続的に処理できますし、個別に生やした分、同じ処理を複数回やってコストが余分にかかる見方もできます。ただ自動運転用のデータセットだと、入出力データの計算処理やスキーマをコロコロ変えられる柔軟性が欲しい。Lakeflow Pipelinesに乗せずに個別に作るようになりました。
山口:研究開発のスピードが速いので、柔軟に対応するために一応2段階に分けているということですね。分量で言うとどれくらいですか?
岩政:時間で言えば数万時間単位で全て管理しています。
山口:動画データだけでも数ペタバイトいきますし、メタデータやセンサーデータもたくさんあって、統合すると巨大なデータになりますよね。
岩政:Databricks以前はメダリオンアーキテクチャみたいな考え方や、柔軟に管理するシステムを組んでいなかったので、対応の難しさがありましたね。
DABで、ジョブも環境もすべてコードで管理する
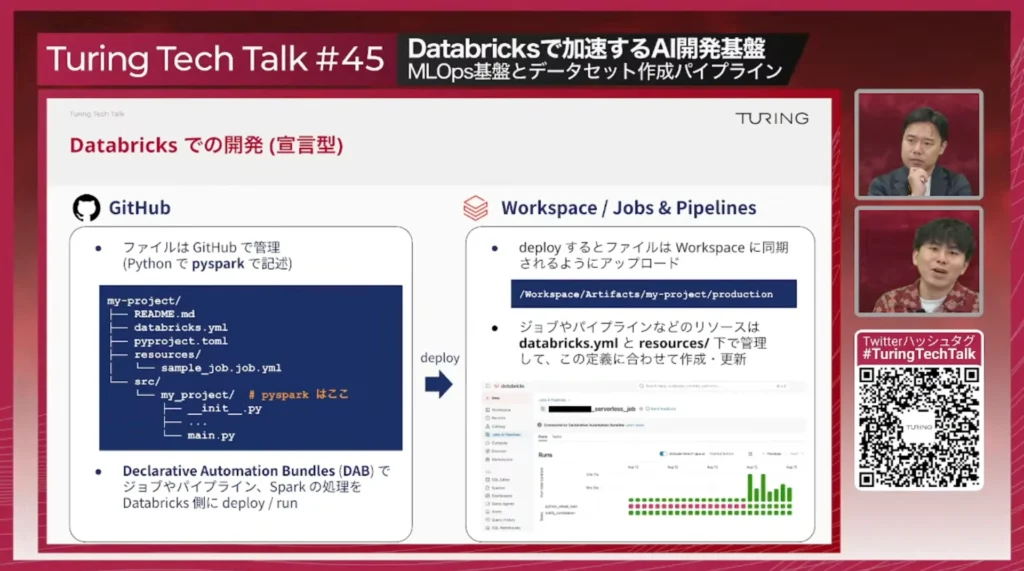
岩政:Databricksの最新の開発スタイルとして、宣言型のDAB(Declarative Automation Bundles)でコード管理をしていて、僕らは基本的にPython/PySparkで記述しています。ジョブやパイプライン、Sparkの処理、Databricksへのデプロイや実行まで全てコードとCI/CDで完結するので、今のAI時代にかなり合っています。
山口:YAMLで設定やパイプラインのフローを定義できる。インフラでいうとTerraformのようなIaC(Infrastructure as Code)のワークフロー版、みたいな感じですかね。
岩政:正しいです。それです。
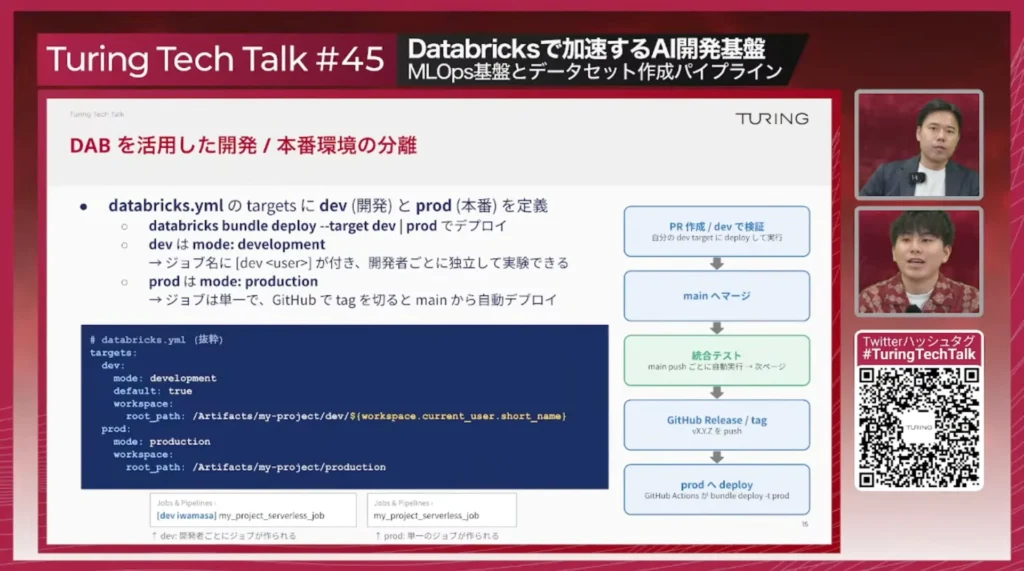
岩政:DABを使うと開発環境と本番環境の分離が簡単になります。databricks.ymlのtargetsにdevとprodを分け、それぞれにデプロイできる。devのmodeをdevelopmentにするとジョブが個人ごとに作られ、独立して実験できます。prodはユーザーから触れないようにしていて、PRを作成してdevで検証、mainにマージ、インテグレーションテストを行い、GitHubタグが切られるとprodにデプロイされる、という流れで回っています。
山口:この辺りの話はモダンな開発スタイルを踏襲していてすごくいいですね。
岩政:DABの良さが一番詰まっている部分です。devで見せるデータの範囲も定義できて、今回は全テーブルを参照できるようにしているので、開発環境で本番相当のデータを見ながら作れます。社内には本番反映をスキップして、dev環境で作ったデータセットをそのまま学習に使う「いい意味での抜け道」を使うエンジニアもいます。コミットハッシュが残るので、後から過去のバージョンに戻って再実行できます。
山口:devで脱法的にフローをやるのは、岩政さんのようなプラットフォームを開発しているチームではなくユーザー側ということですね。今、実際に触っているメンバーは20人はいない?
岩政:いや、後で話そうと思うんですけど、触っているのは40人ぐらいいるんですよね。
山口:そんなにいるんですね。エンジニアは50人ぐらいなんですけど、8割ぐらいは実はこの機能を使っている。私も使っています。
岩政:うち20人ぐらいはリリースをやったことがあります。MLOpsだけで管理するのではなく、MLエンジニアや他のユーザーからも機能を追加できるシステムです。
ゴールデンデータで回帰テストをする
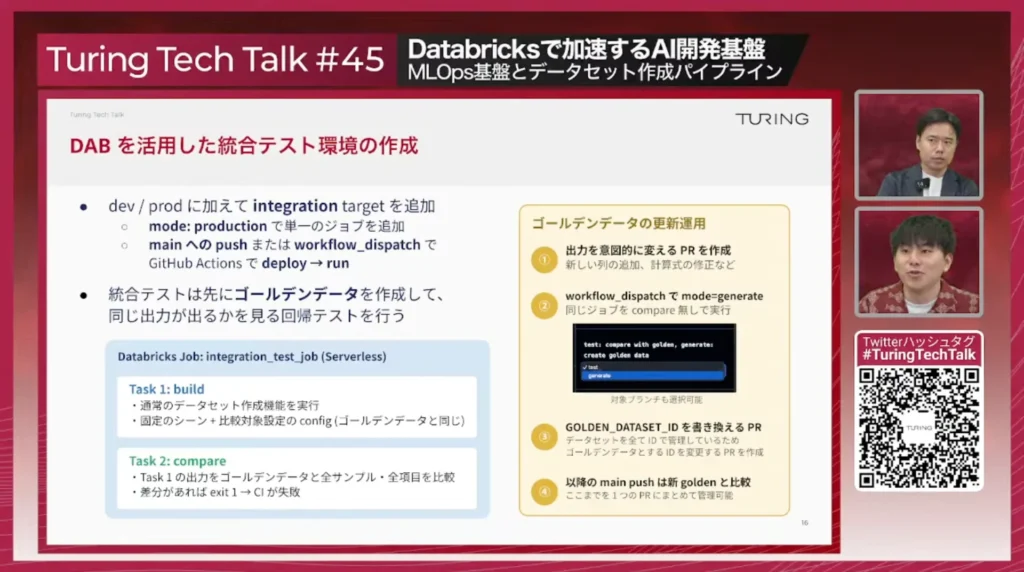
岩政:新しい機能が壊れずに動くか、値が変わっていないかを見る統合テストも、integrationというターゲットを足せば簡単に作れます。僕らはシンプルに、「これが正解です」というゴールデンデータを作っておいて、同じ出力になるかの回帰テストを行う。固定のシーンと同じコンフィグでビルドし、結果を全件比較して差分があればCIが失敗する。意図して出力を変える人もいるので、generateというモードで生成し直し、登録しているIDを差し替えれば新しいゴールデンデータで比較できます。
山口:正解となるデータセットを一個用意しておいて、このご本尊がちゃんと生成されることを毎回通しで見ている。ゴールデンデータはいっぱいあるんですか。
岩政:基本的には1個ですね。mainに追従する形で設定しています。
PipelineStep──直列に並べるだけの設計
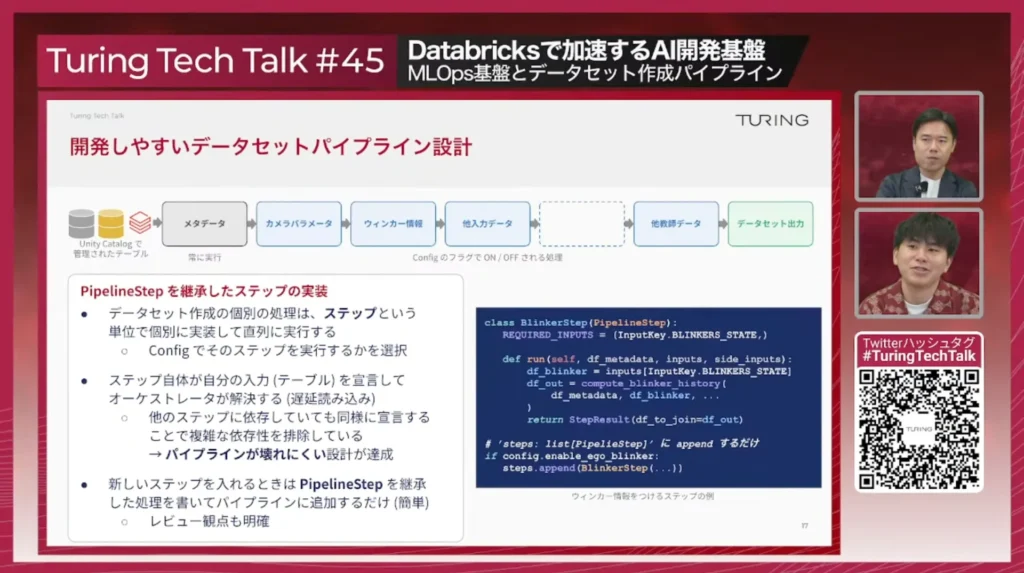
岩政:ここから先はDatabricksはあまり関係なくて、Pythonのアーキテクチャの話です。作りたいデータはユーザーによって異なります。「カメラのパラメータが欲しい」「誰が運転していたかが欲しい」といった入力データもあれば、教師データも「俺は20秒先のデータが欲しい」「いや俺は3秒まででいい」と変わる。そこで一つの出力パターンを処理する単位を「ステップ」と定め、「PipelineStep」という抽象クラスを直列に並べる形にしました。
BlinkerStepはウインカー情報をつけるステップの例で、REQUIRED_INPUTSというクラス変数で必要な入力テーブルを宣言します。これをオーケストレーターが見て遅延的に読み込む。あとは必ず作られるメタデータを受け取り、Sparkで処理して、StepResultというデータクラスで返す。このワンセットを配列に入れると直列に処理されます。
山口:DAG(有向非巡回グラフ)がややこしくなると、どれをどの順番でやるか、べき等かどうかとか、気にしなきゃいけない話が増える。直列に処理していけば、あんまりややこしいことは考えなくていい。ちなみに、ステップを入れたり外したりユーザーが選択できると言っていましたけど、それもYAMLで宣言的に書くんですか。
岩政:そういうことです。他のステップに依存する処理も宣言してもらうことで関係が明確になり、侵襲的にならない。こういう書き方だとレビュー観点が明確になる。以前だったら「この処理は内部で何をやっているかよく分からんが、他の処理は壊していないから通ってよし」みたいな、現場猫スタイルのレビューが一応できた。速度を出す、と言うと「安全ではないのでは」と取られそうですが、このサービスは社内に閉じていますし、安全検証は別のところでちゃんとできます。
学習側のフォーマット、MosaicML Streaming
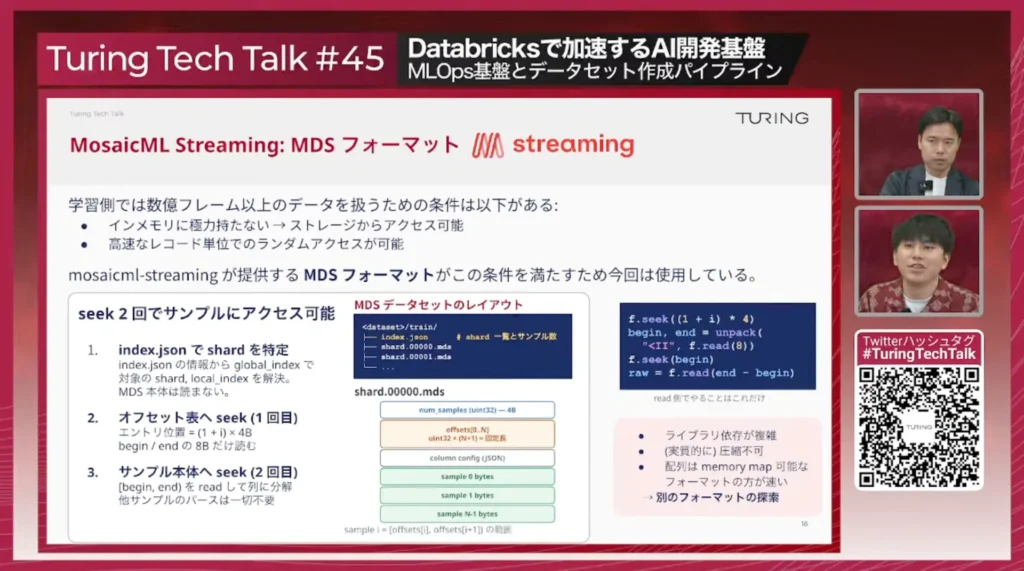
岩政:出力フォーマットにはMosaicML StreamingのMDSを使っています。学習側では数億フレーム、数億サンプル以上のデータを扱っていて、普通のPyTorchのデータセットのようにインメモリに持たせられない。高速なレコード単位のランダムアクセスができ、かつ細かく分割しすぎても別の問題になるので、ある程度固めたフォーマットが必要で、MDSがこの条件に合う。グローバルなインデックスからindex.jsonで対象のシャードとローカルインデックスを解決し、シャード先頭のオフセット表を読んでもう一度シークする。seek 2回で読み出せるシンプルなフォーマットです。
山口:MDS自体には動画は入っていなくて、パイプライン処理されたテーブルデータ、グラウンドトゥルースやメタデータが格納されていて、それが動画と紐付いて学習に使われるということですね。機械学習はランダムアクセスをするので、ストレージにめっちゃ負荷がかかりそうな気がするんですけど。
岩政:かかると思います。かかるんですけど、そこはまた別の機会にお話ししましょう。僕があまりそこまで踏み込んでいなくて。
山口:単純に速いストレージを使うのが解決策の一つですね。DDNのLustreのような、ランダムアクセスに強い分散ファイルシステムを使っているので耐えている。MDSもそういう前提で設計されているのかな、と聞いていて思いました。
岩政:多分それですね。次回からそう答えられるよう練習しておきます(笑)。課題もあって、ライブラリの依存が複雑で開発も止まっているので、早めに脱却しようかなと思っています。次に目指すのは圧縮可能であること。あと配列データだと、memory map可能なフォーマットの方が明らかに速いんですよね。なので別のフォーマットを探索していこうと社内で話しています。
リリースから半年──139回のリリースと3,906件のデータセット
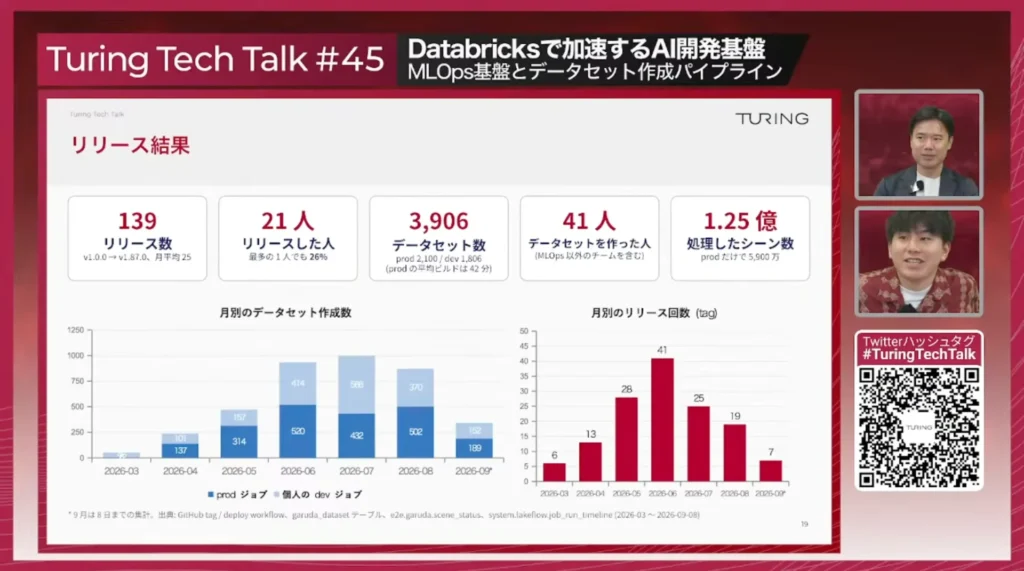
岩政:これでようやくリリースができました。ここまで長く苦しい戦いでしたね。
山口:おめでとうございます。ちなみに、いつ頃リリースしたんですか。
岩政:メジャーバージョンの1.0.0が多分3月20何日で、ようやく半年ぐらいのシステムです。構想は前からあったんですけど、動画からの切り出しが一番大変な部分で、そこが排除できたので「作りましょう」となったのが今年の1月ぐらい。そこから3ヶ月、主に自分とグループリーダーの安本さんの2人でやりました。
山口:結構複雑なシステムですけれども、2人だけで作ったということですね。
岩政:意外といけちゃいましたね。
山口:確か5月ぐらいに、一個前のバージョン1から切り替えたんですよね。
岩政:そうです。6月に跳ねているのはそれで、もともとのデータセットを5月に全部なくそうという全社的な判断で移行しました。
山口:かなり出来が良かったので、「5月末までにみんな移行してください」と大号令を出して無理やり移行して、うまくいった印象でした。
岩政:なんだかんだ、いい感じにいきました。リリース数は新しいパイプラインステップを追加した数だと思ってもらえばよくて、今日までで139回。コンフィグのパラメータが追加されるとマイナーバージョンが上がるバージョニングで、今87まできました。
山口:つまり新しいコンフィグの機能が87個追加されているということですね。後方互換性は気にしていたりするんですか。
岩政:基本的には気にしない場合が多いですね。過去のバージョンに戻って作り直せるので。次に、新しくパイプラインステップを作った人が21人。エンジニア大体50人のうち40%がコントリビューターになっているという嬉しい話です。僕が一番でも26%なので、かなり分散して作られています。データセット数は今日見たら3,906件。1個あたり大体1,000時間で、1万時間クラスはまだ分割しないと作れない課題はあります。
山口:リリースされてまだ数ヶ月で、月500件以上作られているのは驚異的ですね。
岩政:MLエンジニアがめっちゃたくさん作ってくれているなと。
山口:逆に言うと、それだけどんどん作れるぐらい使いやすいということですね。
岩政:1件あたりの平均ビルドは42分で、今は1,000時間ぐらいを1時間程度で作れます。データセットを作った人は41人で8割ぐらい。MLOps以外のチームも使っています。最後が処理したシーン数で、あまり意味はないんですけど1.25億シーン。次に目指すは10億シーンです。
山口:ちなみに1シーンというのは何秒に相当するんですか。
岩政:1シーンは、今は20秒です。
山口:20秒×1.25億をこのパイプラインで処理しているということですね。1日かかっていたらこんなに作れないので、Sparkで分散して高速に作れる設計思想がはまっている。本当にSpark様様です。
壊れない枠と、壊せる中身
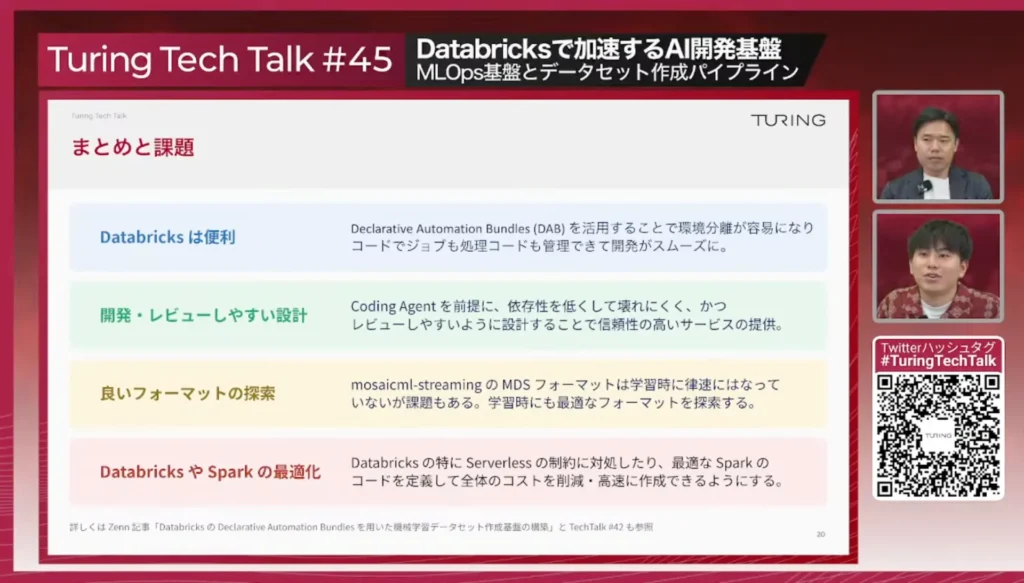
岩政:まとめると、Databricksはかなり便利なサービスで、データの管理も、データセットを高速に作るところもよくできています。開発・レビューしやすい設計にできたので、このスピードでどんどんリリースができた。コーディングエージェントの世界ですけど、逆に一般的なソフトウェアエンジニアリングの知識は一定取り入れるといい、という当たり前の話ですね。今後の課題はいいフォーマットの探索と、DatabricksとSparkの最適化。ここは苦戦しました。僕はpandasやPolarsが大好きなんですけど、Sparkは違う書き方をしないといけない。DAGをいかに浅くするか、ソートやシャッフルをいかに減らすか、ブロードキャストジョインや、機能にないas-of joinのような処理を独自で書いたり。世に情報が出ていないので、僕もTipsを出していきたいです。
山口:MLの知識がある上でMLOpsをやる、というところの岩政さんなりの関係性はどういう感じですか。思想とかアプローチとか、違うところはあります?
岩政:思想で言えば、「壊しやすさ」は一定あると思っていて。今回作ったパイプラインのフレームワーク自体は絶対壊さない、ソフトとして堅牢に作る。でも内部のモジュール、今回だとパイプラインステップは、ユーザーが自由にいじれて、本番に簡単にデプロイしてすぐ検証できるようにする。検証・実験サイクルをいかに速く回すかに注目して作れたのが、MLエンジニアならではの思想かなと思います。
山口:最後のご質問です。「データ基盤としてはかなりリリース頻度が高い印象ですが、CI/CDや回帰テストが整備されているからこそ実現できている、という理解で合っていますでしょうか」
岩政:まさしくそうだと思います。特定の人に属人化していないのが僕的にはいいところで、誰でもリリースできる仕組みにしているのが、この頻度でリリースできている理由かなと。品質管理は、機械的に検知できるものはなるべく機械的に検知する。回帰テストも、みんなが使う新しいパイプラインステップができたら優先して入れますし、特定のシーンでしかバグを踏まないものなら、そのシーンをテストに追加する。
山口:もしチームにこういう人がいたらいいな、という人はどういう人ですか。
岩政:ふわっとした回答になりますが、MLOpsは「データ基盤を整備すればいい」では収まらないですね。最終的な目標は自動運転の性能を上げることで、そのためにAIの外側をいかに整備できるかが課題なので、そこを全体で見て最適化できる人が一番来てほしい。データセットを作る人間で終わらず、自動運転の開発を高速にするところを見て、新しい課題を見つけて取り組んでくれる人が来てほしいなと思います。
山口:自動運転AIをいかに良くするかという課題に向き合って、一番良いアプローチを選択できる経験があるとすごく良いということですね。
Q&A一覧(一部抜粋)
以降は視聴者のQ&Aに回答していきました。詳しくは動画をご覧ください。
- 図ではDatabricksのLakehouseとApache Sparkによるデータセット作成が分けて表現されていますが、実際にはDatabricks上でSparkを使ってデータ処理するケースが多いと思います。この2つをあえて分けて表現されているのは、何か意図があるのでしょうか?
- pipelineの本番運用でも、サーバレスを使用するのでしょうか。コストが爆発したりしませんでしょうか…?
- パイプラインには、キャッシュを設けてますか?大規模データの場合、どこかにキャッシュをつくりたくなるのかと想像しました。
- Serverlessではcacheやpersistが使えないとのことでしたが、再利用頻度の高い中間データについては、基本的にDeltaへmaterializeする方針なのでしょうか?
- データ基盤としてはかなりリリース頻度が高い印象ですが、CI/CDや回帰テストが整備されているからこそ実現できている、という理解で合っていますでしょうか。また、そのほかに特に重視されている品質管理の仕組みがあれば、教えていただけますか?
チューリングでは、完全自動運転の技術を共に創る仲間を募集しています。今日お話ししたMLOps1チームはもちろんのこと、機械学習エンジニア、リサーチャー、ソフトウェアエンジニア、組み込みエンジニア、インフラエンジニア、ドライバー、メカニックなど、非常に幅広いエンジニア職種で仲間を募集しています。ご興味のある方は、ぜひ採用ページをご確認ください。多様な職種がありますので、ご自身がどれに当てはまるか、ぜひチェックしてみてください。


