本文へ移動

Turing TechTalk#46 車載AIの計算資源を拡張する ─ eGPUで加速する自動運転モデル開発

この記事に登場する人
CTO
山口 祐 Yu Yamaguchi
産業技術総合研究所 研究員/米国NIST客員研究員として研究する傍ら、独自にゲームAIの深層学習の開発を開始。日本の囲碁AIプロジェクトの開発代表として、最大1100GPUの並列分散強化学習を設計・開発し、世界大会準優勝、将棋AIでも世界大会優勝などの実績がある。HEROZ株式会社 執行役員を経て、2022年、チューリングに創業メンバーとして参画。2024年8月、CTO就任。基盤AIチームマネージャー兼任。
Driving System3チーム シニアエンジニア
猪狩 恒貴 Koki Igari
大学ではロボコンサークル「RoboTech」に所属し、NHK学生ロボコンで準優勝。2021年にインターンとしてTuringに参画し、2023年に新卒入社。車体制御から自動運転AIまで幅広い領域を経験し、現在は自動運転システムの開発を担当。モデルを実車にデプロイするための基盤構築に取り組み、eGPUシステムの開発や推論ハードウェア向けの高速化などを手がける。

はじめに

チューリングの自動運転AIは、車載計算機の上でリアルタイムに推論しています。その周期は1秒間に10回(10Hz)です。

モデルのパラメータサイズを大きくすれば性能が上がると期待される一方で、既存の車載計算機では10Hzに間に合わないモデルもあります。大きなモデルをいかに早く実車で試せるようにするかが、大きな技術的課題になっています。

今回のTech Talkでは、CTOの山口 祐とDriving System3チームの猪狩 恒貴が登壇。eGPUの構成やOCuLinkによる接続、推論エンジンtinygradによる高速化まで、大きなモデルを実車で動かす車載推論システムを詳しく紹介しました。

※本記事は「Turing Tech Talk #46」の内容をもとに、一部編集のうえお届けします。

四輪ロボットの自律制御から、自動運転へ

山口:本日はDriving System3チームの猪狩さんに来てもらっています。今日のタイトルの計算資源は、どちらかというと学習のために使うというよりも推論、つまり車の中で実際にモデルを予測させる、動かすところでどう最適化するかがテーマです。猪狩さん、簡単に自己紹介のほうをお願いします。

猪狩:Driving System3チームの猪狩 恒貴と申します。大学のときはロボコンのサークルに所属していて、四輪のロボットの自律制御などをやっていました。大学の3年生ぐらいの頃からインターンとしてやっていて、それからずっと自動運転のシステム周りを特に見てきました。最近は自動運転システムの中でも、特にモデルの推論の高速化を結構メインで見ています。

山口:猪狩さんのいるDriving System3チームは、大体何人ぐらいのチームなんでしょうか。

猪狩:今は正社員では3人で、インターンが1人か2人ぐらい。そのぐらいの規模感になっています。

eGPUとは何か ─ 外付けGPUという「第三の選択肢」

山口:このeGPUという単語を知らない人も聞いている人の中には多分結構いるかなと思うので、まずこれについてだけ説明してもらえますか。

猪狩:eGPUというのは、ExternalGPUの略です。普通の使われ方だと、ノートパソコンなどに何かしらのケーブルでGPUをつないでノートPCなどでも強いGPUを使えるようにする技術です。結構安く、それなりのGPUを使った環境を手に入れたいという人向けに使われていたりもします。

山口:eGPUはオンボードのGPUとも、後付けのPCIe(PCI Express:拡張カードの接続規格)のGPUともまた違う第三の選択肢ですね。

猪狩:そうですね。ただ、使われ方としては結構ディスクリートにちょっと近い形です。PCIeなどがなくても、一応ノートPCなどでも動かせる選択肢になっているかなと思います。

山口:割と最近は、このeGPUはそんなに流行っていないですね。商品としても多分昔ほどはブームではないと思っているんですけれども、それが今なぜこの自動運転で使われているのか。ここから先は猪狩さんにバトンタッチして解説をします。

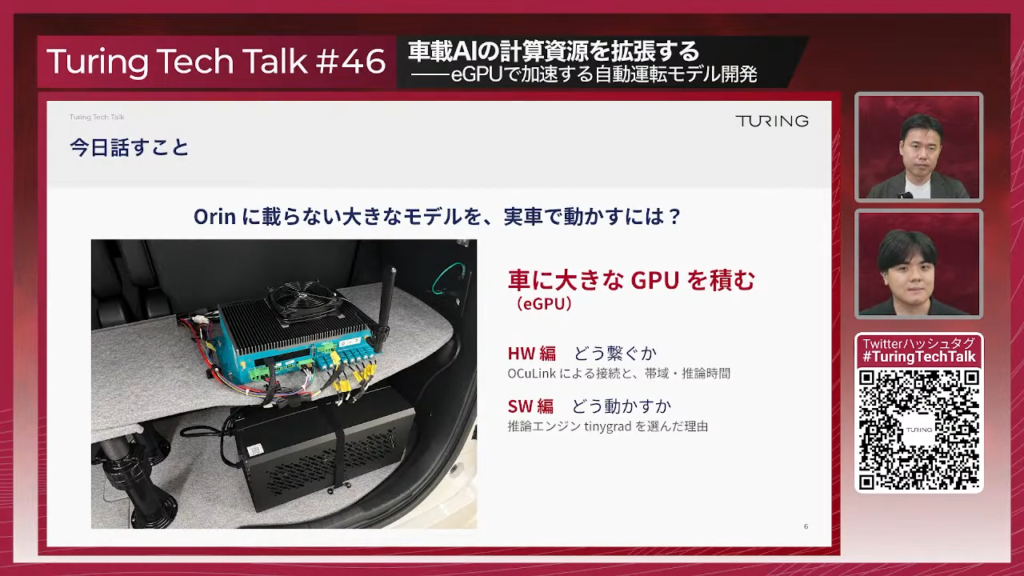
Orinを積んだ既存の車載計算機 ─ 10Hzの制御周期という制約

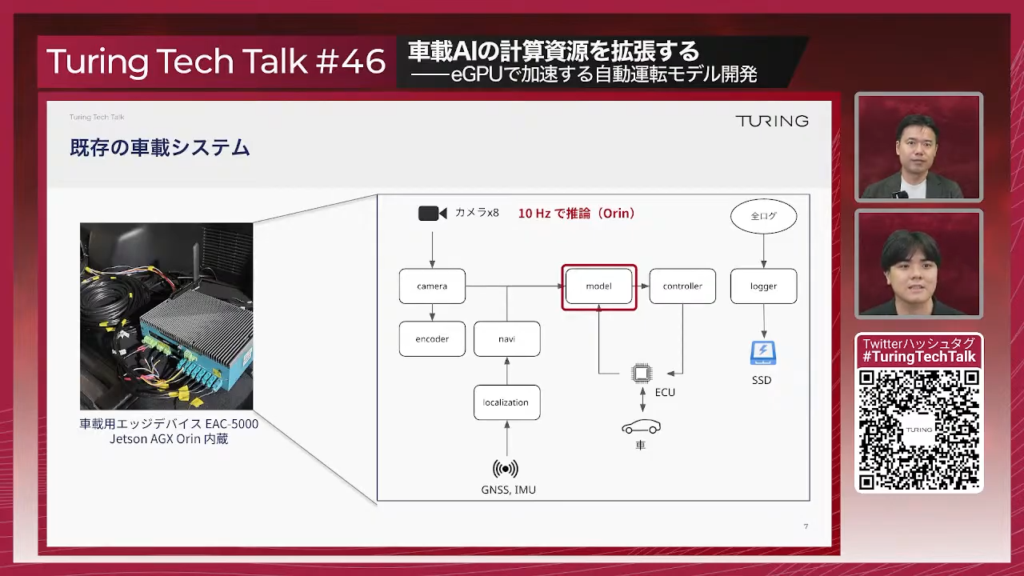
猪狩:eGPUの写真をここに載せています。上段にある水色の箱は普段使っている車載計算機で、これはeGPUとは関係ありません。Orinを積んでいる、通常の自動運転開発で使われる車載計算機です。下の段にある箱が、今回話すeGPUです。上の車載計算機とケーブル1本でつなげて動かすもので、こんな感じで結構コンパクトに車載ができます。ノートPCにeGPUをつなぐとなったときに結構問題として出てくるのは、PCとGPUの間の通信が当然発生するので、ちょっと遅いなというものです。あとソフトウェア的にはドライバーが噛み合わなくて、安定して動かない、そもそもGPUを認識してくれないといった問題が結構あります。それらについて今回の構成ではどうやって対処していったかを話せればと思います。

山口:Orinという単語が出てきましたけど、このOrinというのは何でしょうか。

猪狩:NVIDIAが作っている、組み込み向けのGPUになっています。

猪狩:基本的にはシステム自体は上段にあった水色の計算機ですべて完結するようになっていて、この中ではいろいろなプロセスが走っています。その中で特にモデルを推論させるプロセスが、基本的に今回の話の主題になるかなと思っていて。これがシステム全体の制御周期にちゃんと間に合うように動かなければならないという制約がある中で、どうやって高速化するかという話になっていきます。

山口:基本的にはこの計算機だけで、10Hzでモデルがリアルタイムに動くように今の既存のシステムが作られているということですね。じゃあ、これで作られているんだったらもうこれで十分じゃないかと思っちゃうんですけれども。そういうわけにはいかないですか。

なぜ大きなモデルを実車で動かしたいのか ─ 量子化に頼らず検証する

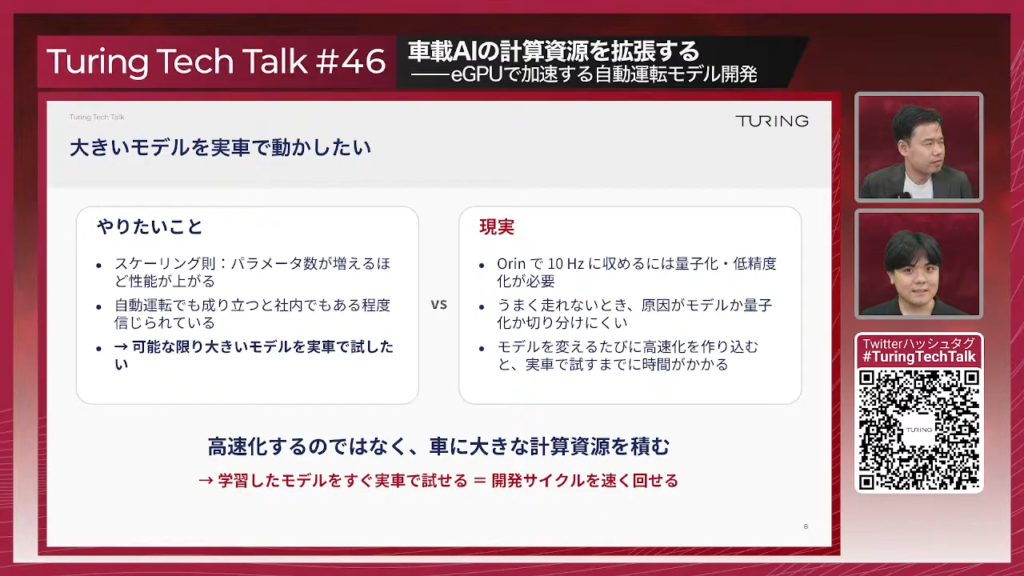
猪狩:結局モデルのパラメータサイズなどを基本的には増やしていくと、性能が上がると期待されます。その中で大きいパラメータのモデルを載せられるものなら載せたいよね、という話があって。やっぱりこのOrinでは全然10Hzに間に合わないようなモデルも動かしたいよ、という要望が社内でもあったりして。それでこういうものを作ることに至っています。

猪狩:やっぱりとにかく大きいモデルを一旦は載せてみたい、という需要があるんです。当然ある程度実際に量産などをする話になったら、載せる計算機のコストなどは限られてくるんだけども。それはそれとして、一回パラメータを増やしたらどれくらい性能が良くなるのかを見たいという需要があります。もちろん、計算機そのものを増やすことに頼らずとも、Orinで頑張って推論させる、アルゴリズムの高速化の方を頑張っていく方向性もあり得るわけです。それこそ速いCUDAカーネル(GPU上で実行される計算処理の単位)を頑張って開発したり、量子化(数値を少ないビット数で表して計算を軽くする手法)をやってみたり、いろいろやる余地はあります。

ただ、そもそもモデルのパラメータサイズを大きくして性能が良くなったかを見たいのに、量子化したことによって精度が下がるということが起こるかもしれない。それじゃ検証にならない、というのが一つ。あと完全にカリカリにチューニングされたCUDAカーネルを書くのは、結構開発のコストにもなっちゃう。大きい計算機を載せて、ちょっと多少は無駄があるかもしれないけども計算機が大きいから動く。そういう状態になっていた方が、モデルの開発サイクルとしては早くできるんじゃないか。そういう思惑があります。

山口:であればもともと強いワークステーションのようなものを載せて動かしたらいいじゃん、とか思っちゃうんですけども。そういったことは試したことはなかったんですか。

リモート推論からeGPUへ ─ 計算機2台構成とLANの帯域という壁

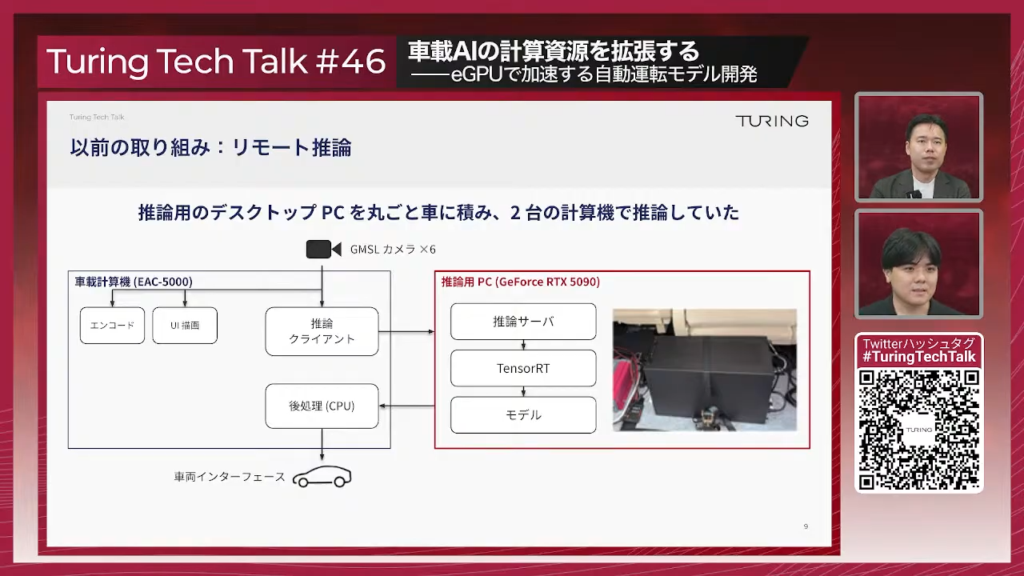
猪狩:本当に過去、まさにそういうことを試していました。デスクトップのPCを車に載せて、このPC自体を推論のサーバーのように運用し、車載用のPCとLANケーブルでつないでネット越しに推論させる。そういう取り組みは実際に存在しています。

山口:これは力技ですけど、普通に思いつきそうな話かなと思っているんですけど。これはなんでダメだったんですか。

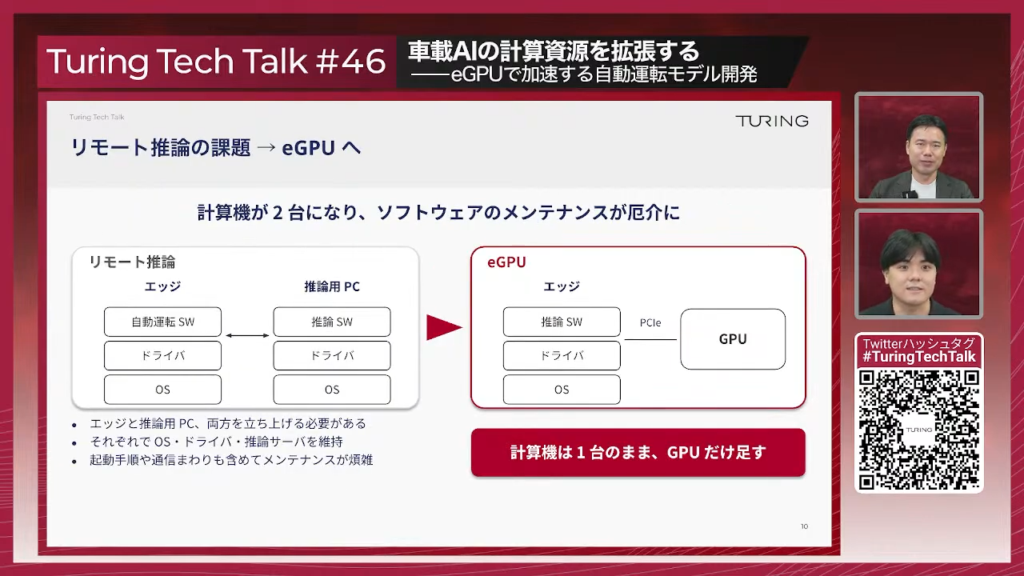
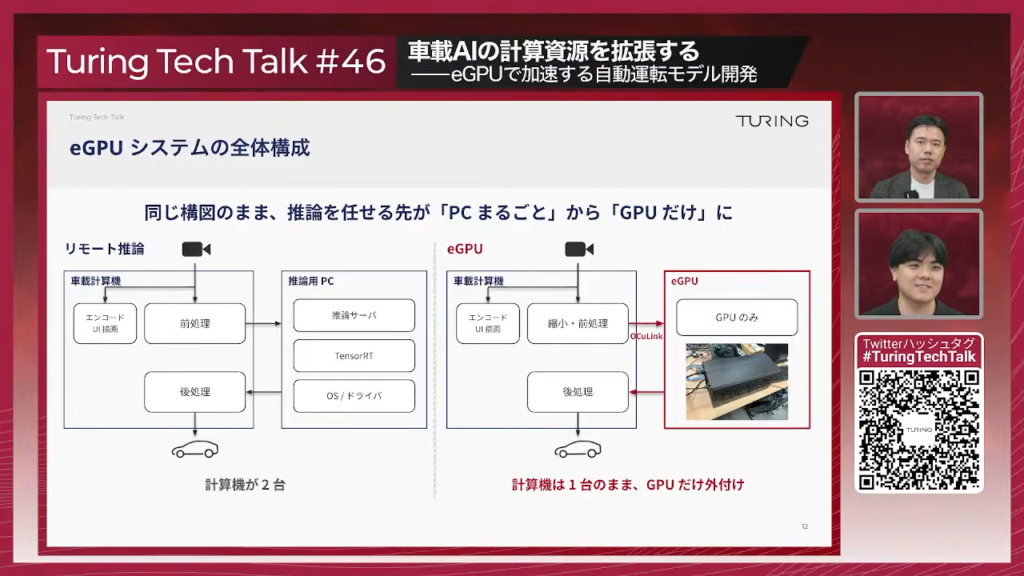
猪狩:結局、PCが2個に増えちゃうわけですね。PCもソフトウェアも2つに増えて、2つのソフトウェアをうまいことタイミングを合わせて立ち上げるようなことが必要になってしまう。結構2つのソフトウェアを管理するという、ソフトウェアのメンテナンス上でもちょっと大変という話が出てきてしまったのが、まず1つあります。あとちょっとここにも書いていないんですけども、通信ですね。結局推論を別のPCにオフロードするので、カメラの画像などを別のPCに送りつけなきゃいけない。LANケーブルでつなぐとどうしてもそんなに速さが出ないので、結局そのレイテンシ的にもあんまり良くないという話もあったりして。もうちょっとシンプルな構成の方が、管理もしやすくて早く動かせたりするんじゃないか。そういう経緯があって、eGPUの開発をするに至っています。

山口:例えば普通のイーサネットケーブルの1ギガの帯域で通信したとすると、1Gbpsなので125メガバイトが1秒間に送れる。10ヘルツでやろうとすると、0.1秒で12.5メガバイトしか1ギガのイーサネットケーブルではデータを送れないんですよね。我々の車って、カメラが何個付いているんでしたっけ。

猪狩:今使っているのだと、7個は使っていますね。

山口:少なくとも7個のカメラの映像を1秒間に10回はどんどん送りつけなきゃいけないから、イーサの1ギガなどの細い帯域だと結構厳しい。それが、結構そもそもシステム上の制約としてあるわけですね。

eGPUの構成とOCuLink ─ GPUだけを外付けする

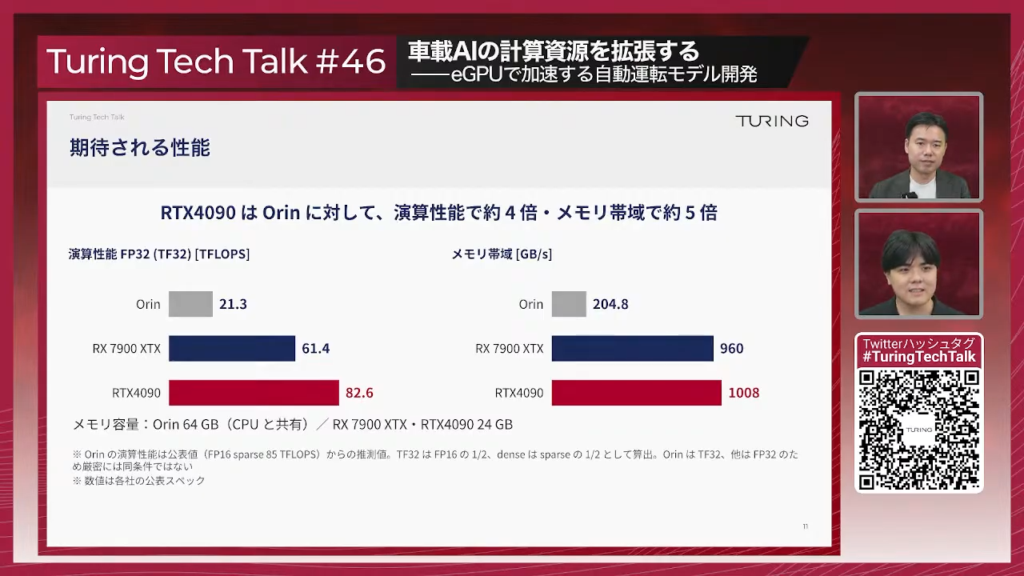
猪狩:一応これはカタログスペックなんですけども、大体単純にTFLOPS、つまり秒間で計算できる値で比較します。RTX4090を載せた場合でも、Orinと比べて4倍とかそれぐらいの性能があることは期待できます。メモリーの帯域、VRAMの帯域でも5倍ぐらいあるので、単純にOrinでやるのと比べると相当性能が上がることが見込めます。それはカタログスペック上でも確かめられます。

猪狩:もともとの構成ではデスクトップのPCに推論サーバーを立てて、推論ソフトウェアとしてまるっと動かす形になっていました。ここの部分を本当に必要なGPUだけにして、GPUに直接画像を送り付けて推論結果を得るというシンプルな構成になっています。

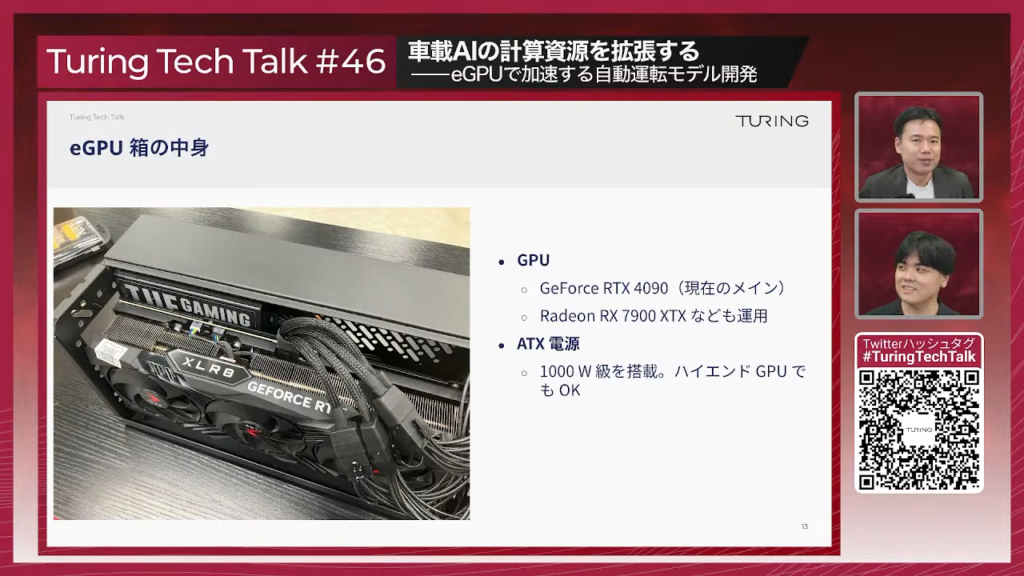
猪狩:eGPUの中身は、見ての通りGPUとATX電源だけが入っているという形になっています。

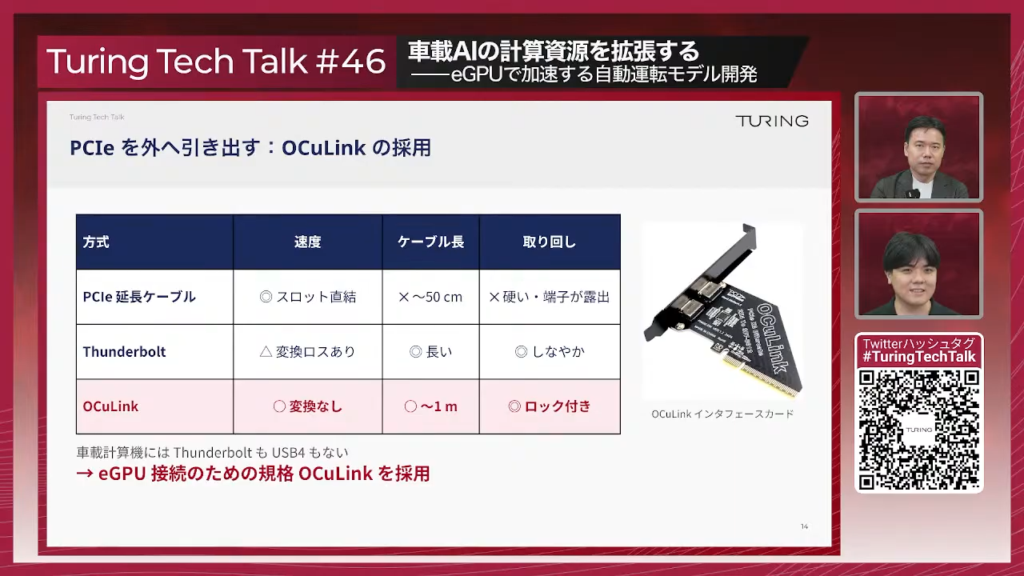
猪狩:車載計算機とGPUをつなげるケーブルについては、本当に普通のノートPCにつなげるeGPUと同じ候補が考えられました。一番いいっちゃいいのは、PCIeをそのまま延長してしまうことでした。ただ、これはさすがに車載するとなったときに安定して組み付けられる気が全くしないぞ、というところで。Thunderbolt、USBでつなぐのは配線の取り回し的には一番いい選択なんですけども。とはいえ帯域も、ThunderboltはPCIeとはまた違う形式なので変換が挟まるんですね。それによってレイテンシーが挟まってしまうので、これもちょっと見送りました。OCuLinkという、本当にeGPUのために考えられた規格なんですけども、PCIeをそのまま外に出せるケーブルを採用しています。

推論時間の比較 ─ 転送時間を加えてもOrinの1/4以下に

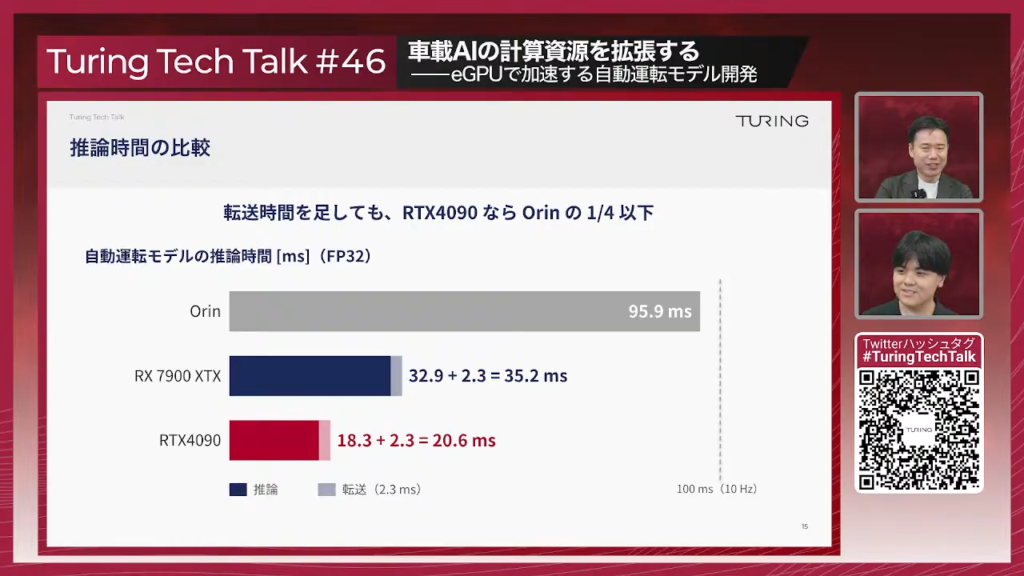
猪狩:こちらが実際に、とあるよく使われている自動運転のモデルの推論時間の比較を示したものです。推論時間といっても、eGPUで推論する場合には推論時間の本体に比べて画像を転送するというものもあるので、それも含めた図になっています。この転送にかかる時間が大体2.3msぐらいになるんですけども、それを加味してもそもそものやっぱりGPUの性能がOrinと比べて4、5倍あります。全体としても、本当に推論時間が1/4ぐらいになるようなものができています。

山口:このOrinで動かすのは95.9msとあるので、ほぼほぼ100ms。10Hzだと、これはかなりギリギリですよね。4090やRXの7900などを使うとだいぶ余裕ができるというか、場合によっては30Hzぐらい出るんじゃないかという感じになっていますよね。転送速度もだいぶ速いですね。

推論エンジンにtinygradを選んだ理由 ─ カーネルを手書きせず探索する

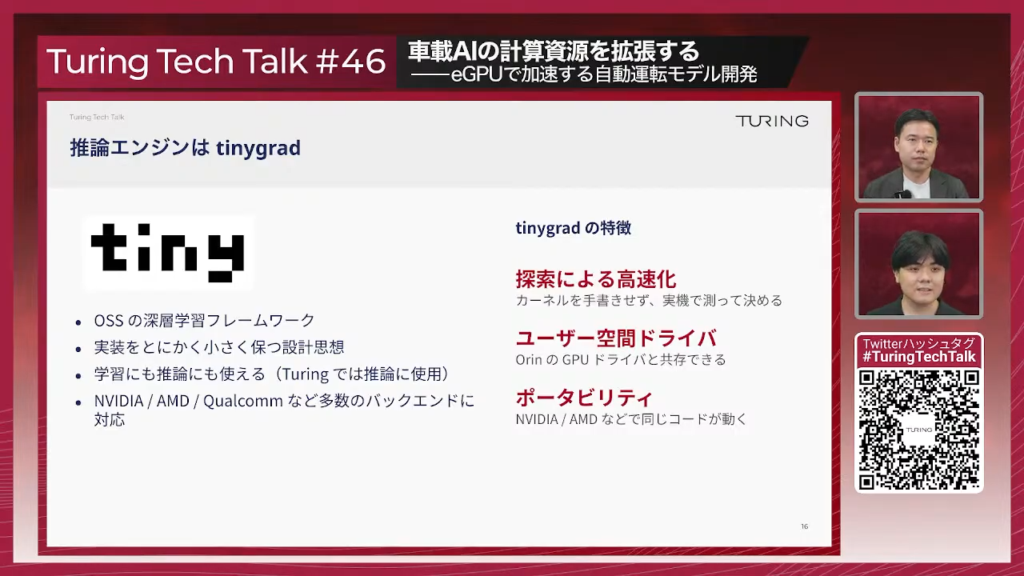
猪狩:このモデルの推論には、tinygrad(OSSの深層学習フレームワーク)というソフトウェアを採用しています。

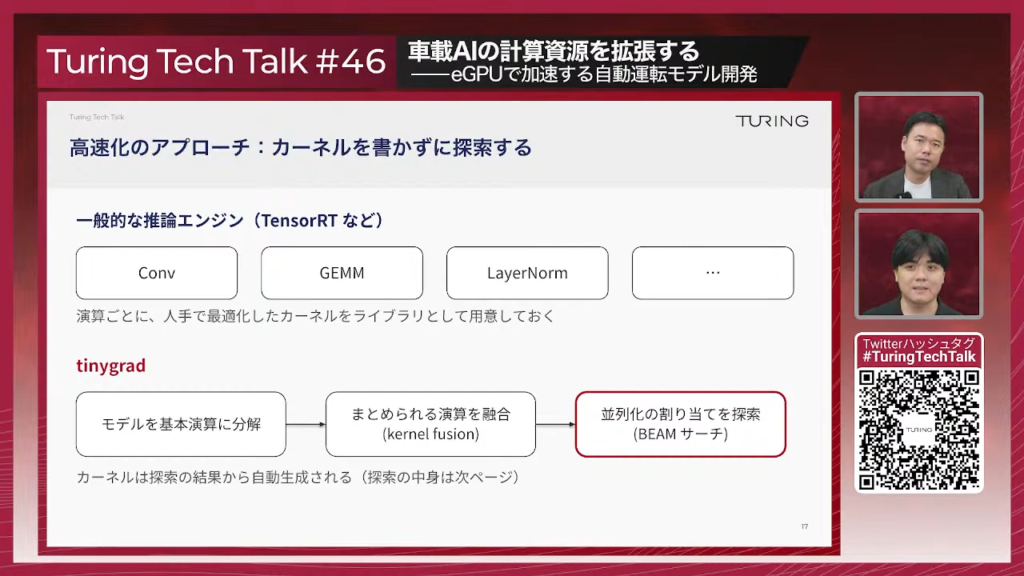
猪狩:大体一般的な推論エンジンは、モデルの各層の各演算に対してこういうCUDAのカーネルを対応させて速く動かす形になっているものが多いんですけども、このtinygradは、基本的に速い計算の仕方を探索するというアプローチをとっています。モデルをもうちょっと最初に足し算や行列積など本当にそれぐらいの単位に一度分解してから、まとめられる演算をまとめていきます。一つの演算単位について速い計算の仕方を探索する、というアプローチになっています。この探索に使われているアルゴリズムが、BEAMサーチ(有望な候補を一定数ずつ残しながら探索を進める手法)と呼ばれるものです。

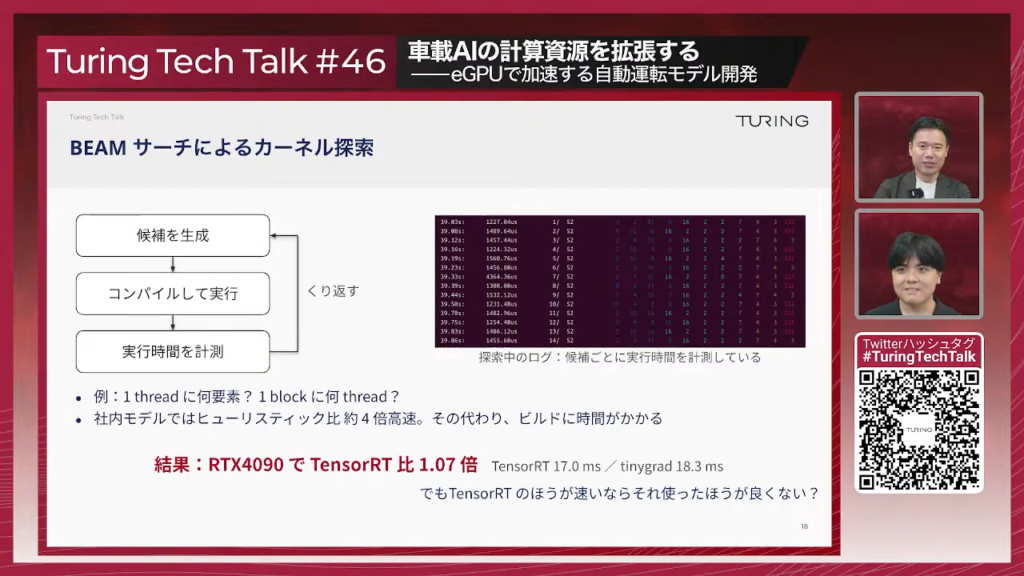
猪狩:NVIDIAのGPUで推論するのであれば、TensorRT(NVIDIAの推論最適化ライブラリ)などを使うと高速にある程度モデルを実行することはできるんですけども。それと比べても遜色ないような速度が、我々が使っているモデルに関して言えば出るというところが確かめられています。

山口:ビルドの時間がめっちゃかかりそうなイメージがあるんですけど、実際どうですか。

猪狩:実際めっちゃかかります。TensorRTでも今使っているモデルで、最適化のオプションなどにもよるんですけども、普段運用しているものだと10分から20分ぐらいはかかります。これもtinygradで同じことをやると、結構1時間、2時間ぐらい。2時間あれば一応大体終わるかなという感じになっています。

山口:探索しているときは、やっぱりCPUも使ったりするんですか。

猪狩:というか、CPUが基本的にもう一番ボトルネックというかですね。探索したものに対して全部コンパイルしているので。

山口:そうなると、結構CPUリッチな環境じゃないとビルドするのも大変だけど、でもこれはエッジでビルドしないと多分ダメですよね。

猪狩:これに関しては今あんまり調べきれていないので、そうなっているんですけども。一応技術的には当然使っているGPUが同じなので、例えばCPUリッチなデスクトップの環境でビルドしてそのままエッジに持ち込むようなことも一応技術的には可能です。ただまだ運用はできないんですけども、そういうのもいずれできるようにしたいなというのはありますね。

山口:4090の1.07倍、これは時間が1.07倍だから、ちょっと遅いということです。「TensorRTの方が速いならそれを使った方が良くない?」とめっちゃ思ったんですけど、何で使わないんですか。

ユーザー空間ドライバとポータビリティ ─ Orinを活かしたままeGPUを動かす

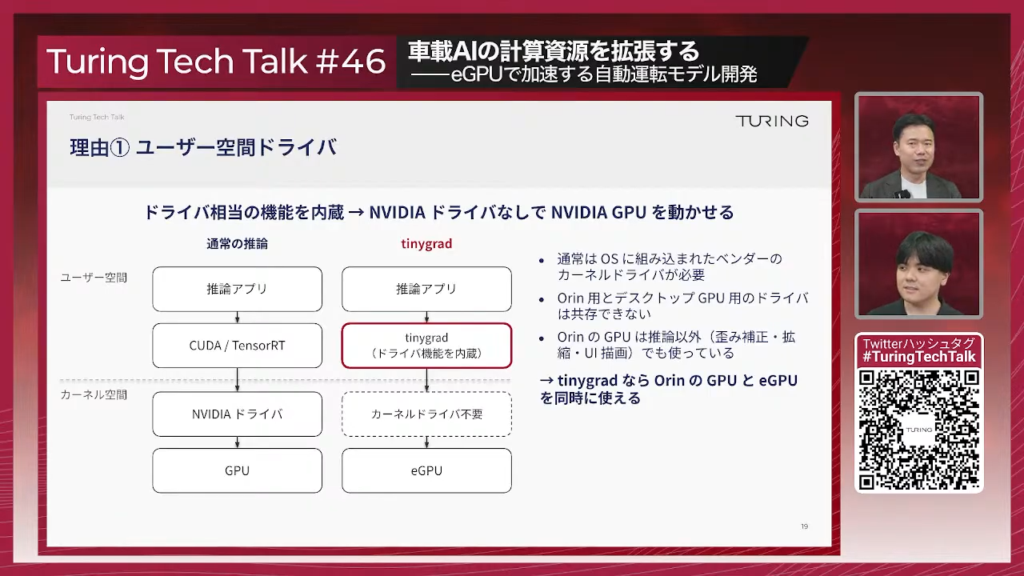
猪狩:使わないんじゃなくて、結構そもそも使えないという話があるんですよね。これがtinygradを採用する現状一番大きい理由なんですけども。tinygradはユーザー空間ドライバー(OSのカーネルではなくアプリケーション側で動くドライバ機能)で動作するというところがあります。普通にTensorRTなどを使うと、大体あらゆるものをNVIDIAのスタックに乗っかる必要があって、要はNVIDIAドライバーを環境にインストールすることが当然前提になるわけです。

もしこの構成で計算機にeGPUを載せることを考えたら、eGPUのGPUのドライバをインストールしなければいけないことになってしまう。ただそもそも今の計算機にはJetson Orinが載っていて、当然そのJetson Orinのドライバがいる状態になっているんですよね。Jetson Orinのドライバーを活かしつつ、さらに新しいドライバーを入れるのがどうしてもできないという事情があって。この構成でTensorRTを使って推論ソフトウェアを書くことはできませんでした。

でもtinygradはドライバーがやる機能に相当するものをtinygrad自身のソフトウェアが持っているので、ドライバーをインストールしなくても動くというところがすごい特徴になっています。それで車載計算機についているOrinを活かしつつ、さらにeGPUの推論が動かせる。現実的にそれができる構成になっていたので、これを採用したという背景がありました。

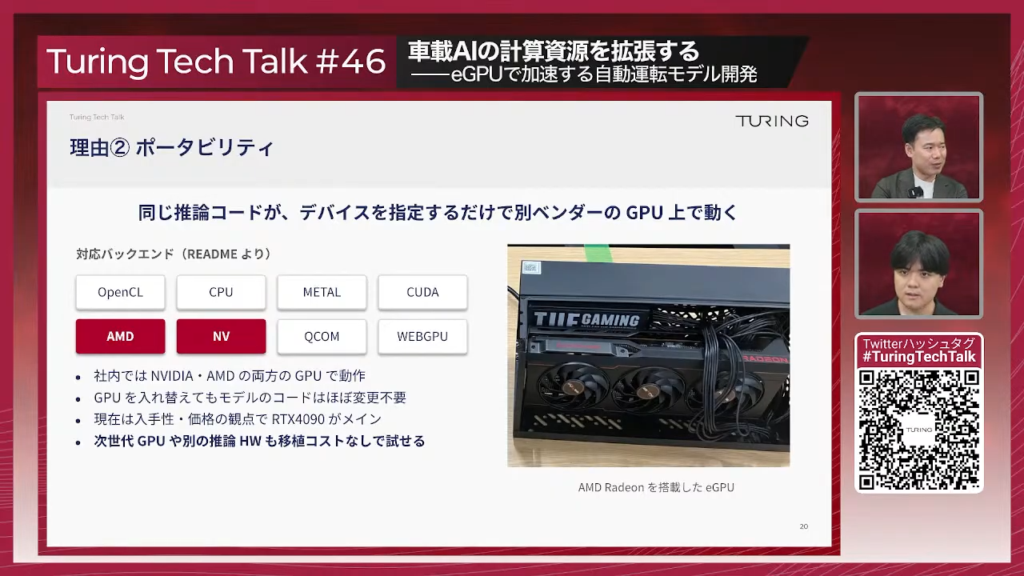
猪狩:あともう一つ、特徴的で採用するに至っていいなと思っているところがあって。それはポータビリティのところにもあるかなと。これは結構さっきの探索による最適化に全部振っているところとも絡んでくるんですけども、要は基本的に「どうせこのハードウェアだからこのカーネルが速い」ということをやっていない。そのため、例えばNVIDIAのGPUのほかにAMDのGPUなどを使ったとしても、ハードウェアに合わせた最適化ができるので、いろんなハードウェアで動かすことができるようになっているのが大きいです。単純に推論する環境として提供するんだったらNVIDIAでいいじゃないか、というのはもちろんあるんですけども。我々のチームとしていろいろな推論ハードウェアの探索をしていきたいとなったときに、探索的にいろいろ使える余地もあるので、結構便利かなというところはあります。

本当にこうやって物理的に物を差し替えるだけで、そちらの部分はほぼ変更を入れずに動かすことができるので、とりあえず動かす環境としてだいぶいいかなと思いますね。

今後の展望 ─ VLMや大きな基盤モデルも実車で試したい

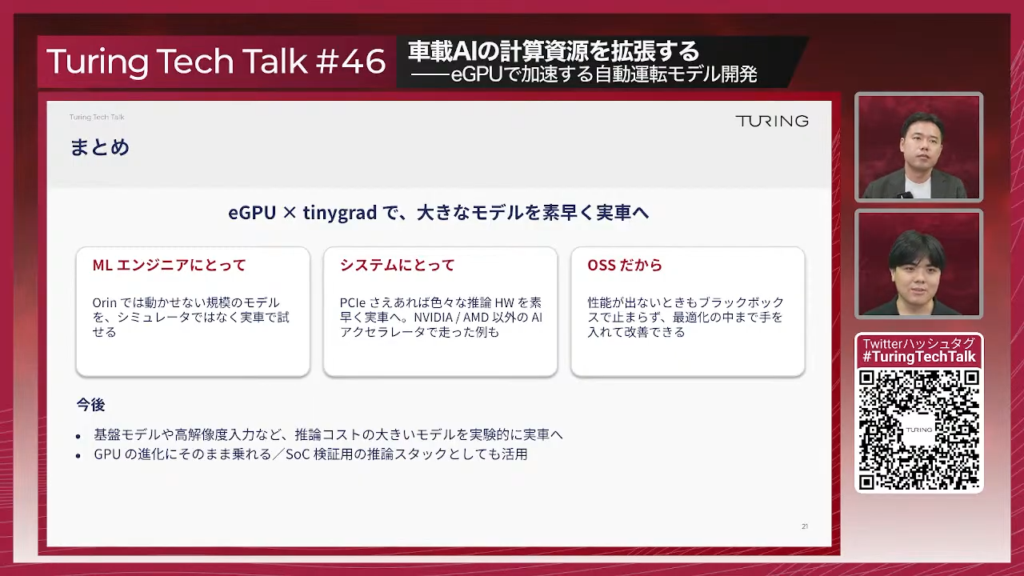
猪狩:結構このシステムは、いろいろな人にとって面白いかなと思っていて。当然MLエンジニアにとっては、大きいモデルを素早く試せる環境になっているかなと思います。一方で我々のように高速化などをする人にとっても、いろいろなハードで試せたり高速化のアルゴリズムの中身をOSSなので見ることができたりする。これで今後もっと、それこそVLM(Vision-Language Model)だったり、大きい基盤モデルのようなものだったり。そういうものをこういう環境で実車で動かしてみたりというのは、やっていけたらいいなと思っています。

山口:ちなみに動かそうと思うと、どのくらいのパラメータサイズのモデルまで動かせるものなんですか。

猪狩:動かすというのは、要はその推論を10Hzで動かしたいかというところにもよります。

山口:とりあえず動かす、という意味です。そういう意味で、どのくらいのモデルサイズまでいけるのかなというのは個人的には気になりますね。

猪狩:これはもう使うGPUのメモリのサイズによるかなと。使うGPUのメモリに入るなら使える、というところになってくるかなと思います。例えば4090だったら24GBですし、5090だったら32GBのVRAMに入るサイズのものだったら動くことになります。例えばInt8で量子化したモデルを動かすんだったら、1パラメータが1バイトなので、32GBぐらいが動かせるというところになってくるかなと思います。

山口:なので5090などをeGPUでつけると、いわゆる30BぐらいのLLMやVLMだったら、結構この環境でおそらく動くだろうという想像もあるということですね。

猪狩:これはでもまさに今も試している部分もあったりしていて、結構気になるところではありますね。

チューリングでは、完全自動運転の技術を共に創る仲間を募集しています。今日お話ししたDriving System3チームはもちろんのこと、非常に幅広いエンジニア職種で仲間を募集しています。職種は、機械学習エンジニア・リサーチャー・ソフトウェアエンジニア・組み込みエンジニア・インフラエンジニアなどです。ご興味のある方は、ぜひ採用ページをご確認ください。多様な職種がありますので、ご自身がどれに当てはまるか、ぜひチェックしてみてください。

Turing TechTalk#45 Databricksで加速するAI開発基盤 ─ MLOps基盤とデータセット作成パイプライン

この記事に登場する人
CTO
山口 祐 Yu Yamaguchi
産業技術総合研究所 研究員/米国NIST客員研究員として研究する傍ら、独自にゲームAIの深層学習の開発を開始。日本の囲碁AIプロジェクトの開発代表として、最大1100GPUの並列分散強化学習を設計・開発し、世界大会準優勝、将棋AIでも世界大会優勝などの実績がある。HEROZ株式会社 執行役員を経て、2022年、チューリングに創業メンバーとして参画。2024年8月、CTO就任。基盤AIチームマネージャー兼任。
MLOps1チーム シニアエンジニア
岩政 公平 Kohei Iwamasa
九州大学の修士課程在学中にKaggleに取り組み、Kaggle Masterになる。サマーインターンでチューリングに関わり、2023年4月に正社員として新卒入社。データ基盤から社内向けのE2E自動運転AIの学習フレームワークを構築。現在はMLOps1チームのシニアエンジニアとして、学習用データセットを構築するデータパイプラインをはじめ、自動運転AI開発を支えるデータ基盤の開発を担当。

はじめに

自動運転AIの性能は、モデルだけでなく、どのようなデータで学習するかに大きく左右されます。チューリングは走行時間にして数万時間、動画だけで数ペタバイトのデータを自社の車両で収集しており、そこから学習用データセットを素早く再現性高く作り続けられるかが、E2E自動運転モデルの改善速度を決めます。今回はこの「データセットを作る」部分に絞り、Databricks Serverless、DAB、MosaicML Streamingを組み合わせた設計と運用に迫ります。

今回のTech Talkでは、CTOの山口と、MLOps1チームでシニアエンジニアを務める岩政が登壇。Serverlessの制約と対処、開発環境と本番環境の分離、ゴールデンデータによる回帰テスト、壊れにくいパイプライン設計、半年で139回のリリースと3,906件のデータセットに至った実績を語りました。

※本記事は「Turing Tech Talk #45」の内容をもとに、一部編集のうえお届けします。

Turing Tech Talk #45 タイトルカード。加速のカギはDatabricks──自動運転AI開発を高速で回すためのデータセット作成パイプライン

MLエンジニアからMLOpsへ

山口:今日はMLOps1チームのマネージャーの岩政公平さんに来てもらっています。前回出てもらったのは確か第18回で、E2E自動運転のモデル開発の話をMLエンジニアとして話してもらいました。簡単に自己紹介をお願いします。

岩政:岩政公平と申します。チューリングに関わり始めたのは4年前ぐらい、当時は九州大学の大学院にいました。入社は2023年4月です。最初から「E2E自動運転を作るぞ」という気持ちでやっていたんですけど、そのためにはデータ基盤や学習基盤、GPUクラスターが必要で、最初からデータ基盤回りを見てきました。

山口:今回のテーマは「加速のカギはDatabricks」と銘打っていて、企業案件みたいですけど、お金をもらっているわけじゃないですよね。

岩政:むしろ僕らが払っているという(笑)。

データパイプラインの全体像と、「ガルーダ」v2の前提

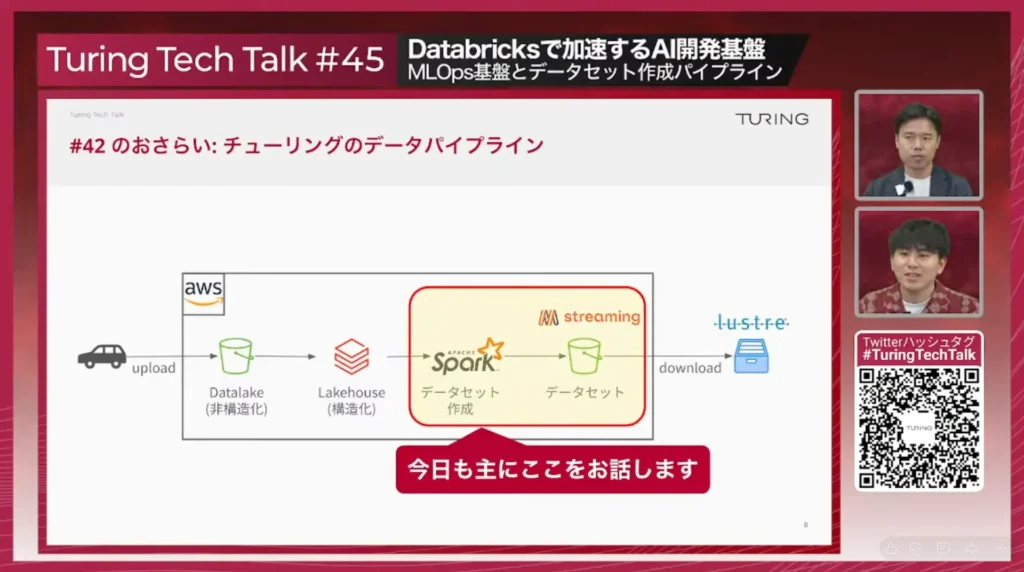
#42のおさらい:チューリングのデータパイプライン。車両からS3へupload、Datalake(非構造化)、Lakehouse(構造化)、Sparkでのデータセット作成、Mosaic Data Streamingのデータセット、Lustreへのdownloadまでの流れ。「今日も主にここをお話します」としてデータセット作成の部分を強調している

岩政:今日の内容は「Databricksを活用して堅牢なデータセット作成パイプラインを組むには」です。テックブログ(Zenn)で公開した記事が主な内容で、第42回で安本さんが話した「ペタバイト級データセットの作り方」を詳しく話す回になります。車両のデータをS3にアップロードしてもらい、Databricksで加工して学習用データセットを作り、各GPUクラスターに配布する。今回はこの「データセット作成」をどう堅牢に作るかという話です。

山口:綺麗なテーブルが車からポンと出てくるわけではなくて、バラバラな形式のものを整えて、レイクハウスで標準化されたテーブルになる。今日の話はその後、どうスケールさせるかですね。

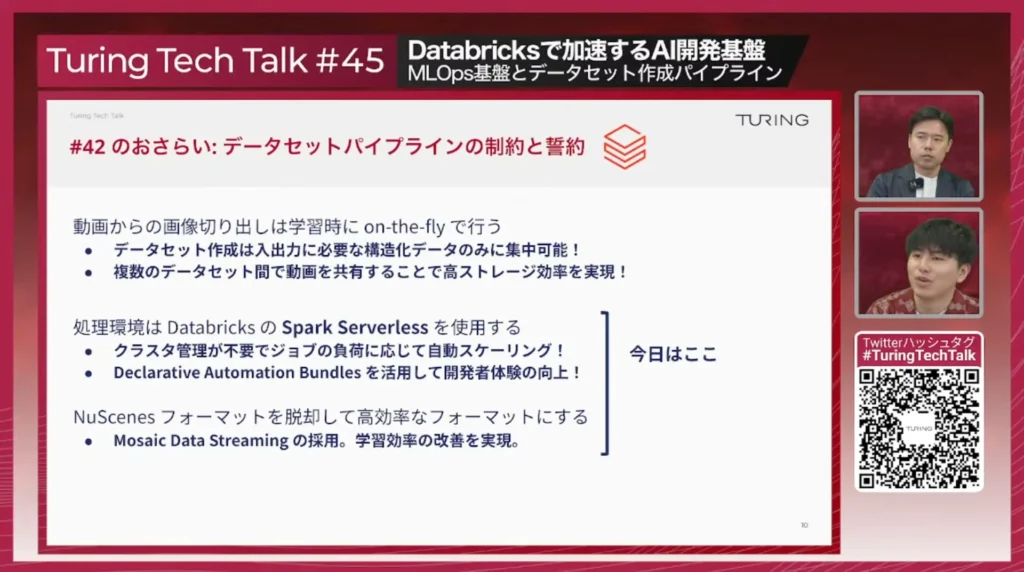
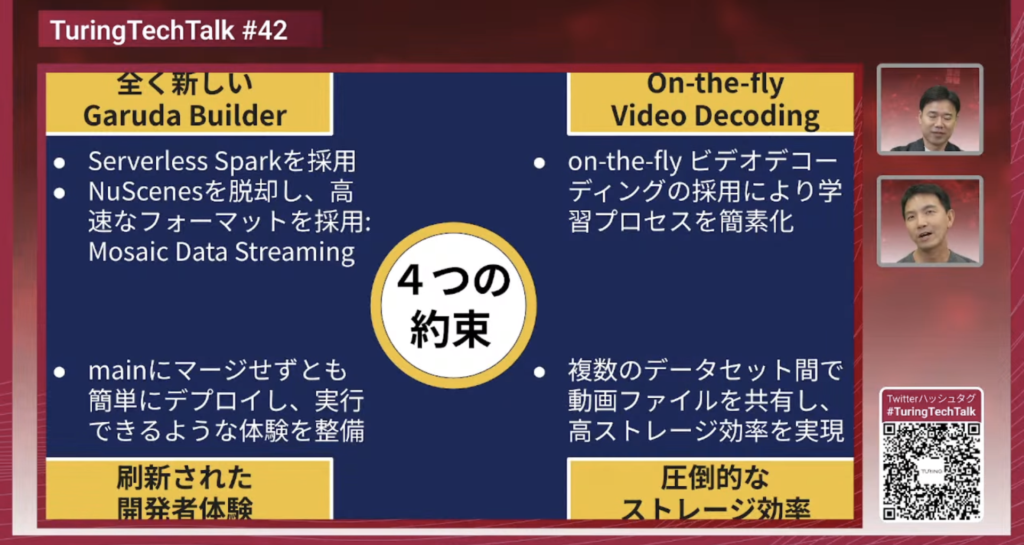
#42のおさらい:データセットパイプラインの制約と誓約。①動画からの画像切り出しは学習時にon-the-flyで行う(データセット作成は入出力に必要な構造化データのみに集中でき、複数のデータセット間で動画を共有することで高ストレージ効率を実現)②処理環境はDatabricksのSpark Serverlessを使用する(クラスタ管理が不要でジョブの負荷に応じて自動スケーリング、Declarative Automation Bundlesで開発者体験の向上)③NuScenesフォーマットを脱却してMosaic Data Streamingを採用。「今日はここ」の注記つき

岩政:僕らはコードネームを「GARUDA」と呼ぶデータセットを作っていて、以前のパイプラインをよりよく作り直そうということで今回のプロジェクトが始まりました。データの大部分は動画で、以前は画像を切り出すのにもクラウド側のリソースが必要でしたが、それを「学習時に行いましょう」としました。この仮定を置くとデータセット作成がかなりシンプルになる。処理環境はクラスター管理が不要なDatabricksのSpark Serverless。かつDeclarative Automation Bundlesで、ジョブやパイプライン、CI/CD(継続的インテグレーション/デリバリー)をコードで管理できる。最後にMosaicMLのMosaic Data Streamingを採用し、学習効率のいいフォーマットにできました。

山口:つまりGARUDAは、いわゆるバージョン2として用意したものだということで合っていますか。

岩政:そうですね。バージョン2です。

Databricksのいいところは、Sparkという分散処理エンジンを完全にマネージドなサービスとして出しているので、ホスティングを考えずに、どうやって処理するかだけに集中できることです。

Databricks Serverlessを選んだ理由と、その落とし穴

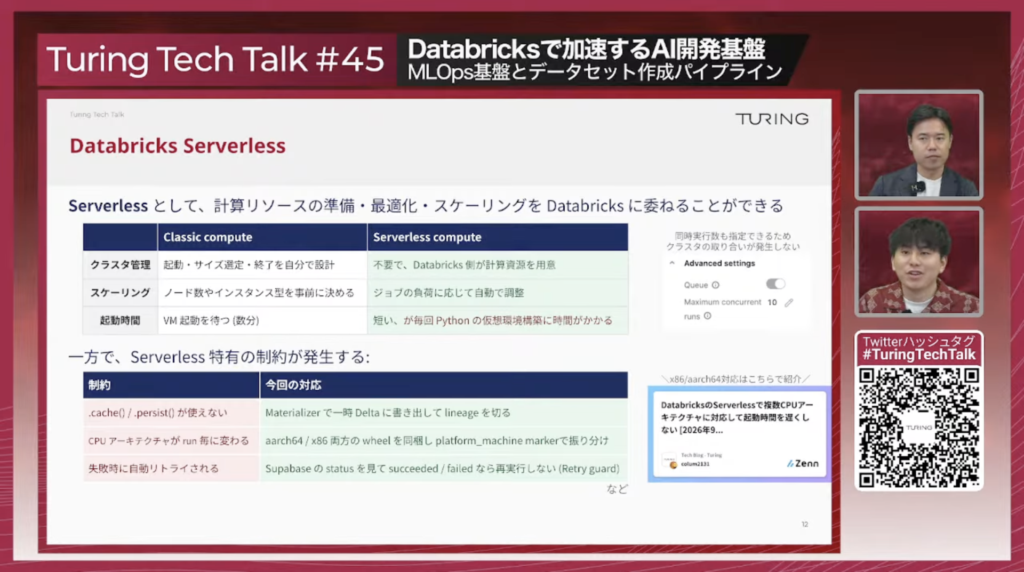
Databricks Serverless。Classic computeとServerless computeの比較(クラスタ管理/スケーリング/起動時間)と、同時実行数も指定できるためクラスタの取り合いが発生しないこと。Serverless特有の制約と今回の対応は、.cache()/.persist()が使えない→Materializerで一時Deltaに書き出してlineageを切る、CPUアーキテクチャがrun毎に変わる→aarch64/x86両方のwheelを同梱しplatform_machine markerで振り分け、失敗時に自動リトライされる→statusを見て成功・失敗なら再実行しないRetry guard

岩政:Databricksにはクラシックとサーバーレスの2つのコンピュートがあります。サーバーレスを選んだ理由は、数千時間分を一気に作りたいユーザーもいれば、評価用に1時間もないデータを作りたいユーザーもいて、1個あたりのサイズが大きく違うからです。同時実行数も指定できるので、一気に処理したい要望にも応えられる。起動時間を短縮できるのも嬉しいポイントです。

一方でサーバーレスには制約もあって、例えばPySparkで「.cache」を叩くと中間結果をマテリアライズしてくれるんですけど、それが使えない。Sparkはチェーン評価でデータフレームを作るので、何回か呼び出される深いものだと毎回作り直しになり、処理が増えるほどCPUやRAMが足りなくなります。Databricks側からサーバーレス用のキャッシュ機能は提供されていないので独自に作りました。一時的にDelta(Delta Lake)へ保存して計算グラフ(lineage)を一度切り、中間結果も裏側ではS3にあるので、そこから毎回読む形で対応しました。

あとは9月4日のアップデートでCPUアーキテクチャにaarch64も登場し、確率的に変わってしまう問題がありました。これはどうにかなったので、ぜひテックブログを読んでください。最初に作るときは大変で、「クラシックコンピュートだったらこんな思いしなくていいのに」という気持ちでやっていました。

山口:ご質問をいただいています。「pipelineの本番運用でも、サーバレスを使用するのでしょうか。コストが爆発したりしませんでしょうか…?」

岩政:データセットを作るところもそうですし、データパイプラインもサーバーレスで実行しています。そちらで爆発することはあまりなかったんですけど、過剰なシーン数を指定したり、バグで計算がループしたりしてコストが跳ね上がることはありました。なのでタイムアウトをしっかりやることと、Sparkのクエリのログを取って無駄を削ること。あとはコストをほぼ毎日監視しています。

山口:コストは爆発する可能性はあるけど、これまでは爆発していない、と。

Goldの外に置いた、データセット作成ジョブ

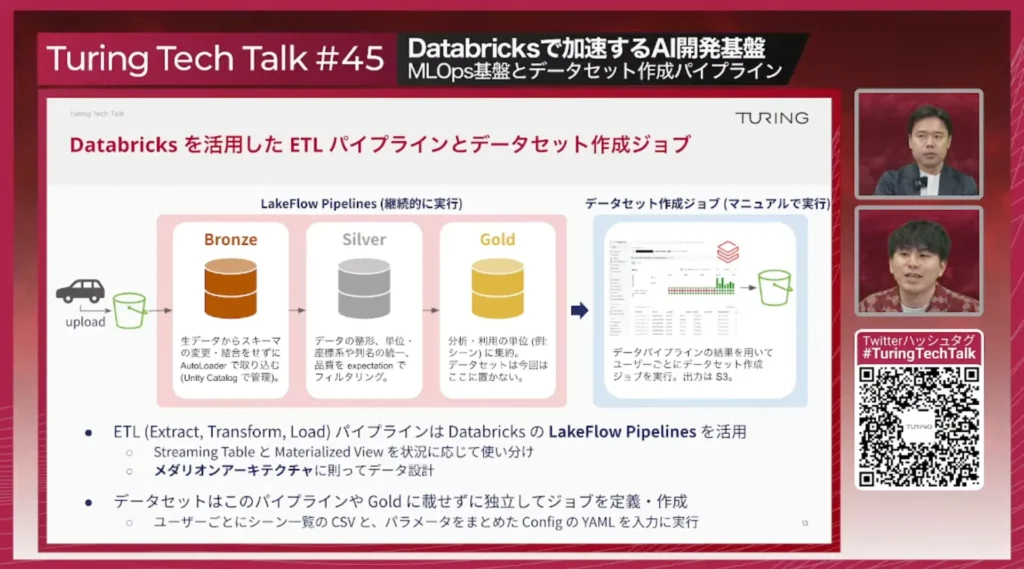
Databricksを活用したETLパイプラインとデータセット作成ジョブ。Lakeflow Pipelines(継続的に実行)で、Bronze(生データをスキーマ変更・結合せずAutoLoaderで取り込み、Unity Catalogで管理)→Silver(整形、単位・座標系や列名の統一、expectationで品質をフィルタリング)→Gold(分析・利用の単位に集約)のメダリオンアーキテクチャ。Streaming TableとMaterialized Viewを使い分ける。その外に、シーン一覧のCSVとConfigのYAMLを入力としてマニュアルで実行するデータセット作成ジョブ(出力はS3)

岩政:車から上がったデータは、まずETL(Extract, Transform, Load)のパイプラインで処理されます。DatabricksのLakeflow Pipelinesで、メダリオンアーキテクチャのBronze・Silver・Goldですね。Bronzeは生データを何も処理せず構造化データに変換して置く。Silverで整形し、単位や座標系、列名を統一したり品質をフィルタリングする。最終的にGoldとして分析や利用の単位で集約します。社内では収集データを「シーン」という単位で区切っているので、ここで明示的にシーンを作ります。今回話すデータセット作成ジョブは、そこで得られたUnity Catalog上のテーブルを使って別個に生やし、マニュアルで実行します。

山口:やり方はいろいろあると思うんですけど、例えばGold自体にデータセットを置くユーザーさんも多いと思います。そっちの方が直感的な気がしますね。

岩政:むしろそっちの方が継続的に処理できますし、個別に生やした分、同じ処理を複数回やってコストが余分にかかる見方もできます。ただ自動運転用のデータセットだと、入出力データの計算処理やスキーマをコロコロ変えられる柔軟性が欲しい。Lakeflow Pipelinesに乗せずに個別に作るようになりました。

山口:研究開発のスピードが速いので、柔軟に対応するために一応2段階に分けているということですね。分量で言うとどれくらいですか?

岩政:時間で言えば数万時間単位で全て管理しています。

山口:動画データだけでも数ペタバイトいきますし、メタデータやセンサーデータもたくさんあって、統合すると巨大なデータになりますよね。

岩政:Databricks以前はメダリオンアーキテクチャみたいな考え方や、柔軟に管理するシステムを組んでいなかったので、対応の難しさがありましたね。

DABで、ジョブも環境もすべてコードで管理する

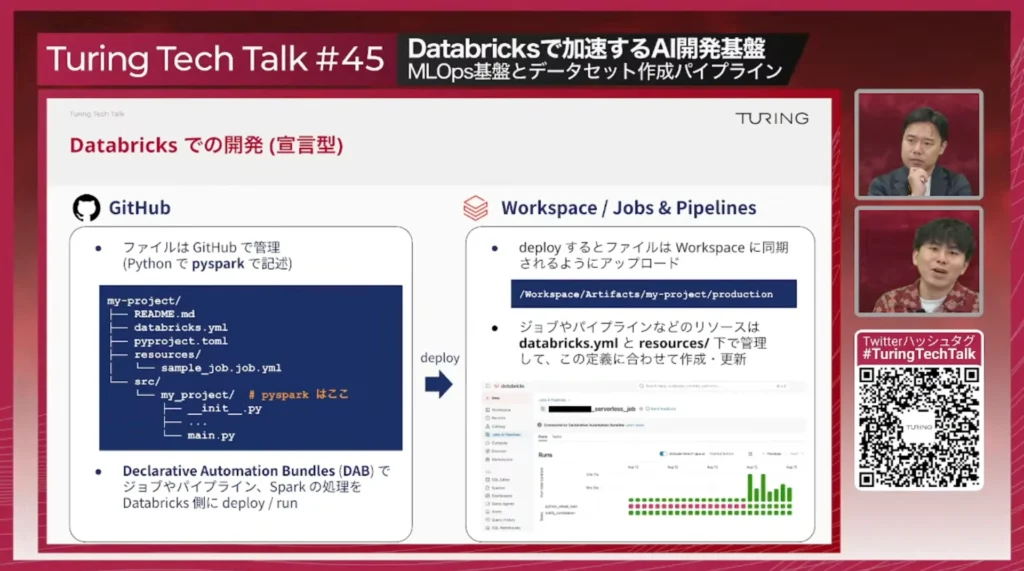
Databricksでの開発(宣言型)。GitHubで管理したPython/PySparkのプロジェクト(README.md、databricks.yml、pyproject.toml、resources/、src/)を、Declarative Automation Bundles(DAB)でWorkspace / Jobs & Pipelinesへdeploy / runする。ジョブやパイプラインなどのリソースはdatabricks.ymlとresources/下で管理する

岩政:Databricksの最新の開発スタイルとして、宣言型のDAB(Declarative Automation Bundles)でコード管理をしていて、僕らは基本的にPython/PySparkで記述しています。ジョブやパイプライン、Sparkの処理、Databricksへのデプロイや実行まで全てコードとCI/CDで完結するので、今のAI時代にかなり合っています。

山口:YAMLで設定やパイプラインのフローを定義できる。インフラでいうとTerraformのようなIaC(Infrastructure as Code)のワークフロー版、みたいな感じですかね。

岩政:正しいです。それです。

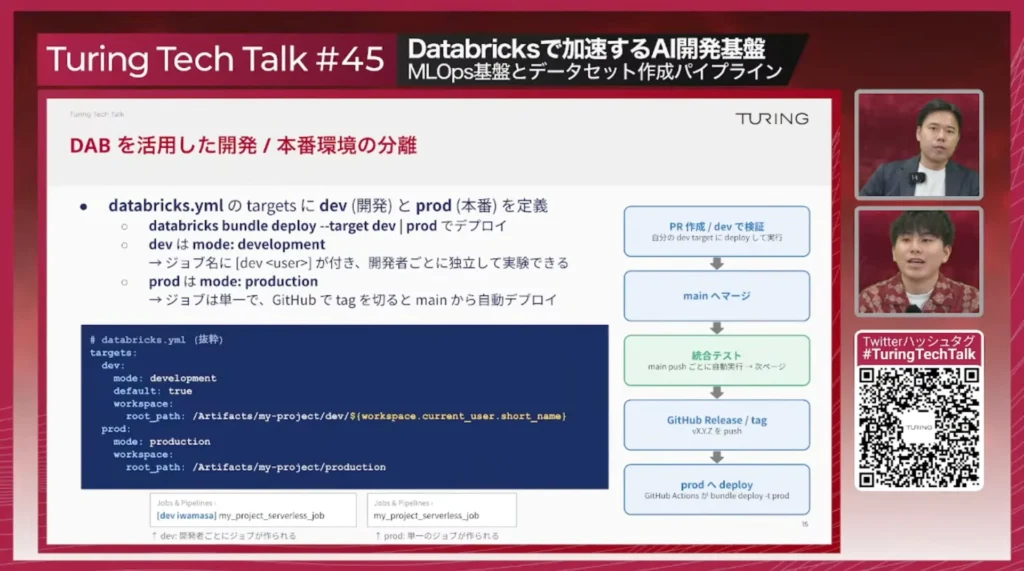
DABを活用した開発/本番環境の分離。databricks.ymlのtargetsにdev(開発)とprod(本番)を定義し、databricks bundle deploy --target dev | prod でデプロイ。devはmode: developmentでジョブ名に[dev <user>]が付き開発者ごとに独立して実験でき、prodはmode: productionで単一のジョブ。GitHubでtagを切るとmainから自動デプロイ。フローはPR作成/devで検証→mainへマージ→統合テスト(main pushごとに自動実行)→GitHub Release / tag(vX.Y.Zをpush)→prodへdeploy(GitHub Actionsがbundle deploy -t prod)

岩政:DABを使うと開発環境と本番環境の分離が簡単になります。databricks.ymlのtargetsにdevとprodを分け、それぞれにデプロイできる。devのmodeをdevelopmentにするとジョブが個人ごとに作られ、独立して実験できます。prodはユーザーから触れないようにしていて、PRを作成してdevで検証、mainにマージ、インテグレーションテストを行い、GitHubタグが切られるとprodにデプロイされる、という流れで回っています。

山口:この辺りの話はモダンな開発スタイルを踏襲していてすごくいいですね。

岩政:DABの良さが一番詰まっている部分です。devで見せるデータの範囲も定義できて、今回は全テーブルを参照できるようにしているので、開発環境で本番相当のデータを見ながら作れます。社内には本番反映をスキップして、dev環境で作ったデータセットをそのまま学習に使う「いい意味での抜け道」を使うエンジニアもいます。コミットハッシュが残るので、後から過去のバージョンに戻って再実行できます。

山口:devで脱法的にフローをやるのは、岩政さんのようなプラットフォームを開発しているチームではなくユーザー側ということですね。今、実際に触っているメンバーは20人はいない?

岩政:いや、後で話そうと思うんですけど、触っているのは40人ぐらいいるんですよね。

山口:そんなにいるんですね。エンジニアは50人ぐらいなんですけど、8割ぐらいは実はこの機能を使っている。私も使っています。

岩政:うち20人ぐらいはリリースをやったことがあります。MLOpsだけで管理するのではなく、MLエンジニアや他のユーザーからも機能を追加できるシステムです。

ゴールデンデータで回帰テストをする

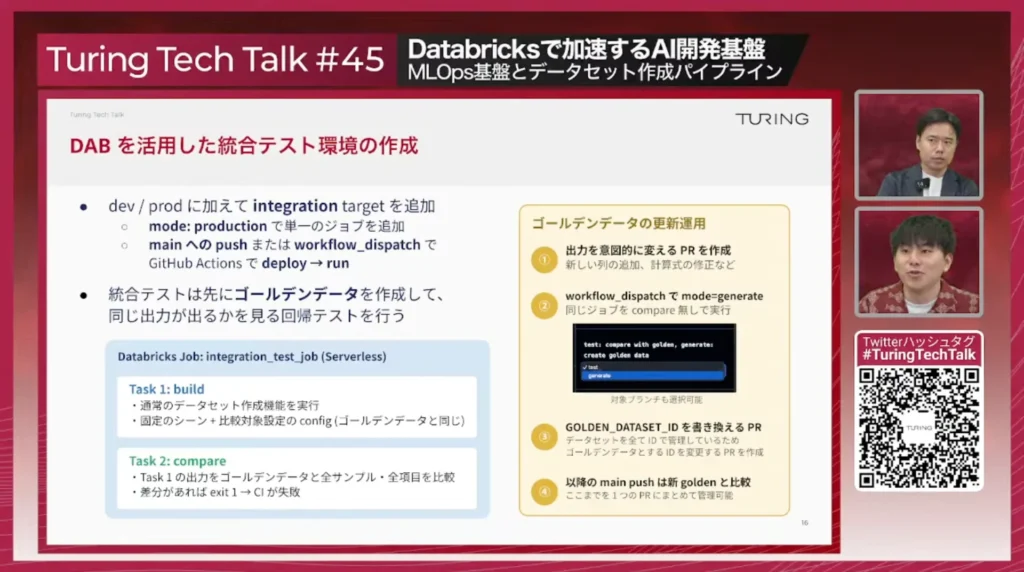
DABを活用した統合テスト環境の作成。dev/prodに加えてintegration targetを追加し、mainへのpushまたはworkflow_dispatchでGitHub Actionsがdeploy→run。integration_test_jobはTask 1: build(固定のシーンと比較対象設定のconfigでデータセット作成機能を実行)とTask 2: compare(出力をゴールデンデータと全サンプル・全項目で比較し、差分があればexit 1でCIが失敗)。ゴールデンデータの更新運用は、①出力を意図的に変えるPRを作成②workflow_dispatchでmode=generate③GOLDEN_DATASET_IDを書き換えるPR④以降のmain pushは新goldenと比較、の4ステップ

岩政:新しい機能が壊れずに動くか、値が変わっていないかを見る統合テストも、integrationというターゲットを足せば簡単に作れます。僕らはシンプルに、「これが正解です」というゴールデンデータを作っておいて、同じ出力になるかの回帰テストを行う。固定のシーンと同じコンフィグでビルドし、結果を全件比較して差分があればCIが失敗する。意図して出力を変える人もいるので、generateというモードで生成し直し、登録しているIDを差し替えれば新しいゴールデンデータで比較できます。

山口:正解となるデータセットを一個用意しておいて、このご本尊がちゃんと生成されることを毎回通しで見ている。ゴールデンデータはいっぱいあるんですか。

岩政:基本的には1個ですね。mainに追従する形で設定しています。

PipelineStep──直列に並べるだけの設計

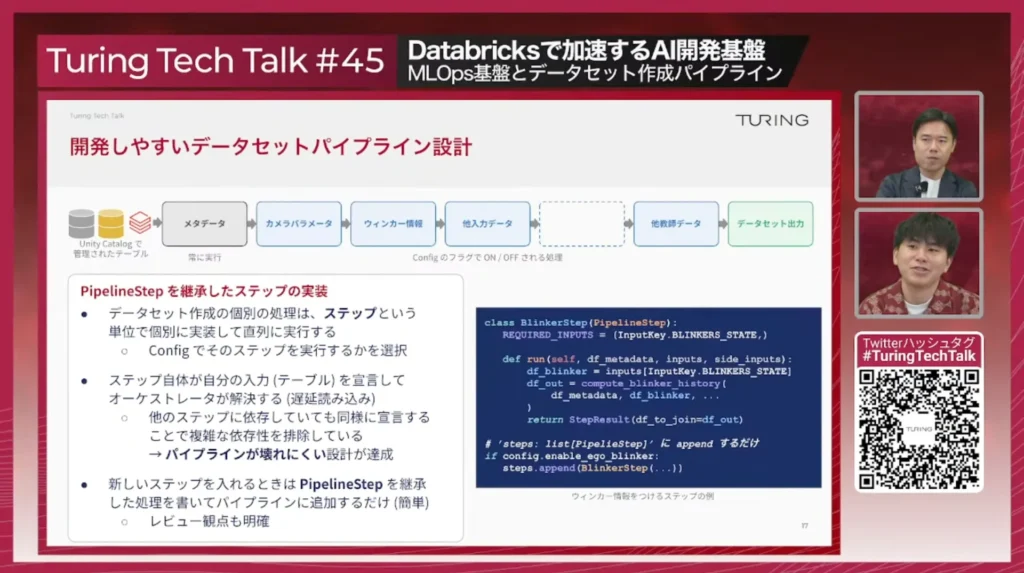
開発しやすいデータセットパイプライン設計。Unity Catalogで管理されたテーブルから、メタデータ(常に実行)→カメラパラメータ/ウインカー情報/他入力データ/他教師データ(Configのフラグでon/off)→データセット出力。ステップが自分の入力テーブルを宣言し、オーケストレータが遅延読み込みで解決することで複雑な依存性を排除している。PipelineStepを継承したステップの実装例(class BlinkerStep、REQUIRED_INPUTS、StepResult)

岩政:ここから先はDatabricksはあまり関係なくて、Pythonのアーキテクチャの話です。作りたいデータはユーザーによって異なります。「カメラのパラメータが欲しい」「誰が運転していたかが欲しい」といった入力データもあれば、教師データも「俺は20秒先のデータが欲しい」「いや俺は3秒まででいい」と変わる。そこで一つの出力パターンを処理する単位を「ステップ」と定め、「PipelineStep」という抽象クラスを直列に並べる形にしました。

BlinkerStepはウインカー情報をつけるステップの例で、REQUIRED_INPUTSというクラス変数で必要な入力テーブルを宣言します。これをオーケストレーターが見て遅延的に読み込む。あとは必ず作られるメタデータを受け取り、Sparkで処理して、StepResultというデータクラスで返す。このワンセットを配列に入れると直列に処理されます。

山口:DAG(有向非巡回グラフ)がややこしくなると、どれをどの順番でやるか、べき等かどうかとか、気にしなきゃいけない話が増える。直列に処理していけば、あんまりややこしいことは考えなくていい。ちなみに、ステップを入れたり外したりユーザーが選択できると言っていましたけど、それもYAMLで宣言的に書くんですか。

岩政:そういうことです。他のステップに依存する処理も宣言してもらうことで関係が明確になり、侵襲的にならない。こういう書き方だとレビュー観点が明確になる。以前だったら「この処理は内部で何をやっているかよく分からんが、他の処理は壊していないから通ってよし」みたいな、現場猫スタイルのレビューが一応できた。速度を出す、と言うと「安全ではないのでは」と取られそうですが、このサービスは社内に閉じていますし、安全検証は別のところでちゃんとできます。

学習側のフォーマット、MosaicML Streaming

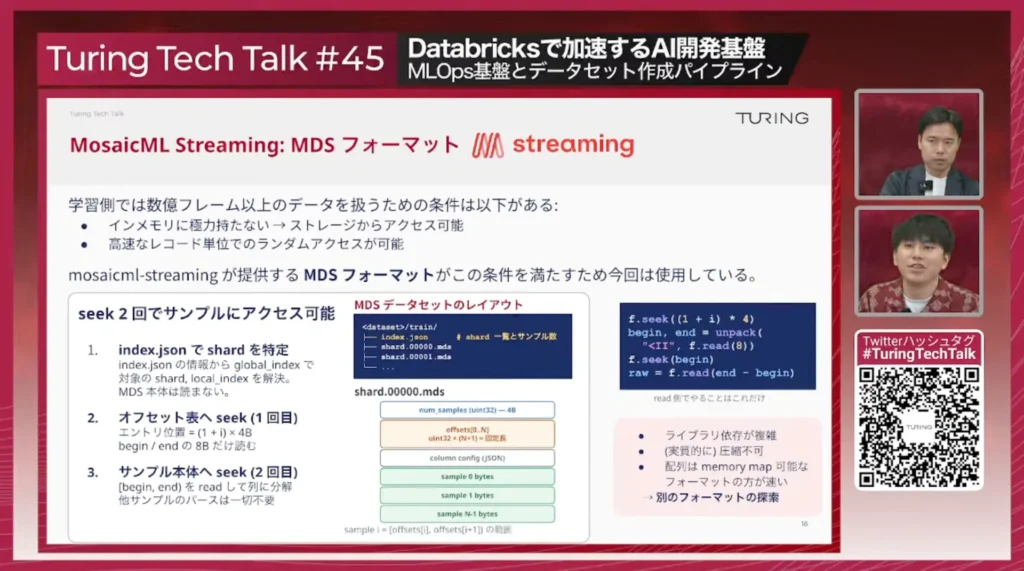
MosaicML Streaming: MDSフォーマット。学習側では数億フレーム以上のデータを扱うため、インメモリに極力持たずストレージからアクセス可能で、高速なレコード単位のランダムアクセスが可能であることが条件。index.jsonでshardを特定し、オフセット表とサンプル本体へのseek 2回でサンプルにアクセスできるレイアウト。課題はライブラリ依存が複雑・(実質的に)圧縮不可・配列はmemory map可能なフォーマットの方が速いこと

岩政:出力フォーマットにはMosaicML StreamingのMDSを使っています。学習側では数億フレーム、数億サンプル以上のデータを扱っていて、普通のPyTorchのデータセットのようにインメモリに持たせられない。高速なレコード単位のランダムアクセスができ、かつ細かく分割しすぎても別の問題になるので、ある程度固めたフォーマットが必要で、MDSがこの条件に合う。グローバルなインデックスからindex.jsonで対象のシャードとローカルインデックスを解決し、シャード先頭のオフセット表を読んでもう一度シークする。seek 2回で読み出せるシンプルなフォーマットです。

山口:MDS自体には動画は入っていなくて、パイプライン処理されたテーブルデータ、グラウンドトゥルースやメタデータが格納されていて、それが動画と紐付いて学習に使われるということですね。機械学習はランダムアクセスをするので、ストレージにめっちゃ負荷がかかりそうな気がするんですけど。

岩政:かかると思います。かかるんですけど、そこはまた別の機会にお話ししましょう。僕があまりそこまで踏み込んでいなくて。

山口:単純に速いストレージを使うのが解決策の一つですね。DDNのLustreのような、ランダムアクセスに強い分散ファイルシステムを使っているので耐えている。MDSもそういう前提で設計されているのかな、と聞いていて思いました。

岩政:多分それですね。次回からそう答えられるよう練習しておきます(笑)。課題もあって、ライブラリの依存が複雑で開発も止まっているので、早めに脱却しようかなと思っています。次に目指すのは圧縮可能であること。あと配列データだと、memory map可能なフォーマットの方が明らかに速いんですよね。なので別のフォーマットを探索していこうと社内で話しています。

リリースから半年──139回のリリースと3,906件のデータセット

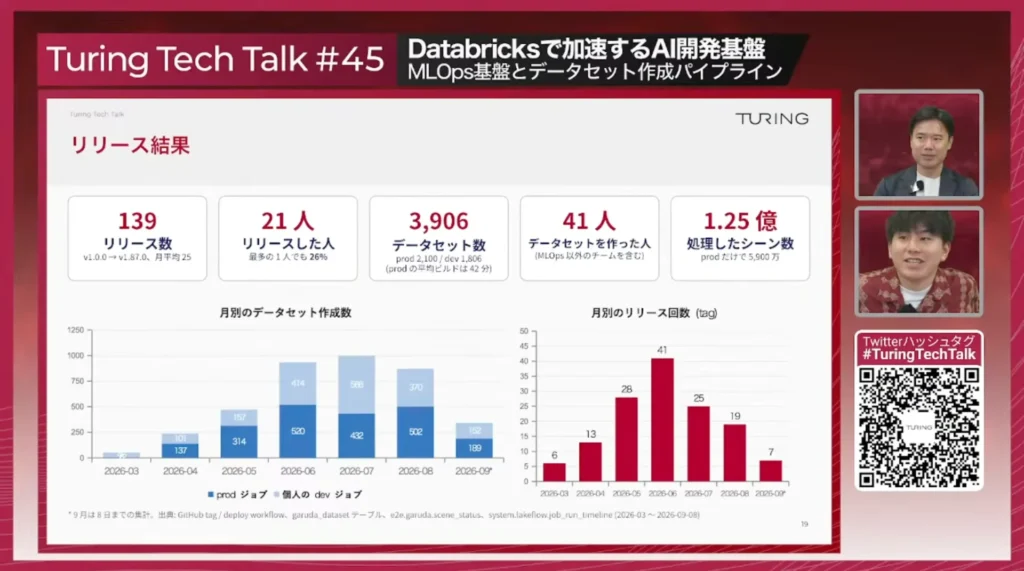
リリース結果。リリース数139(v1.0.0→v1.87.0、月平均25)、リリースした人21人(最多の1人でも26%)、データセット数3,906(prod 2,100/dev 1,806、prodの平均ビルドは42分)、データセットを作った人41人(MLOps以外のチームを含む)、処理したシーン数1.25億(prodだけで5,900万)。月別のデータセット作成数とリリース回数のグラフ。※9月は8日までの集計

岩政:これでようやくリリースができました。ここまで長く苦しい戦いでしたね。

山口:おめでとうございます。ちなみに、いつ頃リリースしたんですか。

岩政:メジャーバージョンの1.0.0が多分3月20何日で、ようやく半年ぐらいのシステムです。構想は前からあったんですけど、動画からの切り出しが一番大変な部分で、そこが排除できたので「作りましょう」となったのが今年の1月ぐらい。そこから3ヶ月、主に自分とグループリーダーの安本さんの2人でやりました。

山口:結構複雑なシステムですけれども、2人だけで作ったということですね。

岩政:意外といけちゃいましたね。

山口:確か5月ぐらいに、一個前のバージョン1から切り替えたんですよね。

岩政:そうです。6月に跳ねているのはそれで、もともとのデータセットを5月に全部なくそうという全社的な判断で移行しました。

山口:かなり出来が良かったので、「5月末までにみんな移行してください」と大号令を出して無理やり移行して、うまくいった印象でした。

岩政:なんだかんだ、いい感じにいきました。リリース数は新しいパイプラインステップを追加した数だと思ってもらえばよくて、今日までで139回。コンフィグのパラメータが追加されるとマイナーバージョンが上がるバージョニングで、今87まできました。

山口:つまり新しいコンフィグの機能が87個追加されているということですね。後方互換性は気にしていたりするんですか。

岩政:基本的には気にしない場合が多いですね。過去のバージョンに戻って作り直せるので。次に、新しくパイプラインステップを作った人が21人。エンジニア大体50人のうち40%がコントリビューターになっているという嬉しい話です。僕が一番でも26%なので、かなり分散して作られています。データセット数は今日見たら3,906件。1個あたり大体1,000時間で、1万時間クラスはまだ分割しないと作れない課題はあります。

山口:リリースされてまだ数ヶ月で、月500件以上作られているのは驚異的ですね。

岩政:MLエンジニアがめっちゃたくさん作ってくれているなと。

山口:逆に言うと、それだけどんどん作れるぐらい使いやすいということですね。

岩政:1件あたりの平均ビルドは42分で、今は1,000時間ぐらいを1時間程度で作れます。データセットを作った人は41人で8割ぐらい。MLOps以外のチームも使っています。最後が処理したシーン数で、あまり意味はないんですけど1.25億シーン。次に目指すは10億シーンです。

山口:ちなみに1シーンというのは何秒に相当するんですか。

岩政:1シーンは、今は20秒です。

山口:20秒×1.25億をこのパイプラインで処理しているということですね。1日かかっていたらこんなに作れないので、Sparkで分散して高速に作れる設計思想がはまっている。本当にSpark様様です。

壊れない枠と、壊せる中身

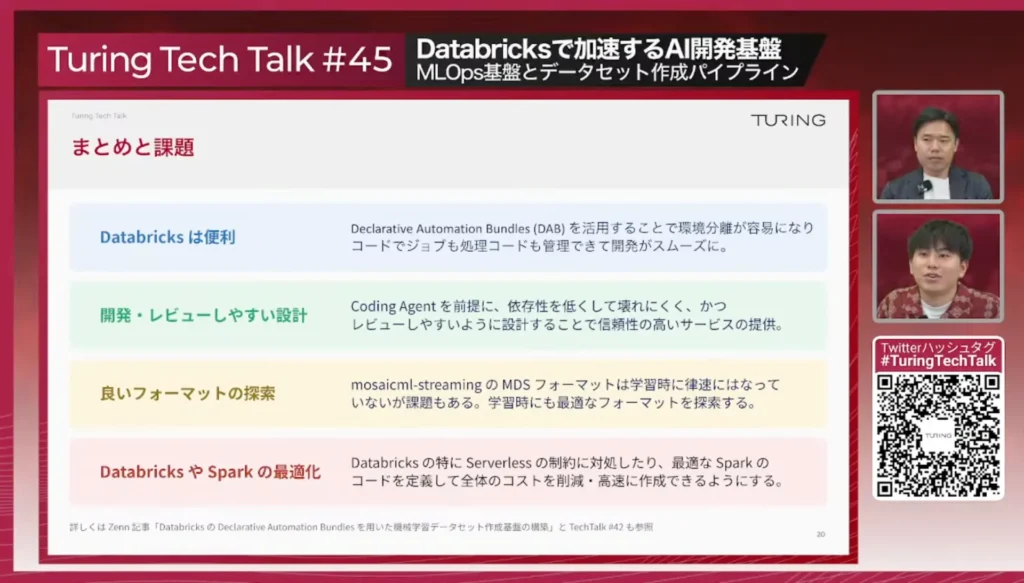
まとめと課題。Databricksは便利(DABで環境分離が容易、コードでジョブも処理コードも管理)/開発・レビューしやすい設計(Coding Agentを前提に、依存性を低くして壊れにくく、レビューしやすいように設計)/良いフォーマットの探索/DatabricksやSparkの最適化

岩政:まとめると、Databricksはかなり便利なサービスで、データの管理も、データセットを高速に作るところもよくできています。開発・レビューしやすい設計にできたので、このスピードでどんどんリリースができた。コーディングエージェントの世界ですけど、逆に一般的なソフトウェアエンジニアリングの知識は一定取り入れるといい、という当たり前の話ですね。今後の課題はいいフォーマットの探索と、DatabricksとSparkの最適化。ここは苦戦しました。僕はpandasやPolarsが大好きなんですけど、Sparkは違う書き方をしないといけない。DAGをいかに浅くするか、ソートやシャッフルをいかに減らすか、ブロードキャストジョインや、機能にないas-of joinのような処理を独自で書いたり。世に情報が出ていないので、僕もTipsを出していきたいです。

山口:MLの知識がある上でMLOpsをやる、というところの岩政さんなりの関係性はどういう感じですか。思想とかアプローチとか、違うところはあります?

岩政:思想で言えば、「壊しやすさ」は一定あると思っていて。今回作ったパイプラインのフレームワーク自体は絶対壊さない、ソフトとして堅牢に作る。でも内部のモジュール、今回だとパイプラインステップは、ユーザーが自由にいじれて、本番に簡単にデプロイしてすぐ検証できるようにする。検証・実験サイクルをいかに速く回すかに注目して作れたのが、MLエンジニアならではの思想かなと思います。

山口:最後のご質問です。「データ基盤としてはかなりリリース頻度が高い印象ですが、CI/CDや回帰テストが整備されているからこそ実現できている、という理解で合っていますでしょうか」

岩政:まさしくそうだと思います。特定の人に属人化していないのが僕的にはいいところで、誰でもリリースできる仕組みにしているのが、この頻度でリリースできている理由かなと。品質管理は、機械的に検知できるものはなるべく機械的に検知する。回帰テストも、みんなが使う新しいパイプラインステップができたら優先して入れますし、特定のシーンでしかバグを踏まないものなら、そのシーンをテストに追加する。

山口:もしチームにこういう人がいたらいいな、という人はどういう人ですか。

岩政:ふわっとした回答になりますが、MLOpsは「データ基盤を整備すればいい」では収まらないですね。最終的な目標は自動運転の性能を上げることで、そのためにAIの外側をいかに整備できるかが課題なので、そこを全体で見て最適化できる人が一番来てほしい。データセットを作る人間で終わらず、自動運転の開発を高速にするところを見て、新しい課題を見つけて取り組んでくれる人が来てほしいなと思います。

山口:自動運転AIをいかに良くするかという課題に向き合って、一番良いアプローチを選択できる経験があるとすごく良いということですね。

Q&A一覧(一部抜粋)

以降は視聴者のQ&Aに回答していきました。詳しくは動画をご覧ください。

  • 図ではDatabricksのLakehouseとApache Sparkによるデータセット作成が分けて表現されていますが、実際にはDatabricks上でSparkを使ってデータ処理するケースが多いと思います。この2つをあえて分けて表現されているのは、何か意図があるのでしょうか?
  • pipelineの本番運用でも、サーバレスを使用するのでしょうか。コストが爆発したりしませんでしょうか…?
  • パイプラインには、キャッシュを設けてますか?大規模データの場合、どこかにキャッシュをつくりたくなるのかと想像しました。
  • Serverlessではcacheやpersistが使えないとのことでしたが、再利用頻度の高い中間データについては、基本的にDeltaへmaterializeする方針なのでしょうか?
  • データ基盤としてはかなりリリース頻度が高い印象ですが、CI/CDや回帰テストが整備されているからこそ実現できている、という理解で合っていますでしょうか。また、そのほかに特に重視されている品質管理の仕組みがあれば、教えていただけますか?

チューリングでは、完全自動運転の技術を共に創る仲間を募集しています。今日お話ししたMLOps1チームはもちろんのこと、機械学習エンジニア、リサーチャー、ソフトウェアエンジニア、組み込みエンジニア、インフラエンジニア、ドライバー、メカニックなど、非常に幅広いエンジニア職種で仲間を募集しています。ご興味のある方は、ぜひ採用ページをご確認ください。多様な職種がありますので、ご自身がどれに当てはまるか、ぜひチェックしてみてください。
「自動運転」で身構えなくていい。——​自動運転未経験だった​二人が担う、開発車両のメカニックという仕事

この記事に登場する人
データ収集チーム
草葉 史明 Fumiaki Kusaba
専門学校を​卒業後、​トヨタ系ディーラーで​8年。​トヨタ検定1級と​自動車検査員を​取得し、​現場の​リーダーを​務める。​その後、​自動車整備士を​育成する​専門学校の​教員と​して​17年、​教壇に​立つ。​決まり​ごとの​少ない​カスタムショップを​経て​チューリングへ。​現在は​点検・整備と​車両改造を​担当。
データ収集チーム
渡部 匠 Takumi Watanabe
自動車整備の​専門学校を​卒業後、​ディーラーで​サービスメカニックを​経験。​その後は​メーカーの​車両開発に​携わり、​トランスミッションや​エンジン系の​パワーユニット、​ECUの​開発を​担当。​1日の​体験入社を​経て​チューリングへ。​現在は​点検・整備と​車両改造に​加え、​車両の​購入前の​現車確認までを​担当。

東京都大田区の平和島にあるチューリングのラボでは、常時数十台の開発車両が稼働しています。その車両の整備を中心になって担っているのが、草葉史明と渡部匠の二人です。一人はディーラーで8年を過ごしたのち、整備士を育てる専門学校の教壇に17年立ちました。もう一人はディーラーのサービスメカニックから、メーカーの車両開発へ進んでいます。二人とも、自動運転を開発してきた人ではありません。これまでの整備の何がそのまま通用し、何が新しかったのかを聞きました。

これまでのキャリア

ーーまずは、自動運転の仕事に入る前のキャリアから聞かせてください。

草葉:専門学校を卒業して、トヨタ系のディーラーで8年ほど仕事をしました。その中でトヨタ検定の1級を取ったり、自動車検査員を取ったりして、現場のリーダーという立場でやらせてもらっていました。その後、機会があって、自動車整備士を育成する専門学校の教員になりました。そこで17年、教員をやっていました。現場とは違ってすごく特殊で、「人に教える」ということなので、自分も一生懸命勉強して、分かりやすく説明できるように工夫していました。そうしているうちに、車の知識がどんどん磨かれて、色々できるようになったんです。それで「次は何か違うことをやりたいな」と思ったときに、カスタムショップに転職しました。

渡部:私は自動車整備の専門学校を卒業した後、ディーラーで数年、サービスメカニックとして働きました。その後はメーカーの車両開発に従事し、トランスミッションやエンジン系のパワーユニット、それに付随するECU関係の開発を担当していました。整備士とは違った車の触り方や、エンジンの内部単体まで触れる知識と技術は、そこで身につけてこられたと思っています。

外から見えていたものと、中で見えたもの

ーー入る前、外から見ていたときは、この仕事はどう見えていましたか?

草葉:「自動運転」という言葉がもうボンと来ちゃうので、難しそうだなと思っていました。でも、働いてみてからは、しっかりと分業ができているので、自分の今までの経験がしっかり活かせる仕事になっているなと。だから基礎はあった方がいいと思いますが、「自動運転の専門的な知識がないから大丈夫かな」とか、あまり心配せずに来てもらえれば大丈夫かなと思います。

渡部:私がチューリングを知ったのは、ちょっと特殊でした。前職のデータ処理を楽にしたいと思って調べていたときに、チューリングのテックブログに行き当たったんです。それがファーストタッチでした。

そこから、どういう開発をしている会社なのかを調べました。求人も一緒に覗いたら、「車両の改造、整備、点検も含めてできる方募集」と書いてあったんです。ECUや特殊改造、ハーネスの自作、制御PCのセッティングもやっていたので、これは自分にフルに活かせるなと思って応募しました。

ーー渡部さんは、入られる前に1日の体験入社もされていますね。

渡部:その日どんな作業をするのかを全くお聞きしていなかったので、すごくドキドキしながら来た1日でした(笑)。やらせていただいたのは、ある車からある車への機材の移設です。どちらの車も、触ったことがありませんでした。ただ、同じ日本車であれば、そんなに大きく枠組みが変わらないんです。どこの部品を外して、次にどこを外せば大体この辺りに配線が隠れているんじゃないか、という共通の設計になっている。そこはアタリをつけて、あとはインターネットで探しながら、手探りで作業していました。機材自体は経験のあったものだったので、特にトラブルなく行けました。

ーー現場に来てみて、印象は変わりましたか?

渡部:ここに来て初めて思ったのが、「広くて綺麗だな」と。床に大きなオイル痕がなくて、整備工場で言う3S・5S(整理・整頓・清掃・清潔・習慣化)がしっかりされているんだなと。そのいい文化は、引き継いでいけるように考えながらやっています。

草葉:私は渡部さんとはちょっと違うイメージで、「自動運転」と言ったら、もっとかしこまった、ハイテクな感じでやっているのかなと思っていたんですけど、意外と「物流倉庫なんだ」と思って、逆に親近感が湧きました(笑)。

ーー草葉さんが、自動運転の制御で走る車に初めて乗られたのは、現場に入って9か月ほど経ってからだったと伺いました。

草葉:それまでは、ここ数年でADAS(先進運転支援システム)もだいぶ良くなってきたと思うので、それをレベルアップさせたぐらいかな、という印象を抱いていました。でも、乗ってみたらびっくりですよね。20年ぐらい運転経験がある人が運転しているような、安心感がある運転だったんです。乗り終わった後は語彙力がなくなるぐらい驚いて、ずっと「すごい」しか言えなかった。

答えが降りてこない場所

ーー入る前に、「やったことがないけれど、できるかな」という不安はありましたか?

渡部:今までは、どちらかと言うと下流工程でした。上流工程で設計部隊が検討して「こうしましょう」と決まった業務が手元まで降りてきて、その中で色々検討してやる。あらかた答えが決まっている仕事が多かったんです。特に私は派遣という働き方もあったので、自分で考えるよりも、考えられた仕事が降ってくる、というイメージが強かった。

こちらに入ってからは、自分で考えないといけないことが途端に増えました。答えも自分で見つけないといけない。有識者に聞くというよりは、自分で調べて、自分で答えを見つけて、自分でやっていく。最初は、その切り替えが難しかったです。

ーー自分で調べるための材料は、揃っていましたか?

渡部:「サービスマニュアル」というものが、どの車にもあります。「この部品を外すには、この手順で」といったものが冊子になっていたり、インターネットで見られたりします。ここに無かったわけではないんですけど、あるメーカーさんのものしかなかったので。管理している団体に問い合わせて、他の車種も見られるように新しく導入できたのは、すごく良かったのかなと。配線図も見られますので。

ーー草葉さんは、日報に「特殊な作業は任せてください」と書かれていました。あれは何を指していたんですか?

草葉:実はあれ、私の中で結構狙って書いた言葉なんです。おそらく車の整備とか改造をあまり分からない人って、「こんな作業ってできるのかな」とちょっと自分で壁を作ったりしちゃうと思うんで。だったら、もう「何でも任せてくださいよ!」みたいなのを一旦投げてみるかと。そうすればみんな頼みやすいかなと思って、投げたんですよ。

そうしたら、その後やっぱり聞いてくれる人も増えたような気はしますけどね。自分でハードルを上げたというか、下げたというか、壁を取ったというか。

ーー逆に、原因が分からない不具合に当たったときは、どこから手をつけますか?

草葉:現場でもよく「もうこれは分からない」みたいなのはあるんですけど、まずは「話すことが大切」かなと。人から何かおかしいと言われたときは特にそうなんですけど、「何がおかしいの?」というのをこっちも把握しないと、原因まで絶対にたどり着けないんで。いろんな人と話をしながら原因を突き止めていく。実際、話をすることで解決したことは何個かありました。

1日の仕事の流れ

ーー普段の1日の流れを教えてください。

草葉:基本は、開発のチームから「やりたいこと」の相談があり、それをこなしていくのが我々の仕事です。それにプラスして、常にデータ収集で車が動いているので、そこで何かトラブルがあったものに即対応できるようにしておく。

渡部:私のスタートは、部品を揃えるところからです。ここは部品も自分たちで選定して揃えるところが多いので、忘れないうちに発注をかけて、今後の必要物を考えて申請を出します。その後、今日の計画を草葉さんとざっと話して、1日の流れを把握します。

点検類がある日は、ドライバーさんが車をスタートさせる時間までに、という目安を作って先にやってしまいます。出発時間が決まっているので、その前に、何かが外れてしまったとか、簡単に直してほしい、といった簡易トラブルにも対応する。その後に、車両架装のような、手番の長い作業を1日通してやっていきます。

ーー渡部さんは、車を買いに行くところから関わっていると伺いました。

渡部:車選びにも諸条件があります。他のOEMメーカーさんと一緒にやっていることもあるので、年式や仕様、このオプションの車が必要だ、という要件提示があるんです。その中から、行ける範囲で見に行く車を選定します。探すのに、まず数日。

現車確認の内容は、中古車店やディーラーさんが下取り車をお客様から購入するのと似ています。外面、内面、汚れや凹み、錆をチェックして、あとは「記録簿」と呼ばれるメンテナンスノートから、今までどんな修理をして、どんなところで使っていたのかを想像していく。

中古車は試乗が難しいんです。本当は走って足回りやエンジン回りの音を聞きたいんですけど、なかなかできないので、エンジンをかけて変な音がしていないかを見る。車の下を覗き込んで、雪道や沿岸で使われた車に出る錆を確かめる。最後にお店の方と話をして、その車をどういう認識で購入されたのかを聞きます。第三者機関の評価シートを用意してくれているお店もあるので、それも見ながら最終チェックをします。

車を見つけて買いに行くところまでで1週間ぐらいです。中古車と言っても数百万円の商品ですので、その中で上長の意思決定までがめちゃくちゃ早いのは、驚愕すべきポイントかなと思っています。

これまでの経験が、そのまま通用する場所

ーー前の職場でやってきたことが、そのまま通用したのはどこですか?

草葉:まず、自動運転させるために安全というのが一番なので、ディーラーとかで仕事をしてきた経験がある人であれば「点検」の部分ですね。点検をちゃんとやらないと、ドライバーの人も安心して乗っていただけないので、そこが非常に重要なのかなと感じます。

渡部:点検関係は、ディーラーでお客様からお車を預かってしていた仕事がすごく経験として活きているのかなと。1年点検のときにお客様へ提案させていただく交換部品は、ある程度型として決まっているんです。「この頃にこれを変えておけば安心になりますよ」という部品がある。このタイミングでこれを変えておけば、次の点検までに消耗しきることはないな、という目線で点検をしています。

あとは前職でエンジンハーネスの自作や加工をしていたので、いま計測器を搭載する際の電源の引き回しに活きています。それを極力、外から見えないように隠していく。ドライバーさんやエンジニアさんが車内で作業されているときに、足を引っ掛けないように。それに、外からパッと見て配線ばかり張ってあると、「なんだこの車」となって、いまだとSNSに上げられてしまう。そこも隠しつつ、という技術です。

ーーものすごく特殊なことをしてるというよりは、多少の応用はあるかもしれないけれど、基礎が大切ということですかね。

草葉:そうですね。「点検に関する知識や感覚」は仕事に向き合っていれば身についてくるものなので。普段から現場でしっかりとやっている人だったら大丈夫じゃないかなと思います。

自分たちで手を入れた車が走り出す瞬間

ーーお互いの仕事を見ていて、「これは自分にはできない」と思うところはありますか?

草葉:渡部さんは、インタビュー中もそうだと思うんですけど、すごい心配性なんで(笑)。僕は逆に「いや、もうダメだったら帰ってくるよ」みたいな。その辺が全く違うので、僕がポカをやっちゃったと思ったときに渡部さんが見ててくれる。すごく助かってますね。補い合える関係です。

渡部:ありがたいと思っています。点検や整備系の技術は草葉さんのほうが経験年数が長いので、私が思いつかない修理方法をご存知なのがすごく安心できます。勝手に師匠みたいに思っているんですけども(笑)。

逆に、私は整備の歴が短くて、ちょっと違う車の関わり方をしてきました。だから助かるのは、草葉さんがカスタムショップで経験されてきたところです。例えばカメラを取り付けるための穴開けの位置出しですね。私は決まったところに穴を開けるやり方が多かったので、自分で位置を決めるのがなかなか優柔不断なんです(笑)。そこを草葉さんが「ここでやった方がいいんじゃないか」「ここに取り付けちゃうと、法律的にグレーなところが発生しちゃうかもしれない」と、経験に裏打ちされたアドバイスをくださるんです。

ーーソフトウェアのエンジニアと話すときに、使う言葉が違うということはありますか?

渡部:ありますね。ソフト開発のエンジニアさんたちと僕たちとで、同じ車のことを喋っていても、ちょっと「言語」が違ってくる。同じことを言いたいのに単語が違う。噛み合わせが悪いときに草葉さんへ相談すると「こう伝えた方がいいんじゃないか」と教えてくださるので、いつも勉強させてもらっています。

草葉:私を褒める話になってますよ(笑)。

ーー自分たちで手を入れた車が走り出す瞬間は、どんな感じですか?

草葉:愛着はあると思います。最近だとやっぱり30号車ですね。私と渡部さんが中心になって2人で作った車で、いま一緒に仕事をしているので、一番思い出に残ってます。走り出すときは「気をつけてね」みたいな(笑)。

渡部:私も同じで、その30号車と呼ばれるアルファードが印象に残っています。事前に「せっかく綺麗に作るんだったら、配線をこうしましょうよ」と話し合って、計画を立ててやれたのが良かったかなと。外注先で改造してもらうのではなく、1から最後までここでやり切りましたので。

今までいろんな方が携わっていて、「ここをこういう風に触った」という記録が全ては残っていない状態だったので、その辺りが難しかった反面、楽しかったのかなと。過去の資料の中から自分たちで断片を探して、「ここをこうしたら合っているんじゃないか」だとか、他の車両と比較して「こういう風に配線が取り回してあるんで、これはこうしたかったのかな」というところを、答えを見つけながらやっていました。

走り出すまで、大体1週間ぐらいでできたかと思うんですけど。動き出しまでの期間が短かったのが、同時に大変だったところです。

ただ、私はちょっとビビリなところがあるので、車が走り出したところは、嬉しさ半分、不安半分というのが実際でした。短期間に理想的にできたのがすごく嬉しかった部分が半分で、あとは「あそこちゃんとネジ締めたっけ?」「ここちゃんと処理したよね?」「あそこちゃんと繋いだよね?」みたいなのが半分です(笑)。

草葉:不安は、あった方がいいと思います。その方がいい仕事、整備としてはいい仕事ができるかなと。

求める人と、最初にお願いしたいこと

ーーそんな仕事だからこそ、どんな人に来てほしいですか?

草葉:私が思う、チューリングにフィットする人は、自動車整備の基礎知識は持っていてほしいなと。それにプラスして、電装品関係の取り付けは、ある程度できるという自信を持っている。多分、この2つぐらいがあれば大丈夫だと思います。「自動運転」という言葉があるので、ちょっと敷居が高く感じる人もいると思うんですけど、それは気にせずに、1回、体験入社とかに来てもらえればいいんじゃないかなと思います。強いて言えば、ポジティブ! ポジティブな人がいいですね。

渡部:草葉さんと一部被ってしまうんですけど、データ収集をして、ドライバーさんに安全に走っていただくというのが念頭にあるので、やっぱり点検であるとか、整備の基礎知識ですね。可能であれば、整備士を持っていらっしゃる方のほうが手を上げやすいのかなとは思っております。同じく「自動運転」という言葉が枕詞に付いちゃってるんですけど、実際に中で仕事をしていると、どちらかというと今までの整備士の知識のほうが強いのかなと感じています。整備士としてやってこられた方は、自信を持って参加していただけるのかなと思っております。

その中でやっぱり、「車両改造」であるとか、「答えのない、正解のない仕事」が結構多いので、そういった部分を楽しめる方。私はぐるぐる色々考えちゃうタイプなんですけど、そういう中で「自分でこうしたらいい」「こうできたらいいんじゃないか」と、すぐに答えを決められる方は、仕事としてすごく楽しめるのかなと思っています。

ーーエンジニアの方も、自動運転の開発経験があって入ってくるわけではないんですよね。

渡部:ほとんどないですね。エンジニアさんも自動運転ではなくて、データの統計学だったり、プログラムを組むAIエンジニアだったりします。AIと自動運転って厳密に言うと別物じゃないですか。スペシャリストがいっぱい集まっているところなのでちょっとビビるのは事実なんですけども(笑)。でも、そういった中でもコミュニケーションを取っていける方は、もっと楽しめるんじゃないかなと思っています。

ーー来てくださった方には、まずどんなことをお願いしたいですか?

草葉:いま、絶対的に人手が足りてないので、やりたいことがちょっと遅れていく、というのが常態化しています。ですので、まずは普段ドライバーさんが安心して乗ってもらえるように、点検・メンテナンスの仕事を中心にやっていただくことになるかと思います。慣れてきたら私や渡部さんの仕事も任せながら一緒に色々やっていきたいですね。

渡部:私も一緒で、点検や簡易な車両修理といったところからスタートをお願いしたいかなと。整備工場やディーラーでお客様と色々やって、故障探求もやっている。5年目前後以降、仕事の早いところだと3年とか。その辺りの経験をされた方が一番手を上げやすいのかなと思っております。

プラスアルファとして、「車両改造」と計測機器類の搭載があります。ドラレコやスピーカーを付ける「架装」は、整備工場だと自分たちでやることが多いので、そういうところを経験されている方だと、なおありがたい。あとは、記録を残す仕事も嫌いじゃない人ですね。「配線図をちゃんと書いて残しておこう」というのができる人だと、僕たちも助かります。

ーー最後に、一言ずつお願いします。

草葉:私が早く自動運転に乗って移動したいなと思って、いま仕事をしているんで。そういう風に思っている人が来てくれた方が、目的が一致して仕事が進みやすいんじゃないかなって思います。私も運転は好きなんですけど、「自動運転で楽したいな」っていまは思ってます(笑)。安全のためにも、そう思います。

渡部:やっぱり「車が好き」という方には、ぜひ応募していただきたいですね。愛着があれば、「こういうパーツを入れてみたい」とか、改造じゃなくても「こうやって走ったら燃費が伸びるんじゃないか」って、色々考えると思うんですよね。その中で知識がついてくる。

まず第1段階で「車が好き」で、第2段階が整備士。あるいは整備士じゃなくても、自動車会社や、僕みたいな派遣も含めて自動車のOEM開発の現場を経験した人にも、ぜひ応募していただければと思っております。「自動運転」という言葉にビビりがちなところはあるんですけど、蓋を開けてみれば、細かいところからやることはたくさんあるので。

おわりに

整備の現場でやってきた方であれば、ここまで出てきた仕事の多くは、すでに手の中にあるものだと思います。1年点検で交換部品を選ぶ目。記録簿から車の来歴を読む感覚。配線を見えないところへ通す手つき。平和島のラボで使われているのは、その延長線上にある技術です。草葉さんも渡部さんも、自動運転の開発経験を持たないままここへ来ました。それでも、二人が仕上げた自動運転車両は道に出ています。

採用情報

チューリングでは、開発車両のメカニックを募集しています。ディーラーや整備工場で経験を積まれた方、架装や電装の現場にいらっしゃる方、メーカーで実験や評価をされてきた方、「自動運転」という言葉で迷っているなら、まずは是非、求人ページをのぞいてみてください。

Turing TechTalk#44 車載の制約下で成立させる自動運転 ─ E/Eアーキと統合設計

この記事に登場する人
CTO
山口 祐 Yu Yamaguchi
産業技術総合研究所 研究員/米国NIST客員研究員として研究する傍ら、独自にゲームAIの深層学習の開発を開始。日本の囲碁AIプロジェクトの開発代表として、最大1100GPUの並列分散強化学習を設計・開発し、世界大会準優勝、将棋AIでも世界大会優勝などの実績がある。HEROZ株式会社 執行役員を経て、2022年、チューリングに創業メンバーとして参画。2024年8月、CTO就任。基盤AIチームマネージャー兼任。
Driving System 2チーム シニアエンジニア
山岡 龍之 Tatsuyuki Yamaoka
社会人1社目のトヨタ自動車グループの特装車メーカーで、モータースポーツ用レーシングカーや特装車のワイヤーハーネス設計を担当。日産自動車で量産車のハーネス設計・評価を経験したのち、自動運転トラックを開発するT2でハーネス・電装品の設計から運用までを担当し、チューリングへ。現在は、電気ハーネスや電源設計から構造・物理的なインテグレーションまで、車両側適合(ハードウェア適合)を一貫してリードしている。

はじめに

完全自動運転AIを開発することと、それを実際の市販車に載せて安全に走らせることの間には、大きな隔たりがあります。市販車にはすでに完成された通信規格や安全機構、電源システムが存在しており、そこに新しいシステムを違和感なく統合する電気・電子的な設計力が欠かせません。ベース車両が持つ物理的・電気的な制約をいかに乗り越えるかが、量産車を自動運転車に仕立てるうえで大きな技術的課題になっています。

今回のTech Talkでは、CTOの山口と、Driving System2チームでシニアエンジニアを務める山岡が登壇。CANバス解析、車検基準に適合させる物理実装、独立電源設計、フェールセーフ機構、車両適合の開発プロセスまで、市販車を自動運転車へと仕立て上げる技術を詳しく紹介しました。

※本記事は「Turing Tech Talk #44」の内容をもとに、一部編集のうえお届けします。

自動運転を車に載せるための「E/Eアーキテクチャ」とは

山口:そもそもこのE/Eアーキっていうのは、聞いたことのない人も多いかなと思うんですけれども、E/Eって何か教えてもらえますか。

山岡:Electrical/Electronicという意味で、略し方はいくつかあります。自動車を開発・設計するときには、たくさんのコンピューターが乗っていて、センサーや、椅子が動いたり、カーナビが動いたりする電気のものが車内にたくさん搭載されています。それらをどう繋いでいくかというところが、一般に「E/Eアーキ(電気/電子アーキテクチャ)」と呼ばれています。今、後ろに見えている車も自動運転にしているので、それに対してさらにチューリングとしての機構を上乗せしています。

山口:なるほど、よくわかりました。これ、日本語で言うと電気電子ですか。

山岡:電気電子ですかね。

山口:自動車や製造業にいないと、電気とは何か、電子とは何かというのはあまりピンとこないと思うんですが、これ電気と電子は、車の文脈としては違うものですよね。

山岡:そうですね。基本的には電気、バッテリーがあって、電源をつないで、スイッチが動く。それに対して電子というのは、マイコンが入ってきたり、ソフトウェアの話が入ってくる領域です。

山口:例えば自動運転の車両で言うと、車両とセンサーとで通信するような、信号のやり取りみたいなところですね。

山岡:そうですね。ただ、そこの境界は最近薄れてきていて、結局セットで論じる必要があります。

山口:なので、電気電子はセットという風にまとめられて、1つの単語として使われることが多いんですね。よくわかりました。

チューリングは、中古市場での流通量が豊富で状態の良い車両を安定的に調達できる「30系後期型アルファード ハイブリッド」(トヨタ自動車)をベース車両に採用しています。市販車は当然ながら自動運転を想定して設計されていないため、独自のカメラ(フロント3台・サイド4台・リア1台の計8台)や車載計算機「NVIDIA Jetson Orin」、ルーフのGNSS(Global Navigation Satellite System:全球測位衛星システム)などを追加し、既存の車両システムと安全に協調するようE/Eアーキテクチャを上乗せ・統合設計する必要があります。

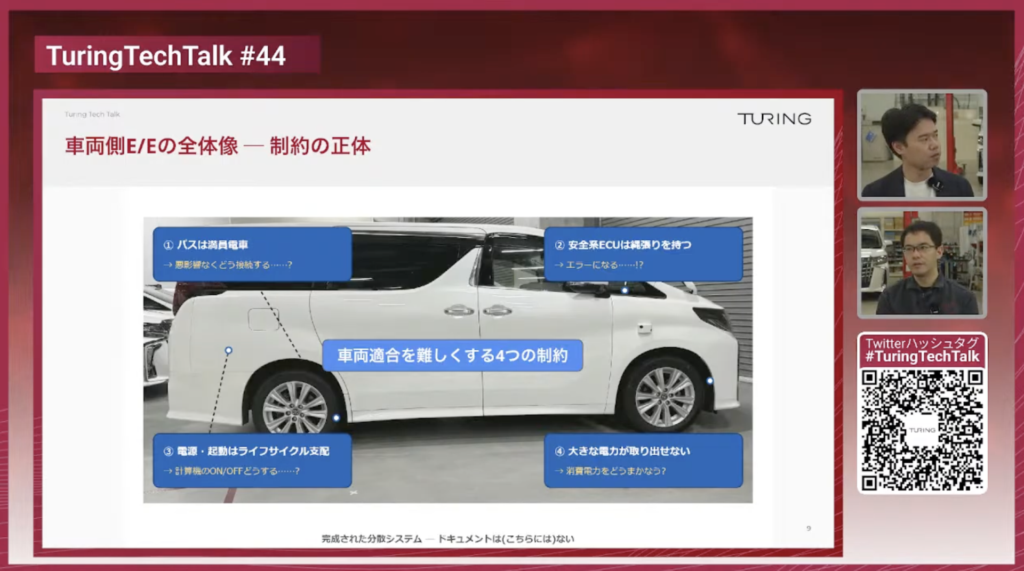
自動車は1台で完結した完成度の高い工業製品であり、自動運転システムを追加するには、車両に存在する4つの強力な制約を乗り越えなければなりません。1個目が「バスは満員電車」というものです。

山口:バスは満員電車?

山岡:バスというのは、CANバスのことです。CANバスを略してみんなバス、バスと呼ぶので、少しややこしいんですが。

山口:なるほど、混乱しますね。バスなのに電車みたいで。

山口:ここでいうバスは、通信の流れる経路のことですね。

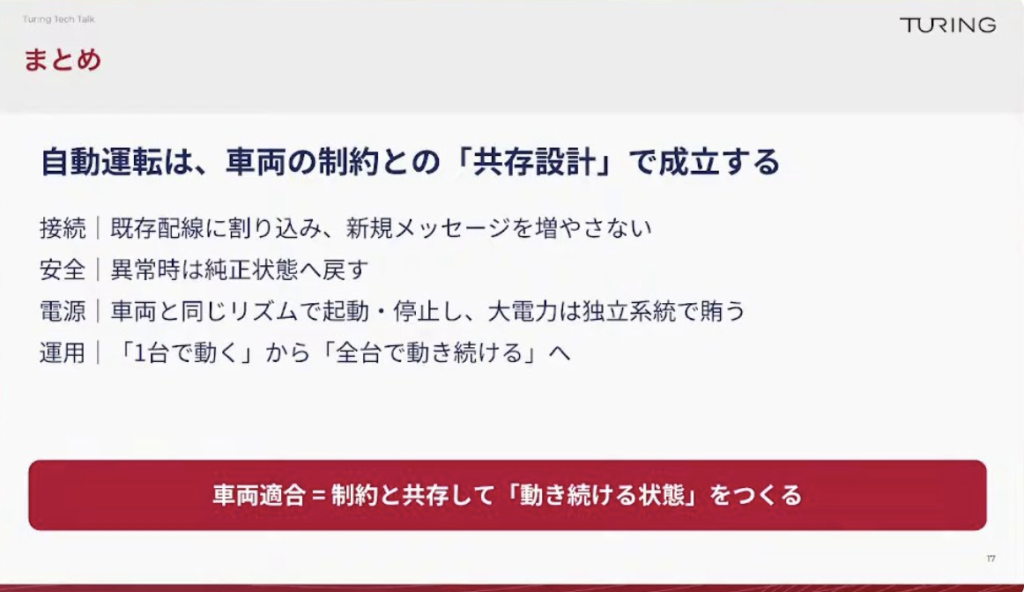
山岡:車の中ではさまざまなECU同士がすでに通信していますから、そこにチューリング側から追加・書き換えの形で信号を送ると、単純に割り込ませてしまうだけでは既存システムに悪影響を及ぼしかねません。そこをどう上手く繋ぎ込んでいくかが1つ目の制約です。

2つ目は「安全系ECUは縄張りを持つ」です。各自動車メーカーは車両の安全機能に相応のセーフティを設けており、外部から単純に信号を書き換えるだけでは、車はすぐに異常と判定してしまいます。手を加えても異常にならないように、エラーを起こさせない繋ぎ込みが必要になってきます。

3つ目は「電源・起動はライフサイクル支配」です。僕らが普段乗る車は、鍵を持って乗り込み、エンジンをかけて、使い終わったらまた鍵を閉めて車を離れます。計算機の電源をどのタイミングで切るかをしっかり考えないと、急にパソコンを切るわけにはいかないので、ログがぶつ切りになってしまいます。そこを車両側と連動させてあげる必要があります。

4つ目は「大きな電力が取り出せない」こと。シガーソケットや車内コンセントでスマートフォンなどは充電できますが、AI推論を担う計算機はそれなりに電気を消費します。制御中、自動運転として推論を動かしているとより電気を使ってしまいます。それを車の電力から賄うんですが、元々車にはそんなに余裕がないので、そこをしっかり手当てしなければいけません。

山口:結構仕組みがシンプルだという話もありますが、このシンプルな仕組みだけれど、車というのは1つの完成された工業製品として、そもそも存在しているから、それに手を加えるとなると、やっぱり難しいところもあります。ポンと乗せるだけで実現できるわけではありません。

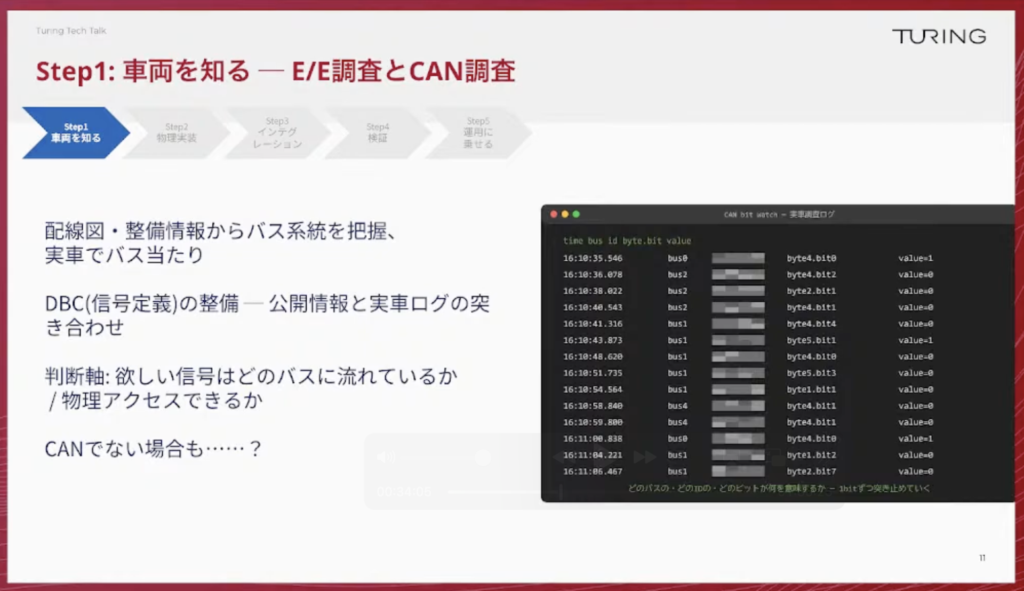
Step 1:車両を知る(CANバス解析とDBC定義)

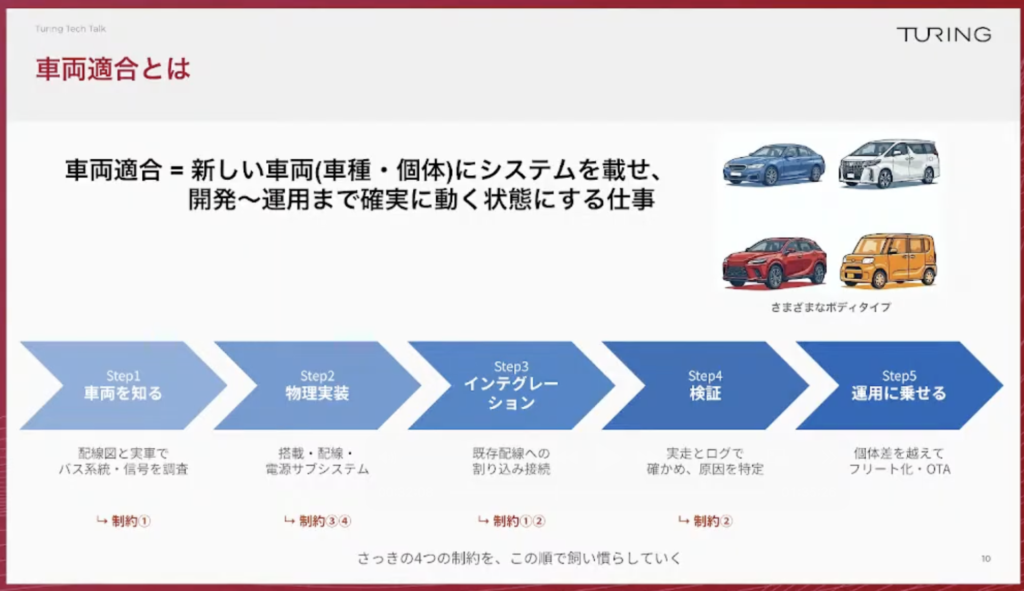
チューリングの開発拠点は、東京都大田区の平和島。物流センターの一角にある広大な拠点は、社内で「ラボ」と呼ばれ、常時30台を超える開発車両(開発フリート)が稼働しています。この場所で、車両をゼロから自動運転車に仕立て上げていくプロセスを、チューリングでは「車両適合(ビークル・アダプテーション)」と呼び、5つのステップに体系化しています。

山口:山岡さんは普段ここで作業されてたりするんですか。

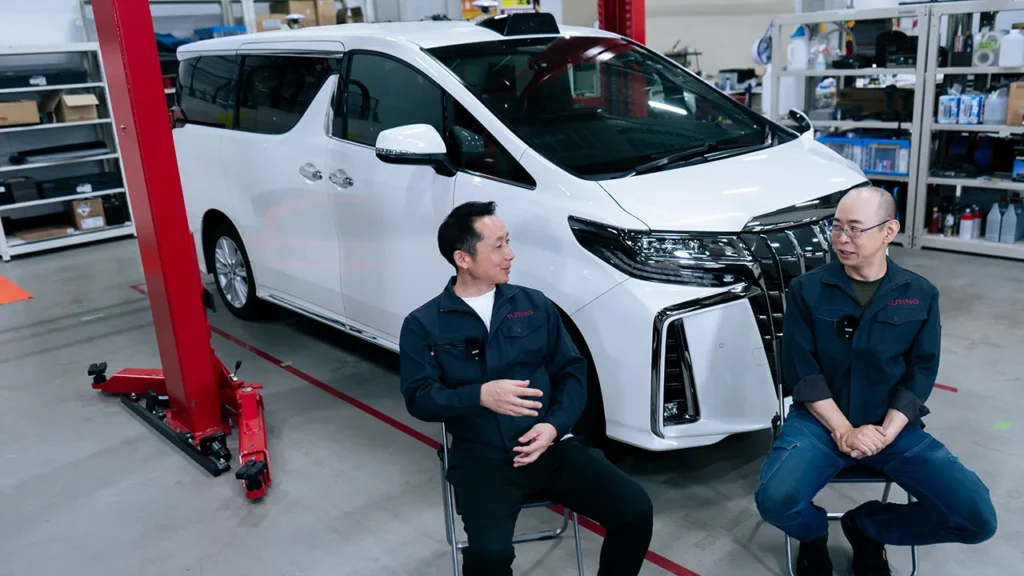
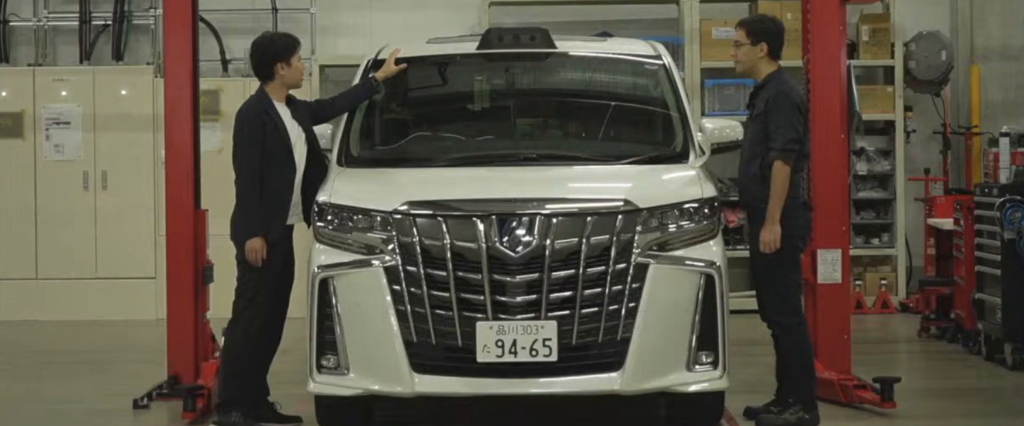
山岡:そうですね。棚があって、工具類や予備部品をストックしています。ドライバーがデータ収集で走ってくれている分、定期的なメンテナンスも必要になるので、大きな2柱リフトも置いてあります。

山口:この赤い柱みたいなやつは一体何なんですか。

山岡:2柱リフトと呼ばれるもので、2つの柱で車を持ち上げる装置です。上が繋がっているので門型と呼んだりもします。

山口:自動車整備工場で車の下に入って作業するのと同じように、我々も車を釣り上げて下に入って作業する、そのための装置なんですね。新しい車に適用することも多いと思いますが、大体何台ぐらい今あるんですか。

山岡:今30台超です。そのくらいの車両を新しく仕立てたり、調子が悪くなったらメンテナンスしたりしています。

ベース車両にアクセスする最初の一歩は、情報の公開度が低い車内通信(CAN:Controller Area Network)の解読です。一般公開されている配線図や整備情報を読み解きながら、物理的にアクセス可能な通信ポートを探すところから始まります。

山岡:通信定義書(DBC:CANバスの通信定義ファイル)を自社で作成していくんですが、非公開の情報がほとんどなので、公開情報や実車のログを付き合わせて解析します。アクセルを踏んだ時にどういう信号が流れるか、ハンドルを切った時にどういう信号が流れるかを試すと、大体どういう時にどういう信号が流れるかは当たりがつきます。シートベルトを外す、ウインカーを出す、窓を開けるといった操作も一通り試して、そこから信号を推定していきます。ひたすら16進数のログを並べて、この辺りにきっとあるはず、と当たりをつけていくような作業で、一概にこういうセオリーがあるとは言えないんですが、経験でエスパーのようにできる人も世の中にはいます。

山口:このCANの信号の定義は、メーカーによっても車種によっても違いますし、同じ車種でもモデルチェンジがあるとまるで変わってしまう。1台1台違うけれど、同じメーカーや兄弟車種だと似ている傾向があるので、その辺りの経験がものを言うんですね。

国産車の多くはCANが使われていますが、車種によってはLIN(Local Interconnect Network)や車載イーサネットなど、別のプロトコルが使われる場合もあります。

Step 2-1:物理実装(車検・保安基準をクリアする構造設計)

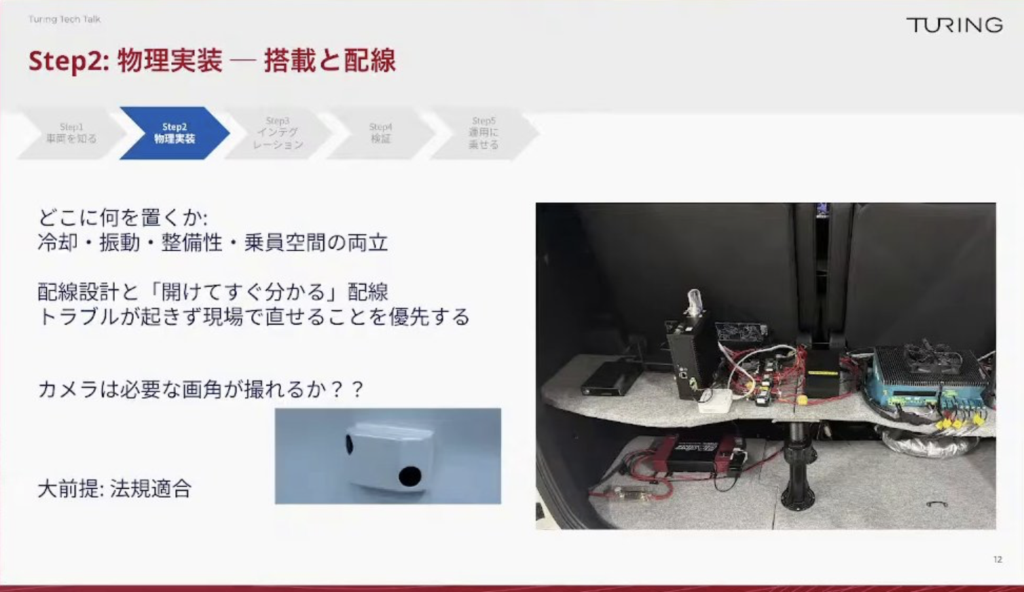
山岡:車載計算機やカメラ、センサーなどの物理的な配置を設計します。アルファードの場合、3列目シートの後方に格納スペースを設け、計算機や冷却ファン、電源ユニットをインテグレーションしています。配線設計は、開けてすぐわかる、というのを今は大事にしています。正直、自分の中ではもっともっと隠したい、もっと綺麗に配線できたらと思っているんですが、開発スケジュールとの兼ね合いでそこまではできていません。

山口:え、そうなんですか。私はめちゃくちゃ隠れていると思っていたんですが。

山岡:いや、自分の中ではもっともっと隠したくて、パッと見は何もない、というのが理想です。

山口:今でもほとんど配線は気にならない、というかほとんど見えないところにあるので、うまく隠しているのかなと思っていました。まだ改善したい途中ということなんですね。

山岡:カメラの取り付けでは、必要な画角(FOV:Field of View)が取れるかが最も重要なポイントになります。ラピッドプロトタイピングで実物を作って確認することもあれば、シミュレーション上で検討することもあります。そして何より、ナンバープレートを取得して公道を走らなければならない以上、保安基準への適合が大前提です。

山口:車幅や高さの制限もありますし、フロントガラスにカメラをつける場合も「ガラス上部20%以内」というように、つけられる場所が決まっていますよね。意外と車は簡単に改造できるように見えて、実はがんじがらめの規制がある。

山岡:ギリギリのところで、そもそも車という製品自体がそう作られているので、そこにさらに手を加えるとなると、より気を配らないといけません。

山口:車のケーブルも、車って意外と広いから、普通のケーブルの長さだと足りませんよね。

山岡:そうですね。前から後ろに引き回すとなると5メートルは絶対に必要です。

山口:アルファードは全長がそもそも5メートルを超えるので、5〜10メートル級のケーブルを引き回すことになりますね。身近なUSBのような規格だと10メートルではかなり厳しくなってくるので、カメラの映像伝送には、比較的長距離でも遅延や帯域幅の制約が少ない「GMSL2(Gigabit Multimedia Serial Link 2)」という車載向けの規格を使っています。

Step 2-2:電源設計(車両電源に依存しない独立制御)

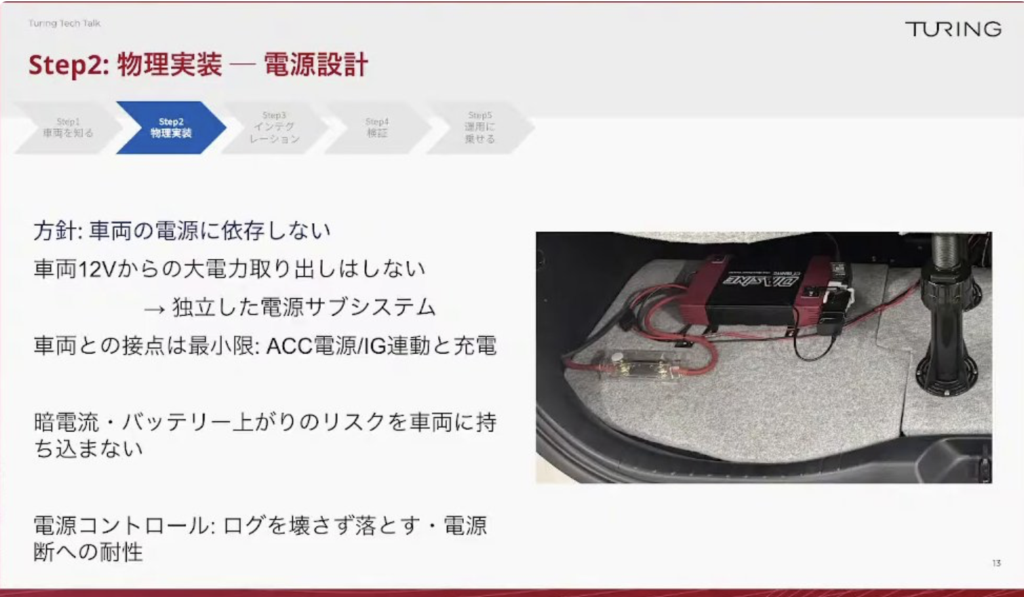
山岡:今の方針としては、車両の電源に依存しないようにしています。車によって取り出せる電気の余裕は本当にマチマチで、ギリギリの車もあるので、大電流はあまり取り出さず、サブバッテリーを乗せて、追加のシステムはそこから電力を賄うようにしています。走行中に車両側から少しずつ充電させてもらう形です。

山口:もう少しベースのところから聞きたいんですが、そもそも車の電気は、ガソリン車で言うとオルタネーター(発電機)で発電した電気を、鉛蓄電池に貯めていますよね。

山岡:そうですね、基本的には。

山口:鉛蓄電池の起電力は12V。これがハイブリッドやEVになると、また別の系統の電源がありますよね。この場合は大体何ボルトぐらいなんですか。

山岡:車両にもよりますが、600V程度になります。

山口:普通に触れるとかなり危険な電圧域で、12Vならちょっと感電するくらいで済みますが、車の動力そのものになる電力は非常に危ないので、そこは明確に分けられています。これ結構大事なポイントですよね。車の12V系にそのまま頼ると、バッテリー上がりの心配もありますし、電圧の変動も計算機にはあまり良くない。安定したサブバッテリーがあれば、そのあたりの問題もクリアできるということですね。

山岡:車両を使用していない間も消費される暗電流についてですが、チューリングのシステムを上乗せする分もこの暗電流のリスクになるため、専用の電源コントローラーで管理し、車両側に負担を持ち込まない設計にしています。この独立電源管理により、ドライバーは特別な操作を必要とせず、通常どおりキーをひねる(あるいはボタンを押す)だけで自動運転システムが安全に立ち上がり、キーを切れば自動で安全なシャットダウンが行われる運用を実現しています。

Step 3:繋ぎ込み(インテグレーションと純正状態への物理復帰)

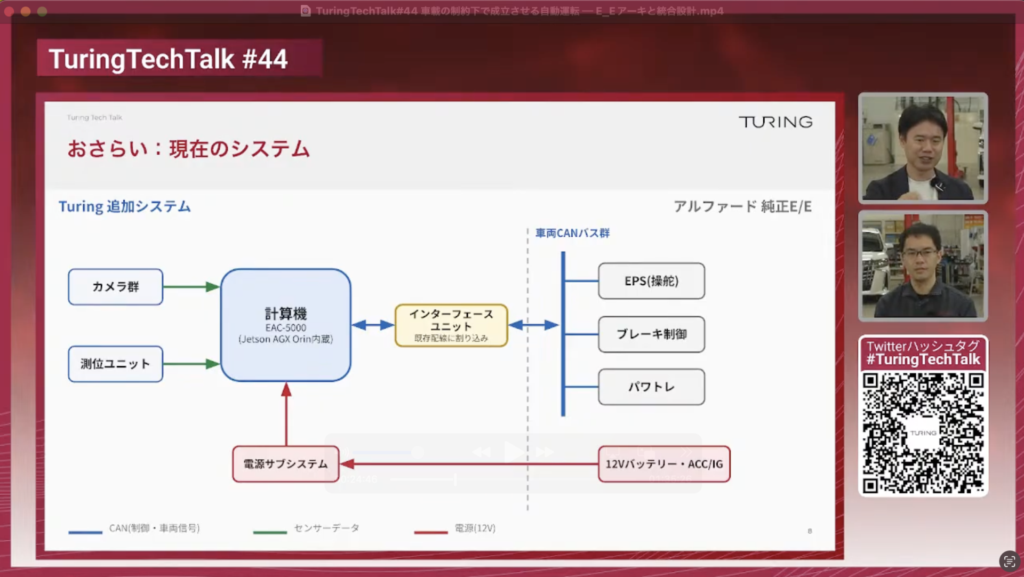
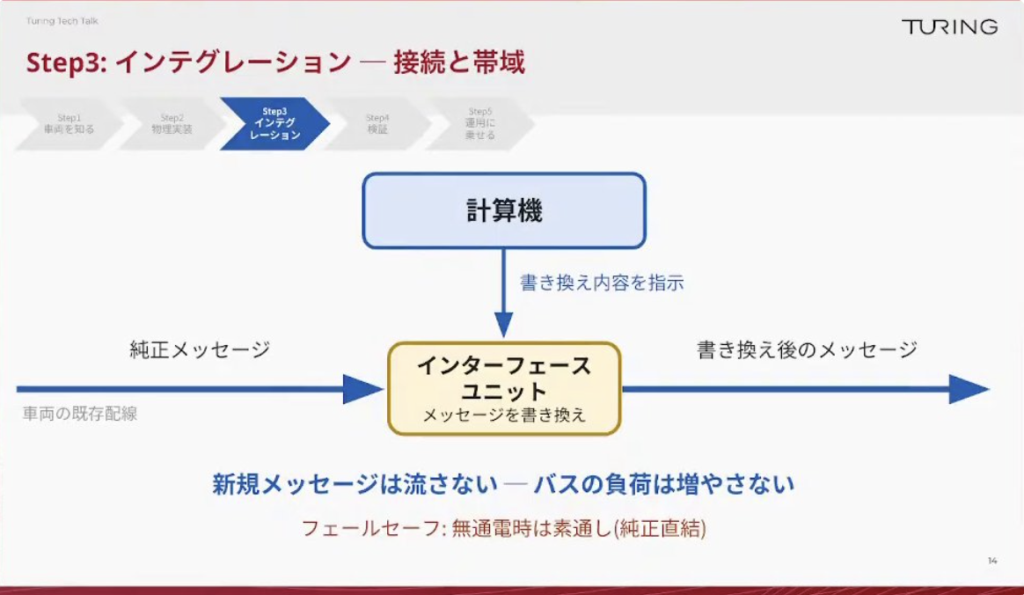
山岡:概念としては、純正で元々流れているメッセージに対して、我々のインターフェースユニットを介して、計算機で計算した結果を合算する形で、他の純正システムに影響が出ないよう要求を伝えて、再送信しています。書き換えている、というのが正しい表現だと思います。新規のメッセージを純正側に追加することはしていないので、バスに負荷がかかることもありません。

万が一、計算機がハングアップした場合や、ドライバーが緊急停止ボタンを押した場合には、物理的・システム的に一瞬で純正状態の配線へ復帰させるフェールセーフの仕組みを設けており、安全性を最優先にした設計になっています。

山口:ハンドルをどのくらい切るか、アクセルやブレーキをどのくらい踏むか、指示しなければいけない項目はそんなに多くないけれど、そこはどうしても書き換えが必要になるんですね。

山岡:はい。ただ単純に書き換えてしまうと、純正のアーキテクチャが監視しているのでエラーになってしまいます。そこも不整合が出ないように、再計算した上で再送信しています。

山口:なるほど。だから車としては、自分はすごく正常だとずっと思っていて、元々設計された通りに動いていると認識しているけれど、実は裏では我々の計算機がちょっとだけ信号を書き換えている。車が元々持っている監視の仕組みにうまく乗っかっているから、異常な動きをしないというリミッターも、車が本来持っているものをそのまま活かせるわけですね。

Step 4:検証とトラブルシュート(内製ウェブ解析ツールの威力)

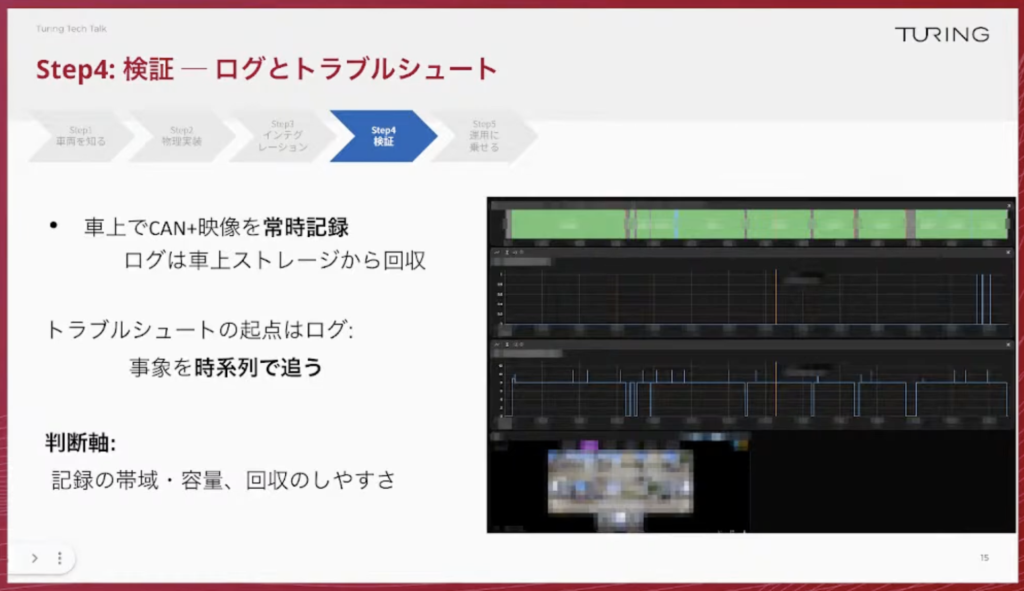
山岡:実車適合を施した車両の検証には、すべて内製で開発したブラウザベースのログ解析プラットフォームを活用しています。車載SSDに記録された大容量のCANデータ、時系列のカメラ映像、GNSSの位置ログが、クラウド経由で自動的にアップロードされる仕組みです。

山口:このデータを集める仕組みも解析ツールも、基本的に全部内製しています。見たい項目だけを抽出して、どのタイミングでログがおかしくなったとか、変な異常値やエラーが出ているかというところを時系列で確認しながら、大体ここがおかしかったんだな、と当たりがつきます。

このツール、私もあまり知らなかったんですが、どんどん洗練されていっているんですね。ハードウェアのところがソフトウェアでちゃんとサポートされているという。

山岡:ハードウェアエンジニアはブラウザ上でこれらのデータを1枚のタイムライン上で同期させて視覚的に比較できるため、どの瞬間に、どのECUから、どのような異常値が出たかを即座に特定・修正する高速なトラブルシュートが可能になっています。

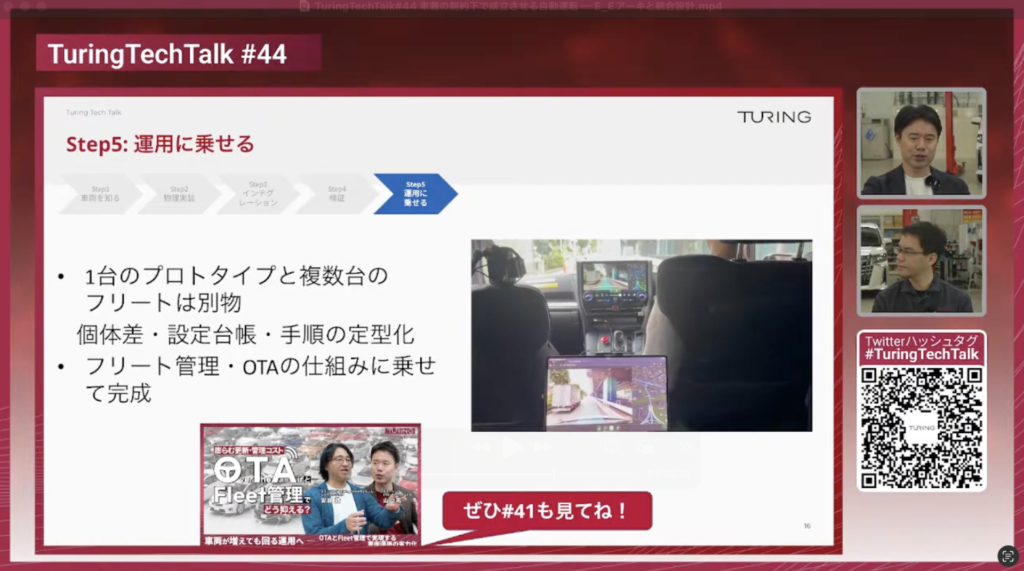
検証を終えた車両は、最初の1台のプロトタイプから量産フェーズへと移っていきます。車両が30台規模になると、個体差や設定台帳・手順をある程度標準化する必要が生じるため、OTA(Over The Air:無線通信によるソフトウェアの遠隔更新)とフリート管理の仕組みも内製で運用しています。

山口:デモンストレーション用に配線まで綺麗に仕上げた車両では、自動運転モデルが計算した走行軌跡や、カーナビ上で指定した目的地まで車線変更・右左折を交えて自動走行する様子を、車内モニターでリアルタイムに確認できます。東京都内では、この仕組みによってすでに広い範囲を自動走行できる体制が整っていますね。

「Less is More」を貫くシンプルな設計思想

山口:結構このドライバーの方も、エンジニアも、立ち上げの手順を一つひとつ意識しなければいけないと、やっぱり運用が大変ですよね。今は一旦とりあえずイグニッションを入れて、ボタンをポチっとやったら後は勝手に動きます、という状態になっているので、それを意識せずに使えるようになっています。

山岡:ドライバーは運転に集中できますし、エンジニアも開発に集中できます。これができるのも、結局チューリングの基本概念である「Less is More」があって、サブシステムもセンサー構成も少なくしているからこそ成り立っている話ですよね。

山口:複雑さを排除する方が、結局は良くなるという考え方をチューリングはすごく取っています。センサーも少ないです。例えばLiDARセンサーをつけた方が自動運転には役立つでしょ、とよく言われますけど、なくてもできるんだったらそっちの方がいいですし、エンジニアとしてはいろんなコンポーネントを加えたくなりますが、できるだけシンプルに保つのが重要です。ハードウェアもソフトウェアも世の中どんどん進歩していきますし、AIも当然そうですが、そのシンプルな構成にうまく乗っていくには、シンプルである方が恩恵を受けやすい、という話もあります。この辺りの思想が徹底しているかなと思います。

山岡さんに聞きたいのは、車1台仕立てるのにどのくらいの時間がかかるか、ということです。このアルファードが全く新規の状態で来て、必要なパーツは揃っている場合、大体どのくらいで仕立て上がるんですか。

山岡:大体目標としては3ヶ月以内に運用に回るようにしています。解析などで1、2ヶ月、最後にログを回して解析して不具合を潰して運用に乗せるまでで1ヶ月、計3ヶ月で、大体今達成できているかなと思います。

山口:相当早いですね。これが例えば、今あるアルファードではなく、セダンタイプで、メーカーも違う車が来ました、という場合はどうですか。

山岡:車が来てから大体3ヶ月ぐらいで運用に回す、というのが今の目標というか実績としてはあります。

山口:そんなに早いんですか。このアルファードを仕立てるのは3ヶ月ではなくて?

山岡:そうです。このアルファードはもう物があって、繋ぐものの設計も終わっているので、1週間ぐらいで、全くゼロの状態から動く状態になります。

山口:設計をゼロから、今日のステップ1から5までいかないといけないところは大体3ヶ月あればできる、ということですね。

山岡:このハードウェア適合を担うチームは、ハードウェア専任のエンジニア2名と、整備士資格を持つメカニック2名という少数精鋭で運営されています。

山口:最後に聞きたいのは、自動運転のシステムを後付けして元の車両につけていく、という話をしてきましたが、将来的に我々のシステムがいろんな車に乗っていくとなった時、より統合されたE/Eアーキになっていくのかなと思っています。山岡さんが考える、自動運転に必要な機構のポイントはどのあたりですか。

山岡:業界的にトレンドがかなりあります。この後ろに映っているアルファードの世代は、アーキテクチャ的にCANなどの通信がようやく入り始めた頃で、まだまだアナログでやっていたところが多かったと思います。2026年現在の車は、ECUとしてコンピューターを分散しつつ通信で結ぶのが流行っていく中で、自動運転を最終的にやるなら、それをどこかで統合する、統合してまた枝を伸ばすというのが1つ必要になってくるのかなと思っています。カメラや電源のコントロールを外に置くことになるので、通信としては速い方ですが、そのラグでモデル制御の話が困ってしまうので、最終的にはそこは全て集約されてくるのかな、というのが今ありますね。

山口:車にはECUと呼ばれるマイコンが、普通の車でも数十、多いと100近くある車もあって、カメラを司るもの、パワーステアリングを司るもの、というように役割分担して全部分かれていて、それがお互いにCANなどで通信しているのが、いわゆる分散型のアーキテクチャです。最近はそれを集約していく、いわゆる『ゾーン型』のアーキテクチャにしていく、つまりある程度のまとまりを1つのコンポーネントとして扱い、その中で判断しつつ、バスのようなところで中央に集約していくという流れになってきています。これはSDV(Software Defined Vehicle:ソフトウェア定義車両)という言葉とも関係していて、ソフトウェアをうまく動かす、設計するというところを生かすなら、そういったアーキテクチャの方が便利ですし、自動運転という文脈でも計算パワーを多く使い、センサーの通信の遅延を抑えたい、素早くコントロールに回したい、ということを考えると、自動運転のAIもソフトウェアの一種なので、ソフトウェアデファインドビークルという考え方に近いところに自動運転の車両もなっていくのが、将来的には自然な流れかなという感じがしますね。

ということで山岡さん、今日はありがとうございます。

山岡:こちらこそ、ありがとうございました。

Q&A一覧(一部抜粋)

以降は視聴者のQ&Aに回答していきました。詳しくは動画をご覧ください。

  • 自動運転はEV(電気自動車)でなければ実現できないのか
  • 車検制度上、ソフトウェアによる信号書き換えへの対応はどうしているか
  • サイドカメラを片側1台に減らすことはできないか
  • テスラのフロントバンパー下カメラのような構成は必要か

▶ Turing Tech Talk #44 アーカイブ動画はこちら

チューリングでは、完全自動運転の技術を共に創る仲間を募集しています。今日お話ししたDriving System2チームはもちろんのこと、機械学習エンジニア、リサーチャー、ソフトウェアエンジニア、組み込みエンジニア、インフラエンジニアなど、非常に幅広いエンジニア職種で仲間を募集しています。ご興味のある方は、ぜひ採用ページをご確認ください。多様な職種がありますので、ご自身がどれに当てはまるか、ぜひチェックしてみてください。

クルマから来た人、システムから来た人。——二つのキャリアが辿り着いた「自動運転車両エンジニア」という仕事

この記事に登場する人
Driving System 2 チーム
山岡 龍之 Tatsuyuki Yamaoka
社会人1社目のトヨタ自動車グループの特装車メーカーで、モータースポーツ用レーシングカーや特装車のワイヤーハーネス設計を担当。日産自動車で量産車のハーネス設計・評価を経験したのち、自動運転トラックを開発するT2でハーネス・電装品の設計から運用までを担当し、チューリングへ。現在は新型車両の立ち上げを担当。
Driving System 1 チーム
天笠 雄三 Yuzo Amagasa
三菱電機で電力会社向け設備管理システムのSI(システムインテグレーション)を担当し、基本設計から実装、テストまでを経験。スバルでは生産管理システムのPMOとして部品表(BOM)まわりのシステム開発に携わる。その後、自動運転バスの実証実験を行う先進モビリティを経て、チューリングへ入社。現在は既存車両の運用・改善を担当。

完全自動運転を実現するAIモデルがどれだけ賢くなっても、それを載せて実際に道を走る「車両」がなければ自動運転は成立しない。そのハードウェアを担うチューリングのチームに、山岡と天笠という二人のエンジニアがいる。一人はレーシングカーの電装からキャリアを始めた「クルマ屋」、もう一人は電力会社向けの業務システム開発からキャリアを始めた「システム屋」。まったく違う場所から出発した二人に、これまでのキャリアと今の仕事について聞いた。

二人のキャリア遍歴

ーーまずは、自動運転業界に入る前のキャリアから聞かせてください。

山岡:社会人としての最初のキャリアは、トヨタ自動車の子会社である特装車メーカーで、モータースポーツで使うレーシングカーや、パトカー・救急車などの特装車の電装品、特にワイヤーハーネスの設計・製造を担当していました。働く車をだいぶやってきましたね。レーシングカーの世界は、量産車のように何年もかけて開発するのではなく、シーズンごとに車両を作り変える必要があります。イベントに車が間に合わなければ、勝負すらさせてもらえない世界でした。

その後、日産自動車で量産車のワイヤーハーネスの設計・評価をする仕事をさせてもらいました。ここでは一転して、10年以上使われることを前提にした「壊れてはいけない」設計に向き合うことになります。続いて、自動運転するトラックを開発するT2という会社で、ハーネス周りや電装品の設計・製造・運用を担当していました。同じ自動運転業界なので、今のチューリングに来てからも、車を運用するという面ですごく役に立っている経験だと思います。

天笠:私は三菱電機に新卒入社して、電力会社さんの設備管理システムをSIerとして、基本設計から実装、テストまでやっていました。次にスバルに転職して、部品表(BOM)を扱う生産管理システムのPMOというところで、システム開発を担当していました。量産の現場は独自の文化やルールがあって、最初は戸惑うことも多かったですね。自分は部品表更新という立場だったので、このままでは新しい車の開発になかなか携われないと感じていました。

その後、自動運転バスの実証実験を行う先進モビリティに転職しました。地方の公共交通は限られた予算と人手でやりくりしなければならない現場で、各地の実証実験でバスを走らせるための現地調整や、走行中に起こるトラブルへの対応を担当していました。事故ではないんですけど、色々な出来事が現地で起こるので、それに対応してきた経験が、一番チューリングに活きていると思います。新卒時代の自分からしたら、結構不思議なところにいるなと思っています。

キャリアの棚卸し——直結する経験、意外と効いた経験

ーー「あの経験がなかったら今の仕事はできていない」と思う経験はありますか?

山岡:一番大きいのはレースの経験です。イベントに車が走らなかったら、もう勝負すらさせてもらえない世界なので、何が何でも日程を間に合わせる、常にプランB、プランCを考えるという仕事の仕方は、そこで学んで今もすごく活きています。絶対にうまくいくとは限らないので、プランAを進めながらバックアップも考えて、ダメならどんどん切り替えて時間通りに仕上げる、という経験です。

天笠:私は、設計して、作って、評価してというV字サイクルを回した経験が活きています。あと、スバルでちょっと部品表をやったので、車のパーツの構成や、「アッシー」みたいな部品の呼び方は、そこで学んだ気がします。

ーー逆に、「こんなことが役立つとは」という意外な経験はありますか?

山岡:最初の会社と日産自動車の時に、シミュレーション関連の業務をサブタスクでやっていて、サーバーやLinux系の話にかなり触れていたんです。全く知らないところからじゃなかったので、その経験は今すごく助かっています。

天笠:SIer時代の経験ですね。業務システムの開発では、使うユーザーさんとも、発注者である情報システム部門とも話さなければいけません。前提を合わせないと会話が成り立たなくて、エンジニアが描く理想像とユーザーが描く理想像は本当にかけ離れていくので、そこを気にしながら進める感覚は、今の仕事でも活きています。「これはいらない」と言われた機能が、実はユーザーさんがめっちゃ欲しがっていたと後から分かることもあるので、そういう最終確認は大事だと思っています。

ーー車業界特有の言い回しには、最初から慣れていたんですか?

山岡:そんなには分からなかったです。研修で分厚い用語集や事例集を叩き込まれた経験があって、当時は「こんなの覚えられないよ」と思っていましたが、1、2年で自然と使えるようになりました。ただ、前職の専門用語をつい使ってしまって、サプライヤーさんとの打ち合わせで伝わらなかったこともあります。車業界出身者が少ない環境なので、話す前に「これは業界独自の言い回しかもしれない」と意識するようにしています。

天笠:逆に、それでポロッと伝わると、盛り上がって会話が発展したりしますよね。(笑)

ーー入社した時点で「これはやったことがないな」と感じた業務はありますか?そのキャッチアップはどうしましたか?

天笠:バスの現場では配線の繋ぎ直し程度の改造しかしていなかったんですが、チューリングで初めて車体に穴を開けるような改造をしました。最初は「本当にここに開けていいのか」とすごくドキドキしましたね。その場で教えてくれる人がいたので、2、3日で見せてもらって、「じゃあやっていいよ」となりました。失敗しても強く咎められる文化ではなくて、前向きに挑戦する分には歓迎される環境です。

山岡:僕はチューリングに合流してまだ半年ぐらいなんですが、それまでの自動運転の考え方と全然違うシステムに驚きました。チューリングはE2Eを推しているので、ハードウェア的にはすごく構成部品が少なくて、「本当にこれだけで車が走るの?」というのが最初のギャップでした。カメラ映像などのデータを収集する仕組みもすごく整理されていて、今まで触れたことのない分野だったんですが、自然と扱えるようになりました。会社が色々なAIツールの活用を推進してくれているので、忙しそうな人には聞きにくい質問でも、AIになら気にせず投げかけられて、キャッチアップの助けになっています。

ーー部品が少ないことは、現場としては嬉しいものですか?

天笠:嬉しいです。まず壊れないじゃないですか、ないってことは。設置作業もないし、配線や電気の計算も減ります。

山岡:特に電気は減らした方が嬉しいです。車はそんなに電力を追加できるようにできていないので、減った分だけ安定稼働しやすくなります。自動運転の車は計算機のパワーが性能にかなり左右されるので、電力に余裕があるだけ嬉しい。ただ、新しいことをやろうとするとどうしても機器が増えるので、できる限り減らすのを目標にして、つけて試して、いらないなら外す、というのをずっと繰り返しています。

仕事の中身——1日の流れと、車が走り出す瞬間

ーー普段の1日の流れを教えてください。

天笠:メインで使っている実験車両群を見ていて、データ収集や制御実験をしている車の日々の課題をどんどん潰していく作業です。台数が一番多いので、横展開の作業が結構手間がかかります。前日から明日空いている車を探して予定を入れて、配線の修正や機器の取り外し、原因究明などをやっています。走行中は運行が最優先なので、メンテナンスできるのはどうしても朝か夜になります。車両がまとまって戻ってくる夜の方が作業しやすいので、夜遅くまでいることが多いですね。

山岡:僕は新しい車やシステムの立ち上げをスピーディに行う役割で、既存の車にもいい影響がありそうなら天笠さんと連携して横展開していく、という役割分担です。今後は複数メーカーの車両に対応していく必要があって、メーカーによって車のアーキテクチャが違うので、その差を吸収していかないといけません。難しさでもあり、楽しさでもあります。実際に車をばらしてみると、メーカーごとの設計思想の違いに気づけるのが面白いですね。

ーー自分が手がけた車両が実際に走り出す瞬間は、どんな感覚ですか?

天笠:立ち上げた車が最初に出ていく時、社員みんなでお見送りするのが恒例になっているのですが、その様子をみんなが「良かった、良かった」と見守って送ってくれるのが嬉しいし、楽しさを感じる瞬間ですね。

山岡:作った車が最初に出ていく時は感動しますし、みんなが困っていたことを解消して良いリアクションをもらえた時は、やってよかったなと思います。ハードでやれば簡単なことをソフトが苦労していたらハードでやればいいし、逆も然りですよね。その垣根が低いのがすごくいい環境で、作る人と使う人の顔がお互いに近い。これはすごく珍しい環境だと思っているし、チューリングのいいところだと思います。

“作る人と使う人の顔が、お互いに近い。これはすごく珍しい環境だと思います。”

なぜチューリングを選んだのか

ーー数ある選択肢の中で、なぜチューリングを選んだのですか?

天笠:先進モビリティにいた時、限られたリソースの中で自動運転バスの実用化に取り組む中で、ルールベースの限界を感じていました。自動運転を実用化するにはE2EのようなAIを使わないと厳しい、というのが見えてきて、日本でE2Eを一番進めている会社としてチューリングを選びました。

山岡:僕も、前職でルールベースの難しさを実感していた時期に、自家用車としてテスラに乗ってみて、E2Eという方式がすごく魅力に感じたんです。日本でE2Eをやっているといえばチューリングかな、という感覚で選びました。

ーー過去の自分にこの求人を見せたら、応募すると思いますか?

天笠:三菱、スバルの頃の自分だったら、応募しないと思います。こんなにハードをいじることになるとは思っていなかったので。

山岡:僕も、新卒の時に今の求人を見ていたら、車業界しか経験がなかったので選ばなかったかもしれないですね。

正規ルートがない、ということの証明

ーーここまでの話を聞くと、本当に多様な経験がこの仕事に活きているんですね。

山岡:まさに総合格闘技みたいな感じです。今までの経験や知識をフルリソースで注ぎ込んでも、正直まだまだ全然足りないくらいです。

ーーそんな仕事だからこそ、どんな人に来てほしいですか?

山岡:まずは車やモノづくりが好きな人に来てもらいたいですね。作るのが楽しいと思う人とぜひ一緒に働きたいです。会社がAIツールを支援してくれる環境は本当に助かっているので、そういう新しい技術に触れたい人にもとても良い環境だと思います。

天笠:自分で「あれこれ試してみたい」と、失敗を恐れずに攻めていける人に来てほしいです。やりたいと思った時に止める人は誰もいませんし、ダメだったら「ダメだと分かったね」で次に進める文化があります。使う人がすぐ社内にいて、目の前で動かせて評価をもらえるので、どんどん挑戦したい人にはぴったりだと思います。

高専(高等専門学校)や理系出身者が多く、エンジニア同士で話が通じやすいのも、チューリングの現場らしさの一つだと思います。個人的には「これまでの経験の中でも社内のコミュニケーションが取りやすい」と感じます。みんな『自動運転を作る』という明確な目標に向かっているので、どんどんチャレンジできる環境は本当にありがたいと思います。

ーー最後に、一言ずつお願いします。

山岡:今、開発が加速度的に大きくなっていて、ハードウェアが担う範囲もこれからさらに広がります。ソフトウェアで自動化できる部分は増えましたが、最後にモデルを実際の車両へ載せる工程だけは、人の手でしか進みません。その一番おもしろいところを、一緒にやれる方をお待ちしています。

天笠:ソフトウェアはコピペができますが、ハードウェアはコピペができません。モデルがどれだけ進化しても、それを走る車に載せる工程は残り続けます。だからこそ、ここは今いちばん伸びしろの大きい領域だと思っています。少しでも「やってみたい」と思う方がいれば、ぜひ来てほしいです。

二つのキャリアと、「これまで」の交差点

架装や電装、整備の現場を経験してきた人にとって、山岡さんのキャリアは一つのモデルケースになる。レーシングカーや特装車で培った「限られた時間で仕上げる」感覚、量産車で培った設計・評価の経験は、そのままこの現場で活きる。実証実験や計測、システム開発の現場を経験してきた人には、天笠さんのキャリアが参考になるだろう。現場調整力や、複数の関係者の間で前提を合わせながら進める力は、車両とAIの両方に関わるチューリングのような環境でこそ価値を発揮する。ハードウェアの経験が浅くても、現場で手を動かしながらキャッチアップできる環境が整っているのも、二人のチューリングでの歩みが示す通りだ。本人たちは気づいていないだけで、道は繋がっていた。

“異なる入口から来た二人が、同じ現場に立っている。それが、この仕事に正規ルートがないことの証拠だ。”


Turing TechTalk#43 エッジでリアルタイムを成立させる最適化 ─ 自動運転パイプラインの性能設計と実践

この記事に登場する人
CTO
山口 祐 Yu Yamaguchi
産業技術総合研究所 研究員/米国NIST客員研究員として研究する傍ら、独自にゲームAIの深層学習の開発を開始。日本の囲碁AIプロジェクトの開発代表として、最大1100GPUの並列分散強化学習を設計・開発し、世界大会準優勝、将棋AIでも世界大会優勝などの実績がある。HEROZ株式会社 執行役員を経て、2022年、チューリングに創業メンバーとして参画。2024年8月、CTO就任。基盤AIチームマネージャー兼任。
Driving System3チーム マネージャー
鈴木 達矢 Tatsuya Suzuki
Canonで画像処理や3次元計測、ロボットビジョンに取り組み、日産で量産に関わるシステム開発を経験。SenseTime japanで、モジュールベースの自動運転システム全体の開発に携わる。チューリングでは、E2E自動運転の開発においてシステム全体を俯瞰してさまざまな技術イシューに取り組んでいる。

はじめに

チューリングが開発する完全自動運転AIは、車載のエッジ計算機上でリアルタイムに動作しています。学習だけでなく、実際に車の中で毎秒10回、100ミリ秒以内に画像取得から推論、車両制御までの一連の処理を終える必要があり、この極めてタイトな制約のもとでいかに高速化・最適化を行うかが大きな技術的課題になっています。

今回のTech Talkでは、CTOの山口祐と、Driving System3チームのチームマネージャーである鈴木達矢が登壇。チューリングの自動運転パイプラインを題材に、ゼロコピー設計、CUDAストリームの活用、TensorRTによるレイヤー・カーネル融合、演算精度の使い分け、そしてNsight Systemsを用いたボトルネック解析まで、エッジ環境で“リアルタイム”を成立させるための技術的な工夫を詳しく紹介しました。

※本記事は「Turing Tech Talk #43」の内容をもとに、一部編集のうえお届けします。

山口:皆さん、こんにちは。Turing Tech Talk 第43回「エッジでリアルタイムを成立させる最適化 ── 自動運転パイプラインの性能設計と実践」を始めていきたいと思います。私はTuringのCTOの山口です。本日はDriving System3チームのチームマネージャーである鈴木達矢さんに来てもらっています。鈴木さん、今日はよろしくお願いします。

鈴木:よろしくお願いいたします。

山口:今日は、自動運転AIをエッジ計算機(車載コンピュータ)上でリアルタイムに動かすための高速化・最適化がテーマです。AIには学習と推論(学習済みモデルを実際に動かす処理)の2つのフェーズがありますが、今回は推論側の話が中心になります。それでは鈴木さん、簡単に自己紹介をお願いします。

鈴木:2009年、新卒でキヤノンに入社し、画像処理やロボットビジョンの研究開発に取り組みました。その後デンソーで自動運転開発に携わり、車両業界に飛び込みました。その後SenseTime japanでモジュールベースの自動運転システム開発に従事し、現在はチューリングで推論周りの開発を担当しています。在籍は1年半になります。

山口:私はチューリングのCTOを務めています。TuringTechTalkは、チューリングの最新の研究開発内容を担当エンジニアが直接解説するオンラインイベントです。今日はエッジ環境での最適化ということで、GPUやCUDA関連の話が中心になるかと思います。チューリング株式会社は2021年8月設立、本社は東京都平和島(羽田空港近くの物流倉庫街の一角)にあります。累計資金調達額は最近更新されまして365億円、社員数はまもなく100人です。事業内容は完全自動運転システムの開発で、どんな場所・シチュエーションでも人間の介入なしに運転できる、いわば究極の自動運転を指しており、こうした開発を進めるディープテックスタートアップとして日々取り組んでいます。それでは、ここから鈴木さんに説明してもらいます。

リアルタイム推論を支えるエッジ計算機

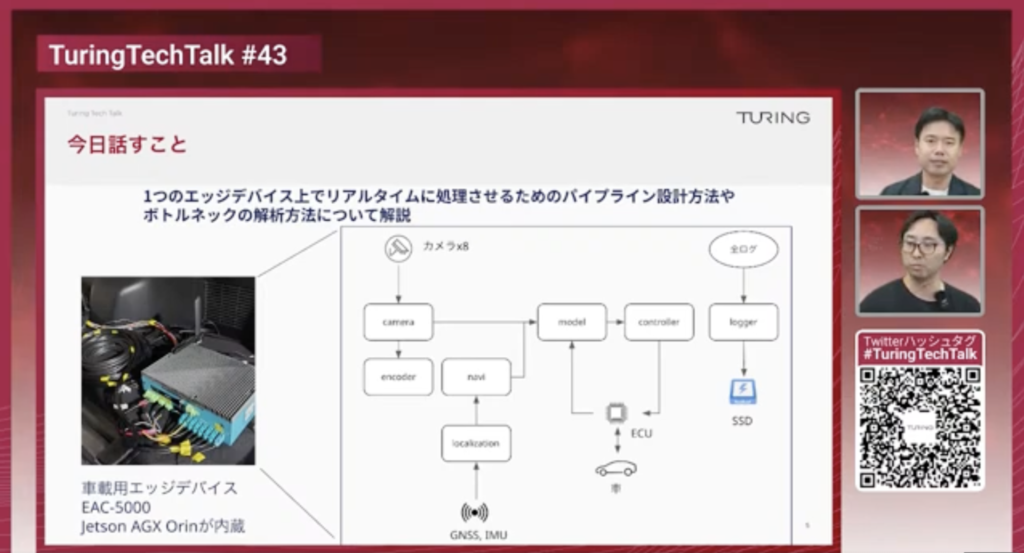
鈴木:今日は、1つのエッジデバイス上でリアルタイムに処理させるためのパイプラインの設計方法と、動かしていく中で生じるボトルネックの解析方法について解説していきます。

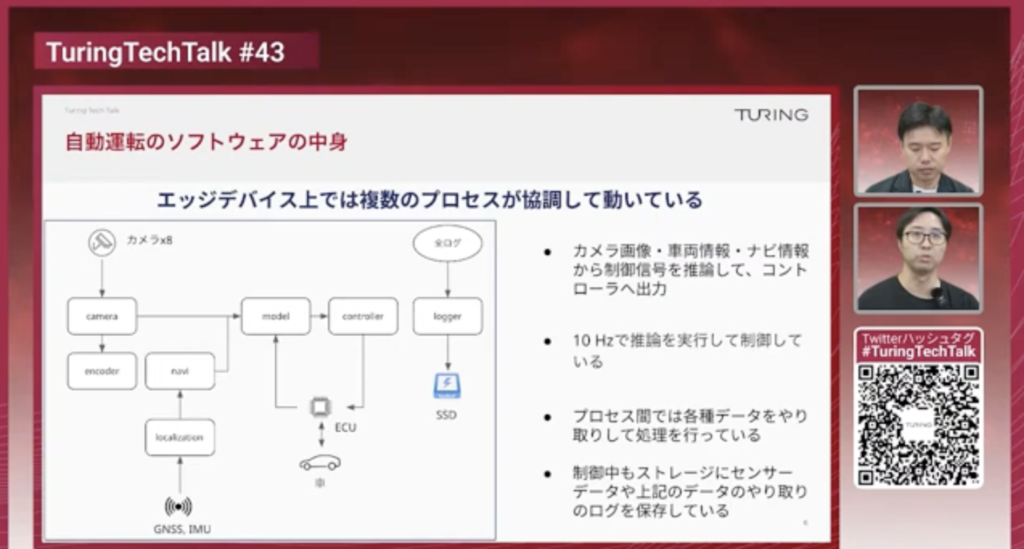
我々が使用しているのはNVIDIA DRIVE AGX Orin(車載用の計算機。内部にJetson AGX Orinを搭載)です。推論だけでなく、カメラやGNSS(衛星測位システム)、車載のCAN(Controller AreaNetwork、車両内の通信プロトコル)情報の取得もあわせて行っています。

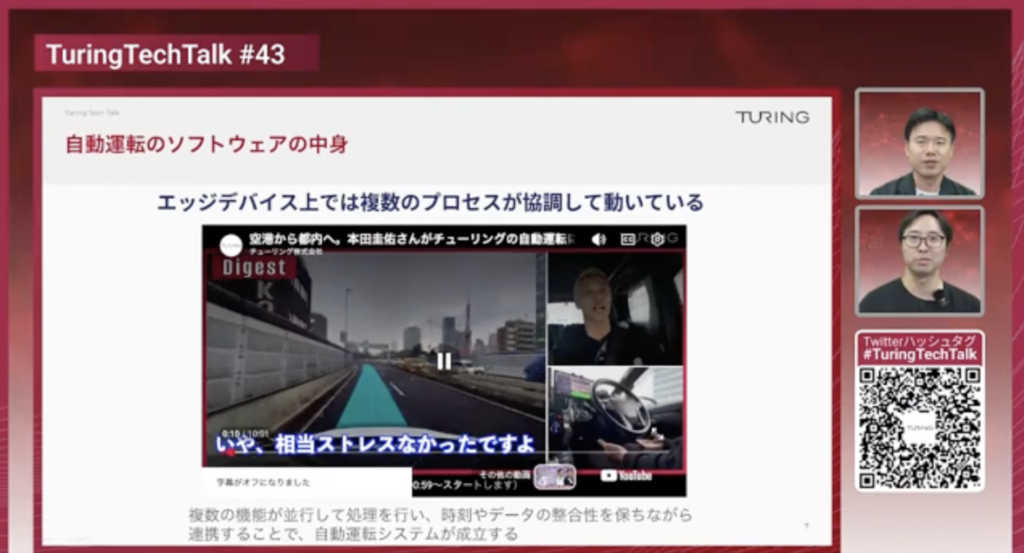
デバイス上では複数のプロセスが協調して動作しています。カメラ画像や車両情報、ナビ情報を取り込み、学習済みモデルがそれを受け取って推論し、車のコントローラーに制御信号として出力します。これを10Hz(1秒間に10回、つまり100ms以内に一連の処理を終える必要がある)というリアルタイム制約のもとで動かしており、制御と並行して各種センサーデータや通信ログをストレージに保存しています。

山口:この計算機はNVIDIA製で、Ampere世代(NVIDIAのGPUアーキテクチャの1つ。現行最新はBlackwell、その前がHopperで、Ampereはさらに前の世代)の車載用に特化したチップです。スペックは約2650TOPS(Tera Operations Per Second、演算性能の指標)で、データセンター向けGPUには劣りますが、身近な例で言うとNintendo Switch 2のSoC(NVIDIA製カスタムチップ)に近い性能とイメージしていただければと思います。このパイプラインで重くなりやすいのは、カメラの画像処理とモデルの推論処理だと聞いています。10Hz・100msという制約は、たとえば言語モデルをデータセンターのサーバー上で推論サービスとして提供するような場合とは性質が異なり、少しでも遅延すればそのまま車の制御が遅れてしまう、非常にタイトなリアルタイム性が求められる領域です。

鈴木:はい、今日の話の中心もそこになります。

ボトルネックの所在とゼロコピー設計

山口:先日、ワールドカップ観戦から帰国されたばかりの本田 圭佑さんに、弊社の自動運転車で空港から送迎させていただいた動画をチューリングのYouTubeチャンネルでご紹介しました。よくできた自動運転というのは、乗っていても「自動運転をしている」ことを意識させないくらい自然になるものです。運転が上手なタクシーの運転手ほど印象に残らないのと同じで、安定して自然であることこそが良い自動運転だと感じています。

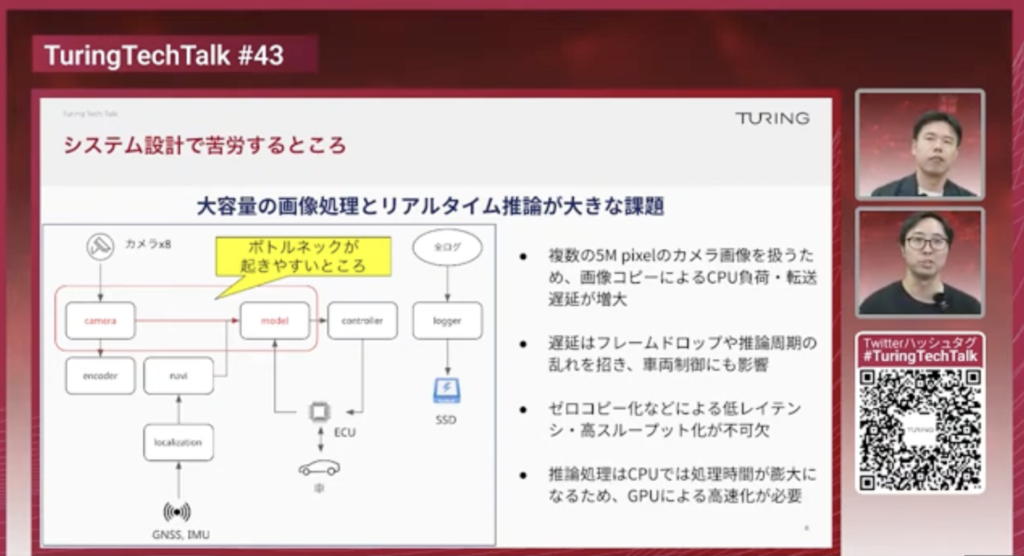
鈴木:システム設計で苦労するのは、カメラが5メガピクセルという比較的高画質であるため演算量が大きくなり、大容量画像のリアルタイム処理が課題になる点です。画像をコピーするとCPU負荷や転送遅延が増え、フレームがドロップしてしまうと、モデルは画像が順序通り届くことを前提に動いているため、車両の挙動が乱れる原因になります。それを防ぐには、コピーを発生させず同じメモリ領域からポインタで受け渡す「ゼロコピー」の実装が重要になります。

山口:計算機の内部では、ストレージからメモリへの展開、メモリからCPUレジスタへの転送など、随所でコピーが発生します。特に今回のDRIVE AGX OrinはCPUとGPUが一体化したSoCですが、内部では処理系統が分かれているため、CPUとGPUの間でデータをやり取りするたびにオーバーヘッドが生じます。

8台のカメラの映像はそのままAI推論に使うだけでなく、記録のために動画としてエンコード(圧縮)してストレージに保存する処理も同時に走っています。スマートフォンで長時間動画を撮影しているとカメラ部分が熱くなることがありますが、あれは撮影した信号をリアルタイムに動画へエンコードする処理が走っているためです。カメラ1台でもそれだけの負荷がかかるところを、8台分を同時にこなす必要があり、しかもメモリ・CPU・GPUといったリソースはすべて推論処理と共有しているため、計算機のリソースは非常にカツカツな状態になります。

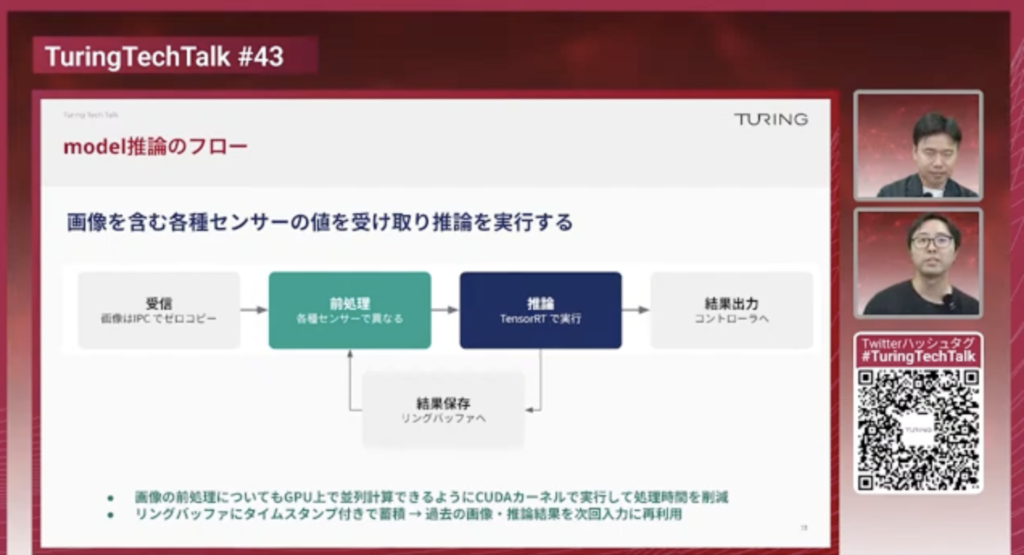
鈴木:まさにそうですね。だからこそ、できる限り効率的にリソースを使い切る設計が求められます。このボトルネックを解消するため、カメラ画像の前処理から推論までを同一のCUDA(NVIDIAが提供するGPU向け並列計算プラットフォーム・開発キット)プロセスに集約し、GPUから直接参照可能なメモリ上でデータを受け渡すことで、不要なコピーとプロセス間の同期待ちを削減しています。あわせて前処理・推論・記録処理の順序をうまく制御し、リソースの競合を避けることもポイントです。

CUDAストリームとTensorRTによる高速化

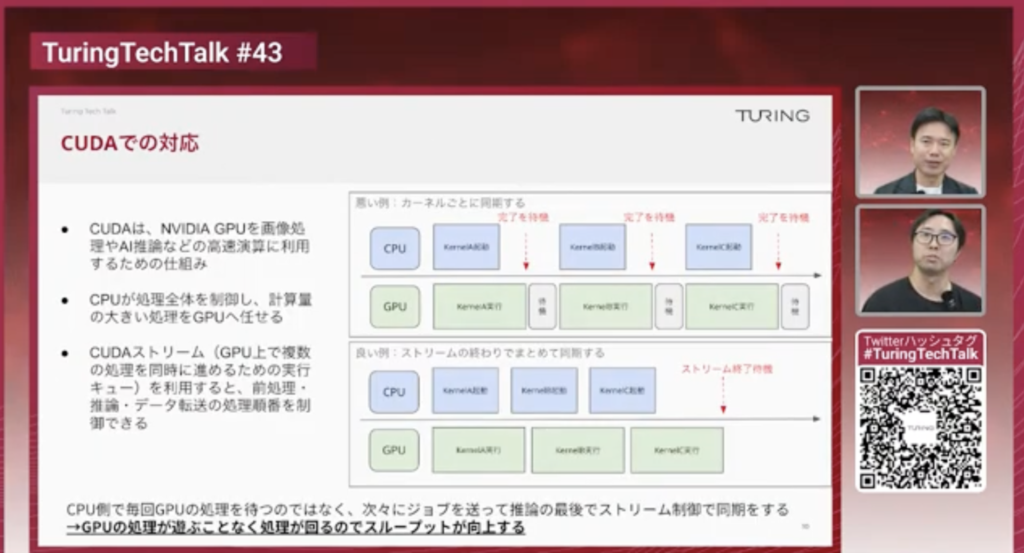
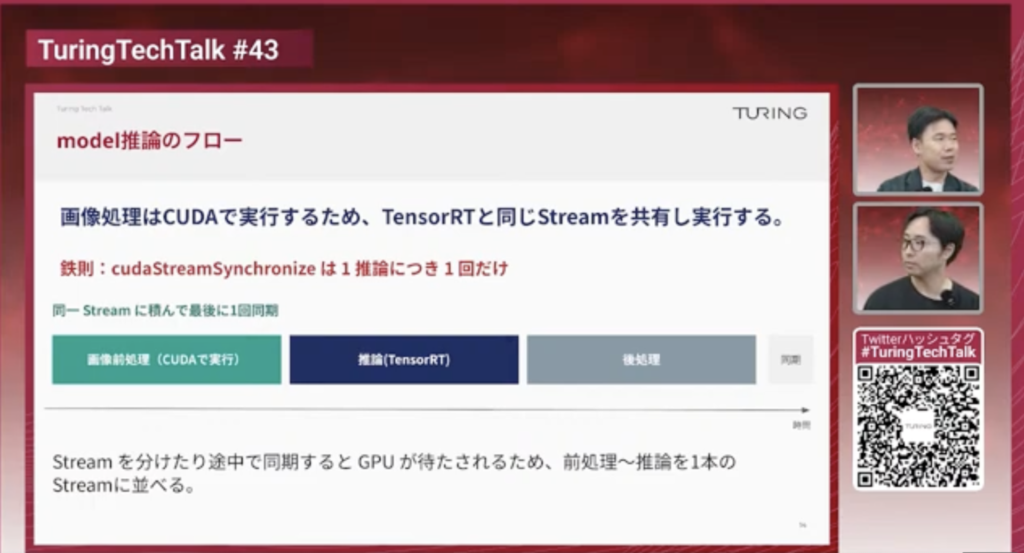
鈴木:CUDAでは「ストリーム」という単位でGPU上の処理順序を制御します。CPUが1つずつ命令を出してはGPUの処理完了を待つ、という進め方をすると待機時間が無駄になってしまうため、複数の命令をまとめてストリームに投入し、GPUを常に稼働させ続けること、そしてCPU・GPU間の同期はできる限り減らすことがポイントです。

山口:なるほど。これはたとえるなら、指示を出す人と実際に働く人が2人いて、その都度「これ終わりました、次は何をしますか」と確認を挟んでしまうと仕事が進まない、という状況に近いですね。朝のうちに今日やることをまとめて指示しておき、休みなく作業を進めてもらった方が、1日のアウトプットは大きくなります。

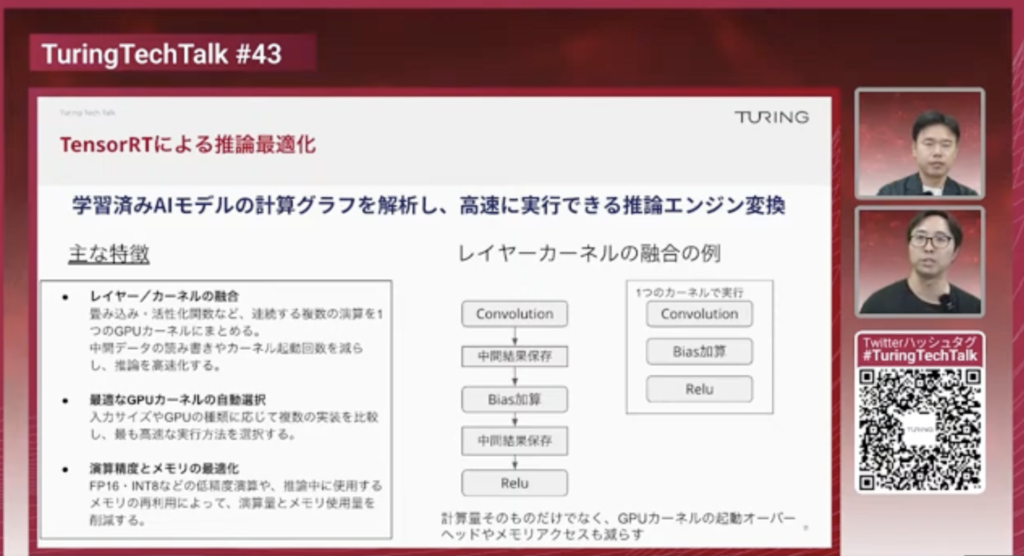
鈴木:まさにそのとおりで、GPUを絶えず働かせ続けることが重要になります。学習済みモデルの推論には、TensorRT(NVIDIAが提供する推論高速化ライブラリ・SDK)を使用しています。TensorRTは学習済みモデルの計算グラフを解析し、畳み込みや活性化関数など連続する演算を1つのGPUカーネルにまとめる「レイヤー・カーネル融合」を行うことで、GPU起動のオーバーヘッドやメモリアクセスを削減します。また、入力サイズやGPUの種類に応じて最適なカーネルサイズを自動的に探索するチューニング機能も備えています。

山口:GPUはもともとグラフィックス、つまり映像処理のために作られたもので、大量の演算器を並列に並べ、色データなどを一斉に処理することを得意としています。その並列処理の仕組みをAIの推論にも活用しているのが今のGPUです。ハードウェアの特性を踏まえてソフトウェア側から最適な形に変換してくれるのがTensorRTというわけです。CUDAやTensorRT自体は10年以上の歴史がありますが、当初は数倍程度だった高速化効果が、NVIDIAによるソフトウェアとハードウェア双方の作り込みによって、現在では大幅に向上しています。

演算精度とゼロコピー実装の詳細

鈴木:あわせて重要なのが演算精度です。モデルの学習時にはFP32(32ビット浮動小数点)を使いますが、推論時にはその半分のFP16(16ビット)や、さらに低精度なINT8(8ビット整数)に精度を落とすことで、演算に使うメモリを削減し、データの取り回しを速くできます。低精度化は精度とのトレードオフになりますが、コンピュータは整数演算を得意とするため、INT8化(量子化)は高速化に大きく寄与します。TensorRTはこの量子化のチューニングも自動的に行ってくれます。

鈴木:ゼロコピーの実装面では、通常のcudaMalloc(GPUメモリを確保するCUDAの基本関数)は仮想アドレスの予約と物理メモリの割り当てを同時に行ってしまうため、これらを分離できる低レベルAPI(バーチャルメモリマネジメント)を用いています。これにより、プロセス間でIPC(Inter-Process Communication、プロセス間通信)を介してGPUメモリをそのまま共有する仕組みを実装しています。あわせて、過去の画像や推論結果を再利用するために、タイムスタンプ付きのリングバッファ(あらかじめ確保したバッファ数を使い回す仕組み)で時系列データを蓄積しています。画像処理と推論はCUDAストリームを共有し、同期は推論が完了した1回だけにとどめることを徹底しています。

Nsight Systemsによるボトルネック解析

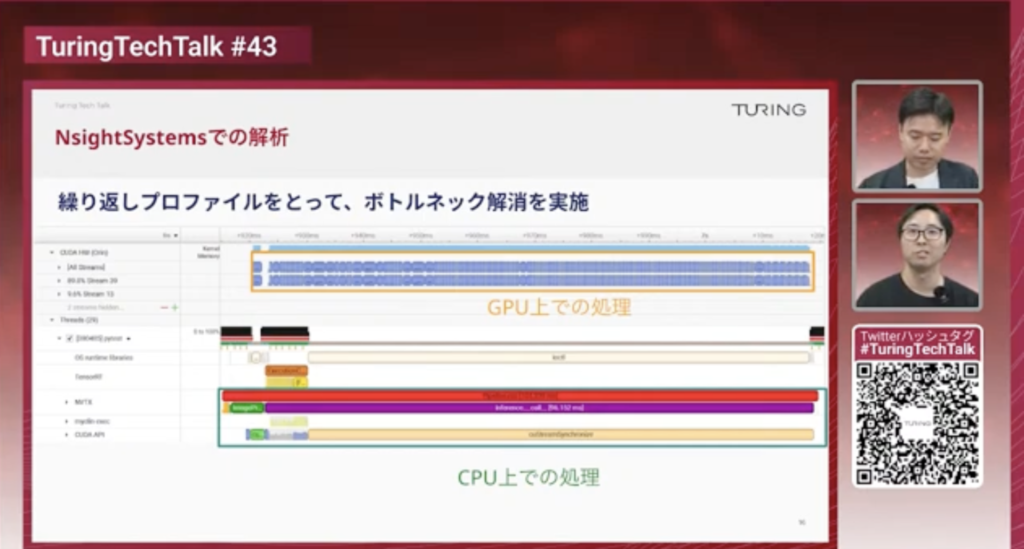
鈴木:ボトルネックの解析には、Nsight Systems(NVIDIA製のプロファイリングツール)を使用しています。これはCPU、GPU、OS、DLA(Deep Learning Accelerator、GPU以外の演算アクセラレータ)など、すべてのプロセッサの処理タイミングを可視化してくれるツールです。

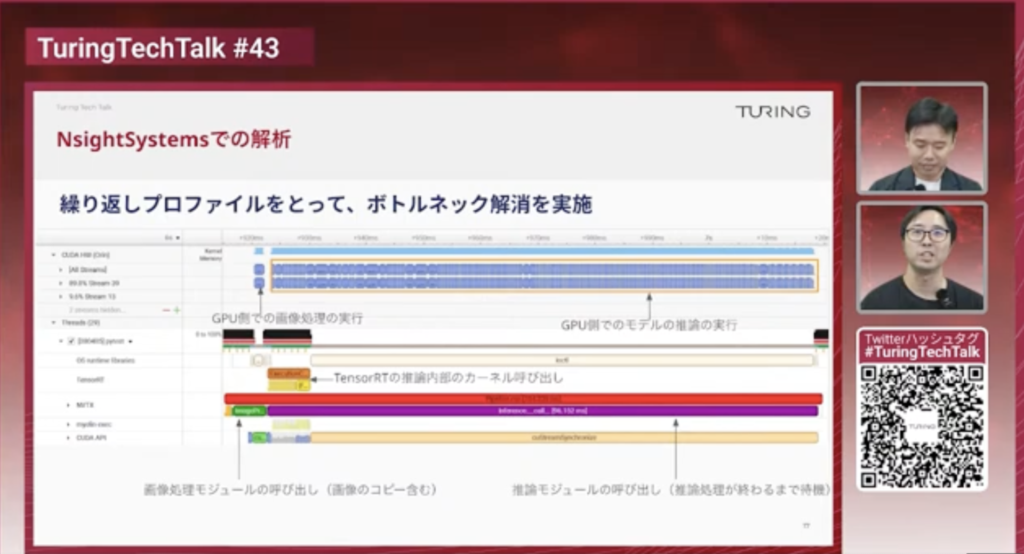
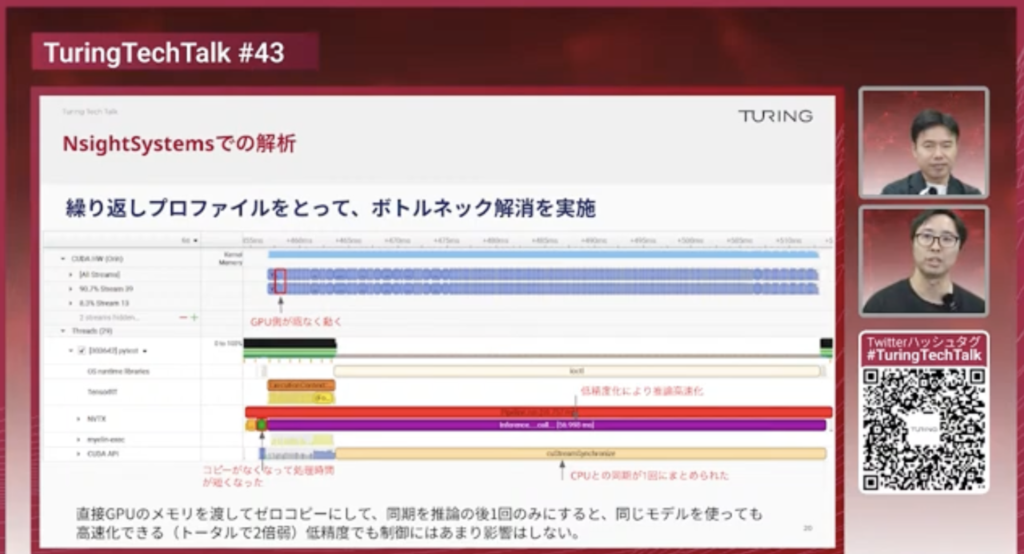
山口:実際のプロファイルを見ると、画像の前処理とGPUでの推論処理の間に隙間があり、GPUが遊んでしまっている状態が見つかりました。

鈴木:原因は、CPU側が画像処理の完了を待ってから次の命令を出していたことでした。また前処理のブロックが長くなっている箇所では、不要な画像コピーが発生していました。パイプライン全体では104ms程度かかっており、そのうち推論部分(FP32使用時)だけで96ms程度を占めていました。これは100msというリアルタイム制約をわずかに超えてしまう水準です。そこで、CPU・GPU間の同期の削減、不要なコピーの削減、そしてTensorRTでのFP16化を行った結果、104msだった処理時間は60ms未満まで短縮できました。FP16程度の精度低下であれば、運転の制御性能への影響はないこともこれまでの検証で確認しています。

山口:この手のプロファイル分析は、まさにエンジニアの間でよく言われる「推測するな、計測せよ」という格言そのものですね。専門知識があるとつい「こうだろう」と感覚で議論しがちですが、結局コンピュータの速度や性能を決めるのは実際に計測した結果でしかありません。自動運転そのものについても同じで、こういうアーキテクチャなら運転が良くなるはずだ、というのはあくまで仮説であり、実際に車の上、計算機の上で動かして検証して初めて確かめられます。

山口:モデルは大きいほど賢くなる一方で、パラメータ数が多いほど演算コストも増えるというトレードオフがあります。パイプラインを高速化して生まれた余裕を、より大きく賢いモデルの搭載に充てるという積み重ねを重ねてきた結果、これまで全体として2~3倍程度の高速化を実現してきました。かつてはギリギリでしか動かなかった処理も、今では余裕を持って動かせるようになっています。

チーム体制と今後

鈴木:このチームは現在、私を含めて3人体制です。もう1人は監視カメラなど別のデバイスで同様のノウハウを培ってきたメンバー、もう1人は新卒からチューリングに入りずっとこのシステムに関わってきたメンバーです。チューリングとしてもまだ5年ほどのスタートアップですが、若いメンバーと経験のあるメンバーがともに1つの課題に取り組んでいます。

山口:鈴木さん、今日はありがとうございました。非常に勉強になりました。次回のテックトーク第44回は、1ヶ月後の8月12日(水)18時から、「車両の制約下で成立させる自動運転 ── 機構と統合設計」というテーマでお届けします。次回は、いま我々が開発している自動運転車、つまり市販車にセンサーや計算機を追加改造して作っている車両について、その改造・設計・メンテナンスを支えるハードウェア技術を扱います。Driving System2チームのシニアエンジニアである山岡さんに登壇いただき、走行系・電装系をどのように設計し施工しているかを解説する予定です。

山口:鈴木さん、今日はいかがでしたか?

鈴木:今日は自分なりにわかりやすく説明したつもりでしたが、振り返るとやや難しくなってしまった部分もあり、反省点があるかなと思います。また機会があれば、皆さんにもっとうまく解説できるようブラッシュアップしていきたいと思います。

山口:今日は、ありがとうございました。

Q&A一覧(一部抜粋)

以降は視聴者のQAに回答していきました。詳しくは動画をご覧ください。

  • この車載計算機(DRIVE AGX Orin)はどれくらいの金額なのでしょうか?
  • ログを撮りながら10Hzで動くのがすごいです。ログはどこまで撮っているのですか?
  • システム設計とアルゴリズムは何が異なるのでしょうか?リアルタイムにするためにどういったアルゴリズムを使っているのか気になりました。
  • CPU・GPU間の同期はプロセス間の依存関係を解決するために必要だと思います。仮想メモリ部分から実装し直す必要があったと思いますが、難しかったことはありましたか?
  • 通常、学習モデルにはPyTorchなどを使うと思いますが、推論部分はどの言語を使われていますか?CUDAライブラリを直接コールしているのでしょうか?
  • 初心者でもこういった高速化のためのシステム設計を行いたいと思ったら、とっつきやすい材料などはありますか?
  • INT8を使うことでモデルを高速化するとのことですが、運転挙動やモデル精度にはどれほど影響があるのでしょうか?

チューリングでは、完全自動運転の技術を共に創る仲間を募集しています。今日お話ししたDriving Systemチームはもちろんのこと、機械学習エンジニア、リサーチャー、ソフトウェアエンジニア、組み込みエンジニア、インフラエンジニアなど、非常に幅広いエンジニア職種で仲間を募集しています。ご興味のある方は、ぜひ採用ページをご確認ください。多様な職種がありますので、ご自身がどれに当てはまるか、ぜひチェックしてみてください。
TuringTechTalk#42 ペタバイト級データセットの作り方 ─ 学習を止めないためのスループット・再現性・運用設計

この記事に登場する人
CTO
山口 祐 Yu Yamaguchi
産業技術総合研究所 研究員/米国NIST客員研究員として研究する傍ら、独自にゲームAIの深層学習の開発を開始。日本の囲碁AIプロジェクトの開発代表として、最大1100GPUの並列分散強化学習を設計・開発し、世界大会準優勝、将棋AIでも世界大会優勝などの実績がある。HEROZ株式会社 執行役員を経て、2022年、チューリングに創業メンバーとして参画。2024年8月、CTO就任。基盤AIチームマネージャー兼任。
自動運転第4グループマネージャー
安本 雅啓 Masahiro Yasumoto
新卒で日立製作所に入社し、鉄道のITシステムの研究開発に従事。その後AIスタートアップのアラヤにて開発案件に携わり、CTOに就任。2021年4月にatama plusへ入社し、アルゴリズム開発エンジニアとしてAI教材atama+のレコメンドエンジンの開発を担当。2024年5月にチューリングに参画し、入社当初から一貫してMLOps領域を担当。現在は自動運転第4グループのMLOpsチームマネージャーとして、ペタバイト級の自動運転データパイプラインの設計・運用を推進している。

はじめに

自動運転AIの性能は、モデルそのものだけでなく、どのようなデータを学習に利用するかによって大きく左右されます。高品質なモデルを継続的に開発するためには、膨大な走行データを効率よく収集・管理し、学習に適したデータセットへ変換する仕組みが欠かせません。

チューリングでは、自社で収集した走行データがすでにペタバイト級に達しており、その膨大なデータを安定して運用しながら、機械学習モデルの学習を止めないデータ基盤の構築に取り組んでいます。

今回のTech Talkでは、CTOの山口祐と、自動運転第4グループマネージャーの安本雅啓が登壇。チューリング社内で開発・運用しているデータセット基盤「GARUDA」を題材に、ペタバイト級データセットの設計思想から、データパイプライン、ストレージ設計、開発者体験の改善、そして運用まで、その技術的な取り組みを詳しく紹介しました。

※本記事は「Turing Tech Talk #42」の内容をもとに、一部編集のうえお届けします。

山口:皆さん、こんにちは。Turing Tech Talk 第42回「ペタバイト級データセットの作り方」を始めていきたいと思います。私はTuringのCTOの山口です。本日は自動運転第4グループのマネージャーで、MLOps(機械学習の開発・運用基盤)を担当している安本さんに来てもらっています。安本さん、今日はよろしくお願いします。

安本:よろしくお願いします。

山口:今回「ペタバイト級データセットの作り方」ということで、結構大きく出たタイトルかなと思うんですけど。

安本:そうですね。大きく出ないとなかなか来ていただけないかなと思って、今回は大きく出てみました。

山口:煽り気味ですね。ただ間違ってはいなくて、言っていること自体は本当にペタバイト級のデータを扱っているので、その作り方をお話しできればと思います。実際にこのペタバイト級のデータを扱ってデータセットを作っているのがまさにTuring内部でやっていることで、その中身がどうなっているかを今日は深掘りできたらと考えています。それでは登壇者紹介です。安本さん、簡単に自己紹介をお願いします。

安本:私は新卒で日立製作所に入社し、鉄道のITシステムの研究開発を担当していました。その後、AIスタートアップのアラヤにて開発案件に携わり、CTOに就任。2021年4月にatama plusへ入社し、アルゴリズム開発エンジニアとしてAI教材atama+のレコメンドエンジンの開発を担当しました。2024年5月にTuringへ入社し、ちょうど2年と少しが経ったところです。

山口:安本さんは入社当初からずっとMLOpsに関わっていて、今はその責任者を務めています。MLOpsがまだ担当者1人という時代から、Turing社内のMLOpsを立ち上げてきて、いよいよスケールするようになってきたというところなので、今日はその歴史的経緯も含めて色々と聞いていければと思います。Turing Tech Talkは、Turingの最新の研究開発の内容を、担当エンジニアが直接解説するという企画です。今回はデータセット設計、特に自動運転というドメイン、あるいは最近でいう「フィジカルAI」(現実世界のセンサー情報を扱うAI全般を指す言葉)のドメインで、データセットをどう設計し、どう運用するかについて、幅広く応用可能な技術を取り上げます。この後、会社紹介を挟んで、安本さんから本題であるペタバイトデータセットの作り方を解説してもらいます。本日のタイトルは「実例を元に解説、自動運転モデル開発のためのペタバイト級データセットの作り方」です。

安本:実例を話すというより、MLOpsの設計やアーキテクチャに踏み込んだ話が中心になります。これからMLOpsをやりたいという方には参考になる内容かなと思います。

データパイプラインの全体像

安本:自動運転AIの学習データがどのように作られるのか、その全体像を紹介ご紹介します。Turingは自動運転の開発のために自社で車両を保有し、データを収集しています。平和島の車庫にたくさんの車両があり、それが毎日東京中、さらには全国を走り回ってデータを取得しています。このデータをいかにMLモデルへ読み込める形にするか、というのが今回のデータパイプラインの内容です。

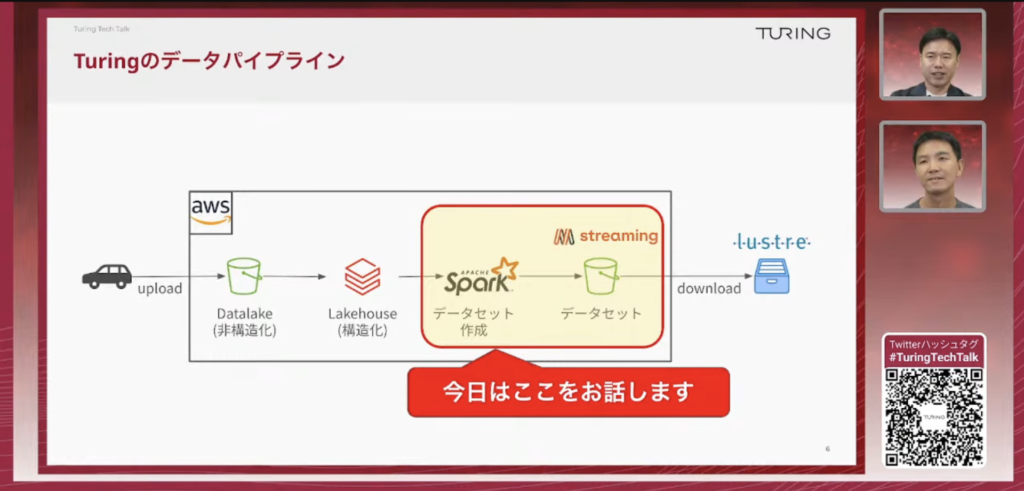
流れとしては、まず車から上がってきたデータが、クラウド(AWS)内に格納されます。最初に入るのが「データレイク」で、これは動画や生のバイナリデータなど非構造化データを格納する場所です。ただこれだけではデータがどこにあるか分かりにくいため、そこから構造化したデータに変換して格納する場所が「レイクハウス」で、Turingでは実際の基盤としてDatabricks(データ分析基盤サービスを提供する企業、およびそのサービス)上に構築しています。レイクハウス上のデータはテーブル形式、いわばデータウェアハウスのようなものです。このテーブルのままではMLモデルに直接入力するのは難しいため、最終的にファイル形式のデータセットに変換して保存する工程があり、これが「データセット作成」で、できあがったデータセットはS3(Amazon S3、AWSのオブジェクトストレージサービス)のバケットに格納されます。さらに、このS3上のデータセットは、オンプレミスのGPUクラスターで使う際には、Lustre(大規模計算環境向けの高速並列ファイルシステム)と呼ばれるストレージシステムにダウンロードして利用します。

山口:ここまでの流れが非常に分かりやすかったのですが、何人かエンジニアではない人も聞いているかもしれないので、ベースから色々と教えて欲しいなと思います。

チューリングは自分たちで車両を持っていて、センサーをつけたりして人間が運転をしてデータを集めている訳なんですけれども、一日どれくらいの分量が取られていますか?

安本:日によってかなり変動しますが、数十テラバイトは入っているという形ですね。

山口:車両には4TBほどのSSDを積んでいますが、1日の走行で1台分が足りなくなることもあり、10台程度が走ると1日で40TB程度のデータが上がってくることもあります。これがSSD経由でインターネット越しにAWSへアップロードされ、データレイクに蓄積されていきます。すでにデータレイクに入っているデータの量が、タイトルにもある「ペタバイト級」です。普通のPCで100GBのZIPファイルを扱うだけでも時間がかかりますが、それが1000倍、1万倍の規模になるということです。保存コストも当然大きな課題です。

DatabricksとSparkについて

山口:Databricksという会社について補足しておくと、Databricksは米サンフランシスコに本社を置く未上場のソフトウェア企業で、時価総額はおよそ20兆円規模とされ、日本の上場企業でいえば時価総額10位前後に匹敵する規模です。Databricksは、Apache Spark(分散データ処理のためのオープンソースフレームワーク。Apache Software Foundation、略称ASFが管理する)を開発したメンバーが立ち上げた会社で、Sparkをエンタープライズ向けに使いやすく、また高性能にチューニングし、クラウド上で扱えるようにしたマネージドサービスです。Apache Sparkは2010年前後に登場したフレームワークで、その前身にあたるHadoopのMapReduce(分散処理の仕組みの一つ)がディスクへの書き込みを多用して低速だったのに対し、Sparkはできるだけインメモリで処理を完結させることで高速化を実現した、という歴史的経緯があります。

プロジェクト「GARUDA」

安本:今回お話しする新しいデータセット作成の仕組みには、開発時のコードネームとして「GARUDA(ガルーダ)」という名前がついています。ガルーダはヒンドゥー教などにおける神鳥の名で、インドネシアの国章やガルーダ・インドネシア航空の社名にも使われています。【大事なデータをMLモデルやMLエンジニアに届ける、そのための力強い鳥】、というイメージから名付けました。

安本:GARUDAには、社内のユーザー(Turingの車内エンジニア)に対する「4つの約束」があります。1つ目は全く新しいデータセットフォーマット(ガルーダビルダー)、2つ目は刷新された開発者体験、3つ目はオンザフライでの動画デコーディング、4つ目は圧倒的なストレージコストの効率化です。これらはすでにすべて実現されており、社内では旧システムから完全に移行が完了しています。それでは一つずつ説明していきたいと思います。

約束1:新しいデータセットフォーマット

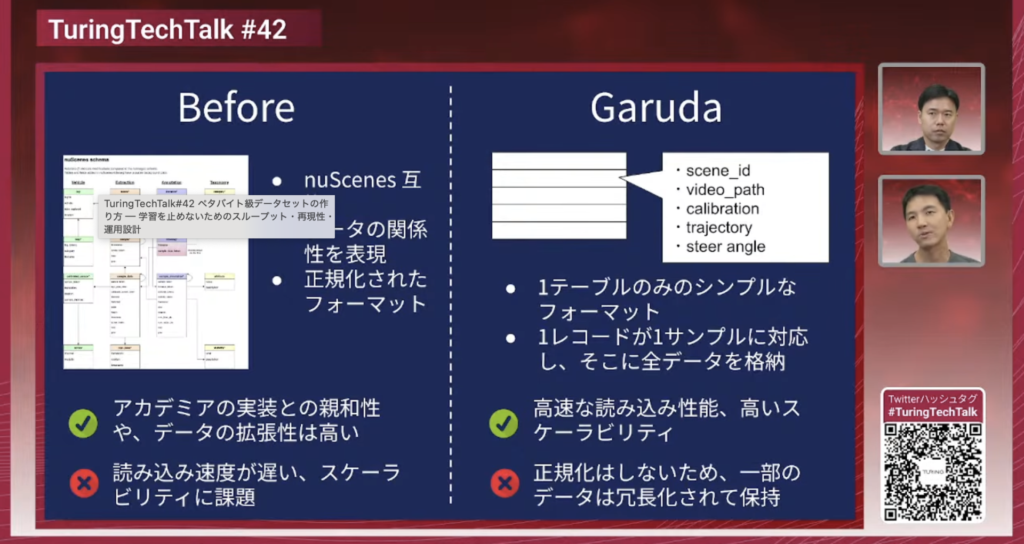
安本:以前は、nuScenes(自動運転分野でデファクトスタンダードとなっている、複数の関連データをリレーショナルデータベースのような形で正規化して格納するデータセットフォーマット)準拠の形式を採用していました。これは拡張性が高く、アカデミアの実装や論文でよく引用されるため、既存のモデルを試しやすいというメリットがありました。一方で、nuScenes自体が公開している走行データはおよそ6時間分と非常に少なく、大規模スケールを想定した設計にはなっていません。また、1つのJSONファイルが数十GBに達し、メモリに載り切らなくなるなど、フォーマット自体にスケーラビリティの限界がありました。

安本:そこでGARUDAでは、1テーブルのみ、1レコードが1サンプルに対応するシンプルなフォーマットに変更し、必要なデータをすべてそこに格納するようにしました。これにより高速な読み込み性能と高いスケーラビリティを確保しています。ただし、キャリブレーション情報のように本来はサンプルごとに変化しないデータも、あえて冗長に持たせるトレードオフを採用しています。これは、スケーラビリティと高速な読み出しを最優先した設計判断です。

山口:なるほど。なお、車両データはほぼ映像データが容量の大部分を占めており、CAN(Controller Area Network、車内の通信プロトコル)から得られるステアリングやウインカーの情報、IMU(慣性計測装置)やGNSS(衛星測位システム)による位置・加速度情報なども含まれますが、これらのデータ容量は全体の1%以下です。またTuringのデータはカメラ(RGBカメラ)ベースであり、現状ではライダーやレーダーのセンサーデータは含めていないという状態でしたよね。

約束2:On-the-fly GPUデコーディング

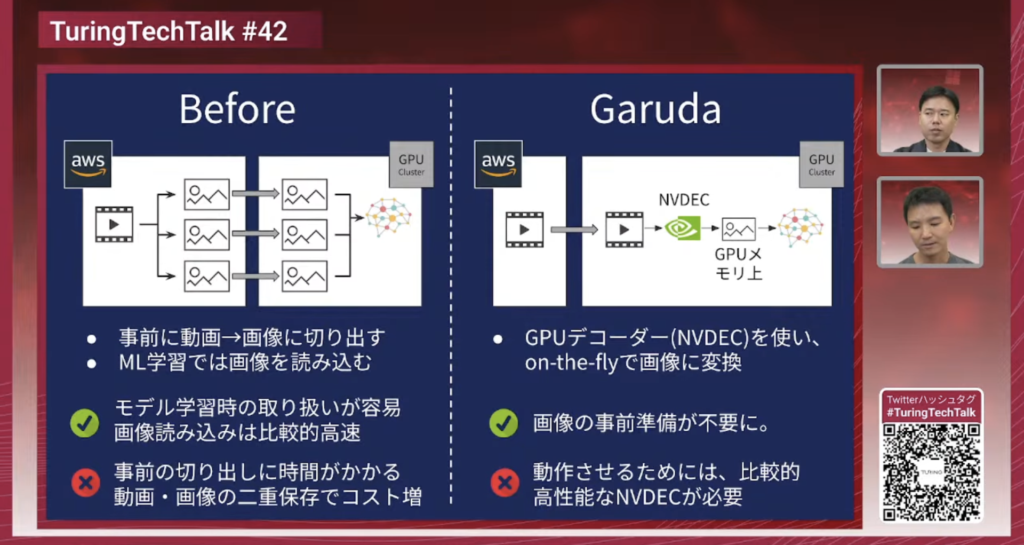
安本:以前は、動画から画像を事前にすべて切り出し、学習時はその画像を読み込んでいました。これはモデル学習時の取り扱いが簡単というメリットがある一方、切り出し作業に時間がかかること、動画と画像を二重に保存するためストレージコストが増大すること、さらに動画から画像への変換時にエンコード・デコードを繰り返すことで画質が劣化する可能性がある、というデメリットがありました。

GARUDAでは、NVIDIA GPUに搭載されたハードウェアデコーダーであるNVDEC(NVIDIA Decoder、動画デコードに特化した専用回路)を利用し、学習中に動画をon-the-fly (その場)でデコードする方式に変更しました。これにより画像の事前準備が不要になり、動画をそのまま学習に使えるようになりました。デコードされたデータはGPUメモリ上に直接展開され、そのまま学習に利用できるため、CPU・GPU間でのメモリ転送というボトルネックも回避しています。

山口:一般的な機械学習では、動画を画像に分解して学習しますが、画像として保存するとデータ量が大幅に増えます。GARUDAでは、ストレージコストや転送時間を抑えるため、動画をそのまま学習に利用し、NVDECで学習時にリアルタイムでデコードする方式を採用しています。

安本:一方で、高性能なNVDECをフルに活用する必要があり、GPU1基あたり搭載されているNVDECは7基程度で、複数の動画を並列にデコードし続けるマルチプロセス処理を適切に管理する必要がありました。また前処理やデータ拡張(オーギュメンテーション)もすべてGPU上、つまりCUDA(NVIDIAのGPU向け並列計算プラットフォーム)で実装する必要があり、実装難易度は高いものの、社内のCUDAに強いエンジニアが移植を担当し、最終的に旧方式と同程度の速度を実現しました。

約束3:刷新された開発者体験

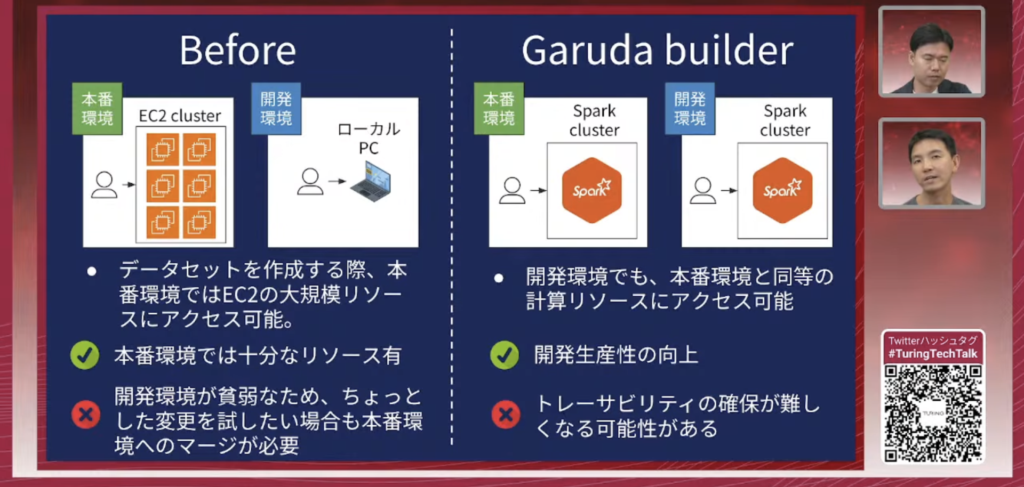
安本:以前は、データセット作成にAWS Batch(AWS上でバッチ処理を実行するサービス)とEC2(Amazon Elastic Compute Cloud、AWSの仮想サーバーサービス)インスタンス群を利用していました。本番環境は作り込まれていた一方、開発環境の整備が追いついておらず、MLエンジニアがデータセットに変更を加えたい場合はローカルでデバッグしたうえで本番にマージする必要があり、大規模実行して初めて分かるバグを踏みやすいという課題がありました。

安本:現在はDatabricksが提供するサーバーレスのSpark環境を利用し、事前にサーバーを用意しなくてもデータ量に応じて自動的にスケールするようになりました。これにより開発環境と本番環境がほぼ同一のSpark環境となり、MLエンジニアが少し試して問題なければ、そのまま本番でも同じ環境で実行できるようになったことで、バグを踏みにくくなりました。またPySpark(PythonからApache Sparkを扱うためのAPI)によりSparkやデータベースに詳しくないエンジニアでも扱いやすく、ジョブの実行も数分程度で結果が返るため、開発サイクルの速度も大きく落ちていません。

約束4:圧倒的なストレージコスト効率化

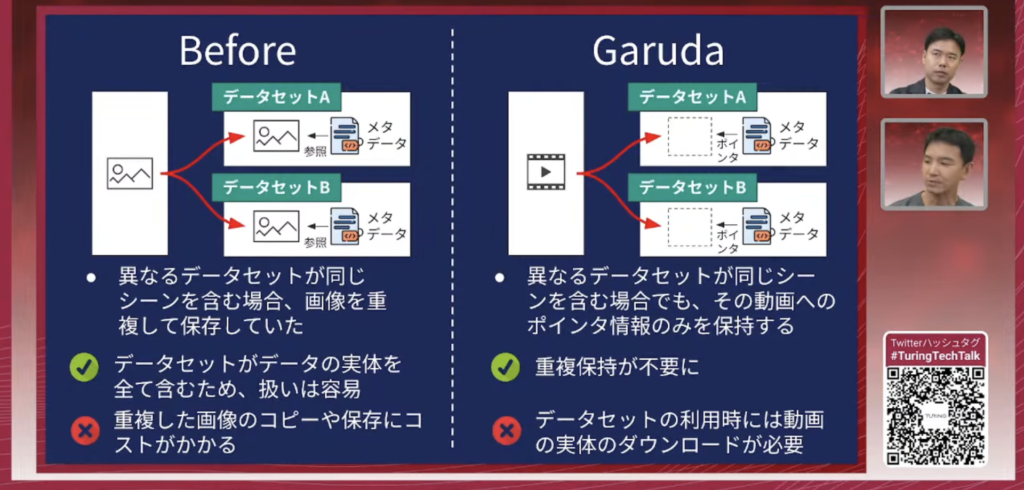
安本:以前は、異なるデータセットが同じシーン(同じ時間帯の走行データ)を参照する場合でも、それぞれのデータセットに画像を重複して保存していました。これは、メタデータと画像データが1つのディレクトリにまとまっているためポータビリティが高いというメリットがある一方、MLエンジニアが試行錯誤のたびに多数のデータセットを作成するため、重複した画像の保存コストが膨大になるという問題がありました。現在は、異なるデータセットが同じシーンを参照する場合でも、動画そのものへのポインタ情報だけを保持し、動画データ自体は重複して持たない方式に変更しました。データ利用時には、そのポインタに紐づく動画を都度ダウンロードする必要がありますが、データ容量やストレージコストの観点では圧倒的に効率的です。この変更により、同じLustreストレージ容量で扱えるシーン数はおよそ10倍に向上したとのことです。また、元の動画ファイルは変更不可(イミュータブル)かつリードオンリーとして扱われ、どのデータセットがどの動画を参照しているかをデータベースで管理しているため、不要な動画を安全に判別・削除できる仕組みになっています。

追加のトピック: AIエージェントとGUI

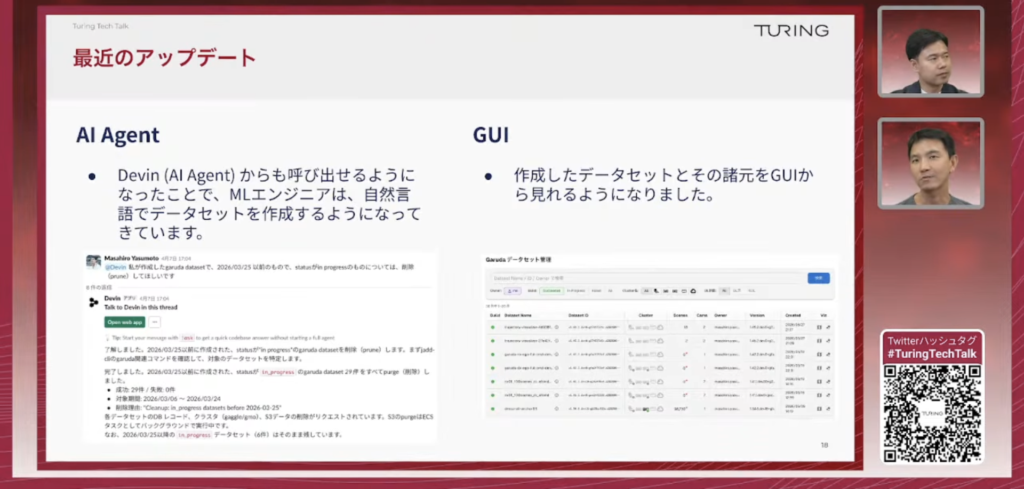
安本:GARUDAのリリース後の追加の取り組みとして、2点あります。1つ目はAIエージェントの活用です。Turingでは「Devin」と呼ばれるAIエージェントを導入しており、Slack上でDevinに話しかけてタスクを依頼すると、裏側で自動的に処理を実行してくれます。ガルーダの各種APIをDevinから呼び出せるようにしたことで、MLエンジニアは従来のCLIやクエリを自分で書く代わりに、自然言語でデータセットの作成や削除を依頼できるようになりました。

安本:2つ目はGUIダッシュボードの整備です。作成したデータセットがどの車両番号のデータをどれくらいの割合含んでいるか、どのエリア(例えばお台場など)のデータがどれくらいの割合を占めるかといった構成を可視化でき、また複数保有するGPUクラスターのうち、どのクラスターに現在どのデータセットがダウンロードされているかも確認できるようになっています。文字ベースの操作が得意なAIエージェントと、地図表示など視覚的な確認が得意なGUIとで、役割分担が進んでいる状況です。なお、GUI上からデータセットを直接ダウンロードする機能は現時点ではまだ実装されておらず、今後の課題です。

Q&A一覧(一部抜粋)

以降は視聴者のQAに回答していきました。詳しくは動画をご覧ください。

  • データはほぼ動画データなのでしょうか?それともカメラ以外のセンサデータなども含まれているのでしょうか?
  • nuScenesはLidar x1とRadarx5も含まれると理解していますが、今のご説明ではそれを除いたnuscenes互換のデータと解釈しました。違っていたらご指摘いただければ幸いです。
  • 動画の長さによって、NVDECでの処理にかかる時間が変わるのかなと思います。複数の動画を並列に処理するのか、単一動画を複数フレームで並列処理しているのか,どちらの方がいいのでしょうか?

チューリングでは、完全自動運転の技術を共に創る仲間を募集しています。今日お話ししたMLOpsチームはもちろんのこと、機械学習エンジニア、リサーチャー、ソフトウェアエンジニア、組み込みエンジニア、インフラエンジニアなど、非常に幅広いエンジニア職種で仲間を募集しています。ご興味のある方は、ぜひ採用ページをご確認ください。多様な職種がありますので、ご自身がどれに当てはまるか、ぜひチェックしてみてください。
TuringTechTalk#41 車両が増えても運用へ ─ OTAとフリート管理で実現する車両運用の省力化

この記事に登場する人
CTO
山口 祐 Yu Yamaguchi
産業技術総合研究所 研究員/米国NIST客員研究員として研究する傍ら、独自にゲームAIの深層学習の開発を開始。日本の囲碁AIプロジェクトの開発代表として、最大1100GPUの並列分散強化学習を設計・開発し、世界大会準優勝、将棋AIでも世界大会優勝などの実績がある。HEROZ株式会社 執行役員を経て、2022年、チューリングに創業メンバーとして参画。2024年8月、CTO就任。基盤AIチームマネージャー兼任。
Driving System1チーム シニアエンジニア
安部 敦 Atsushi Abe
大学院修了後、日本アイ・ビー・エム株式会社に入社。RAS (Reliability, Availability,Serviceability)エンジニアとして複数製品の開発やIBMテープドライブのファームウェア開発に従事。その後、テープストレージ向けファイルシステム「LTFS」の開発を担当する。2017年から2024年までIBM Master Inventorとして活動し、発明者として100件を超える特許を取得。2025年7月にチューリング株式会社へ入社。現在はDriving System 1チームにて、自動運転向け車載システムの開発に取り組んでいる。

はじめに

スクリーンショット 2026-06-25 午後2.31.02

自動運転の開発というとAIモデルに注目が集まりがちですが、実際にはAIを安定して動かすための車載ソフトウェアやOS、計算機、ハードウェアまで含めた基盤づくりが欠かせません。

今回のTech Talkでは、その中でもOTA(Over-the-Air)によるソフトウェア更新と、開発車両を効率よく管理するフリート管理システムに焦点を当てました。

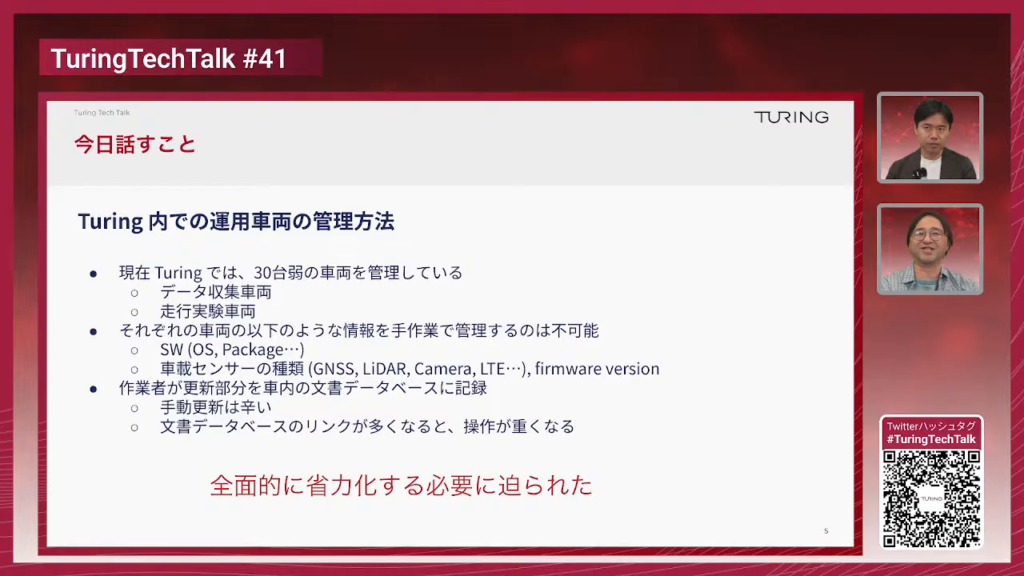
チューリングでは現在約30台の開発車両を運用しており、車両の増加に伴い、ソフトウェアやセンサー構成の管理を手作業で行うことが難しくなっています。

今回はCTOの山口とDriving System 1チーム シニアエンジニアの安部が登壇し、OTA基盤とフリート管理システムについて、その設計思想からシステム構成、安全なアップデートを実現する仕組みまで紹介しました。

※本記事は「Turing Tech Talk #41」の内容をもとに、一部編集のうえお届けします。

OTAとは何か

山口:みなさん、こんにちは。今回のイベント「Turing Tech Talk #41」は、「車両が増えても運用へ。OTAとフリート管理で実現する車両運用の省力化」をテーマにお届けします。私はチューリングCTOの山口です。本日はドライビングシステム1チームのシニアエンジニア・安部さんに来ていただいています。

安部:よろしくお願いします。

山口:今回のタイトルにもなっている「OTA」は、普段あまり聞き慣れない言葉だと思います。まずはOTAとは何か、というところから教えてください。

安部:OTAは「Over-The-Air」の略で、Wi-FiやLTEなどのネットワーク経由でソフトウェアをダウンロードし、アップデートする一連の仕組みのことです。

山口:例えばiPhoneやAndroidでは、OSアップデートやセキュリティパッチが配信されますよね。あのイメージでしょうか。

安部:はい、そのイメージです。iPhoneのアップデートもOTAの一例です。

山口:スマートフォンでは当たり前になっているOTAですが、自動運転車ではどのように活用されているのでしょうか。今回は、このOTAが車両運用とどのようにつながっているのかを詳しく見ていきます。

まずは安部さんの自己紹介をお願いします。

安部:私は1998年に日本IBMへ入社し、26年間、ハードウェアとOSの間にあるレイヤーの開発に携わってきました。テープドライブの開発を長く担当し、現在はチューリングでも同じように、ハードウェアとOSの間にある基盤ソフトウェアを担当しています。OSの管理や、その上で動作するアプリケーションの基盤を整備し、自動運転AIが安定して動作できる環境を構築することが主な役割です。

山口:安部さんが所属するドライビングシステム1チームでは、車載アプリケーションだけでなく、OSやカーネル、計算機周りまで幅広く開発しています。

チューリングは自動運転AIを開発している会社というイメージを持たれることが多いですが、実際にはAIだけではなく、それを支えるソフトウェアやOS、車載計算機、さらにはハードウェアまで自社で開発しています。

安部:ソフトウェアだけでなく、ハードウェアや配線、電源周りなど、車両全体を対象に開発しています。

山口:今回は、その基盤となる車載システムがどのように管理され、どのようにOTAでアップデートされているのかをご紹介します。

今回はTech Talkでも初めて扱うテーマです。普段あまりお見せすることのない、車載システムの基盤やOTAの仕組みについて、安部さんに詳しく解説してもらいます。


車両が増えると何が難しくなるのか

山口:今回のテーマは「膨らむ更新・管理コストを、OTAとフリート管理でどう解決するか」です。現在チューリングでは約30台の開発車両を運用していますが、データ収集用の車両や実験用の車両など用途はさまざまで、運用形態も日々変化しています。

安部:そうですね。運用が変わることも多く、どの車両がどの用途なのか、常に把握し続ける必要があります。

山口:10台を超えたあたりから、手作業で車両を管理するのはかなり難しくなってきました。

安部:当初はAnsibleを使って各車両へソフトウェアを配布し、センサーの更新も手作業で行っていました。ただ、更新時にエラーが発生すると最初からやり直しになり、全車両への展開に2週間かかることもありました。また、ソフトウェアだけではなく、車両に搭載するハードウェアも変化しています。以前はLiDARを搭載していましたが、現在はすべてカメラベースの構成へ移行しました。GNSSなどの周辺機器も世代交代に合わせて入れ替わっており、どの車両にどのセンサーが搭載されているかも含めて管理する必要があります。

チューリングのFleet管理システム

山口:そこで構築したのが、今回ご紹介するOTAとフリート管理システムです。このあと、その仕組みについて詳しく見ていきます。以前よりも構成はシンプルになりましたが、その一方で、複数車両の状態をどう管理していくかが重要になってきました。

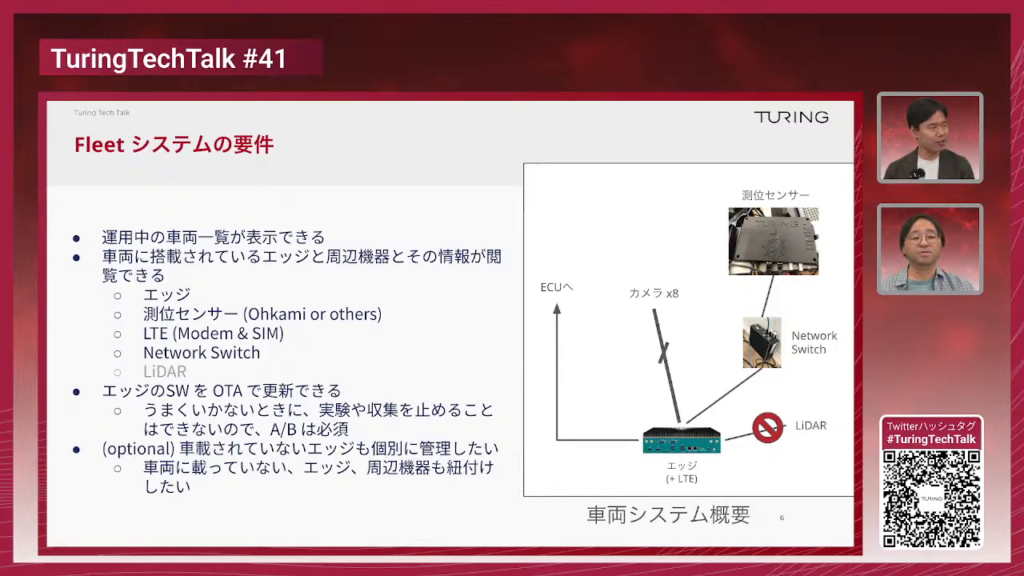
安部:約30台の車両を運用する中で、

  • 車両一覧を見たい
  • 車両に搭載されているエッジや周辺機器の情報を確認したい
  • 車両に載っていない開発用の計算機も管理したい

といった要望が出てきました。また、OTAではネットワーク経由でソフトウェアを更新しますが、更新に失敗して車両が使えなくなると、実験や開発が止まってしまいます。そのため、安全に更新できるようA/Bアップデート方式を採用しました。

このような要件をもとに構築したのが、今回ご紹介するフリート管理システムです。完成したシステムでは、車両IDごとの一覧から、それぞれの車両に搭載されているセンサーやシリアル番号、ソフトウェアの状態などを確認できるようになっています。

現在、約30台の開発車両を管理していて、それぞれがデータ収集を行ったり、AIチームが新しいソフトウェアを載せて走行実験を行ったりと、日々さまざまな用途で運用されています。

10台ほどまでは手作業で管理していました。新しいソフトウェアが完成すると、Ethernet経由でAnsibleを使って各車両へデプロイし、センサーのファームウェア更新も個別に対応していました。更新内容は文書データベースへ記録するなど、すべて手作業で管理していたんです。

ただ、Ansibleによる更新ではエラーが発生することも多く、そのたびに最初からやり直さなければなりませんでした。すべての車両へ展開するまでに2週間ほどかかることもあり、このままでは運用が成り立たないと感じ、システム化を進めることにしました。

山口:ソフトウェアだけではなく、車両に搭載するセンサー構成もかなり変わってきましたよね。以前はデータ収集のためにLiDARを多く搭載していましたが、現在はすべて取り外しています。

安部:はい。現在はLiDARは搭載していません。

山口:GNSSも新しい機種へ置き換えていますし、ハードウェア自体もアップデートが続いています。ソフトウェアだけではなく、「どの車両にどのハードウェアが載っているのか」まで含めて管理する必要が出てきたわけですね。

安部:まずは、チューリングの車載システムの構成をご紹介します。

車両には「エッジ」と呼んでいる車載計算機を搭載しており、NVIDIA Orin SoCを採用しています。エッジにはLTEモジュールとSIMが搭載されていて、外部ネットワークと通信できるようになっています。

さらに、7〜8台のGMSLカメラを接続し、ネットワークスイッチを介してGNSSなどの測位センサーから位置情報を取得しています。以前はLiDARも搭載していましたが、現在はカメラベースの構成へ移行しました。最終的にはECUへ制御指令を送り、車両を制御しています。

山口:車載システムに馴染みのない方向けに補足すると、チューリングの自動運転はカメラベースです。車両の周囲に配置した7台のカメラから取得した映像を、Orin上でリアルタイムに処理しています。また、IMUやGNSSによって車両の位置や姿勢を推定しています。

安部:GNSSはRTK補正情報を利用するため、LTE経由で外部と通信しています。また、平和島の車両基地ではWi-Fiにも接続できるようになっており、大容量のOTAアップデートはWi-Fi経由で実施しています。

山口:以前よりも構成はシンプルになりましたが、その一方で複数車両の状態を管理することが重要になっています。

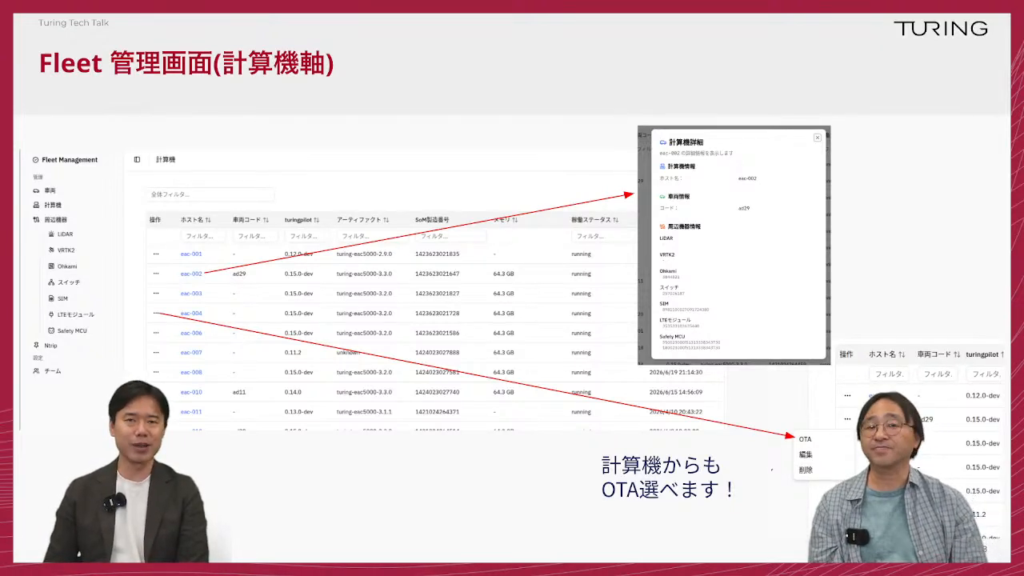
安部:約30台の車両を運用する中で、「車両一覧を見たい」「開発用の計算機もまとめて管理したい」「周辺機器の情報も確認したい」といった要望が出てきました。そこで構築したのが、このフリート管理システムです。完成したシステムでは、車両IDごとの一覧から、それぞれの車両に搭載されているセンサーやシリアル番号、ソフトウェアの状態などを確認できます。

山口:ブラウザからアクセスできるWebアプリケーションになっていて、社内のメンバーは車両ごとのOSやソフトウェアのバージョンも確認できます。

安部:当初は、この管理画面から車両ごとにOTAを実行していました。ただ、30台規模になると手動運用にも限界があります。現在はスマートフォンのアップデートと同じように、車載ディスプレイへ更新通知を表示し、ドライバーがボタンを押すだけでアップデートできるようにしています。そのため、管理画面からOTAを実行することはほとんどありません。

山口:車両だけではなく、開発用の計算機も同じシステムで管理しているんですよね。

安部:はい。開発用の計算機は約75台あり、自動テストやCIで使用するマシンも、すべてこのシステムで管理しています。また、周辺機器ごとの一覧表示にも対応しています。車両・計算機・周辺機器はリレーショナルデータベースで紐付けられているため、それぞれの視点から状態を確認できます。固定資産の管理にも活用しています。


OTA基盤のアーキテクチャ

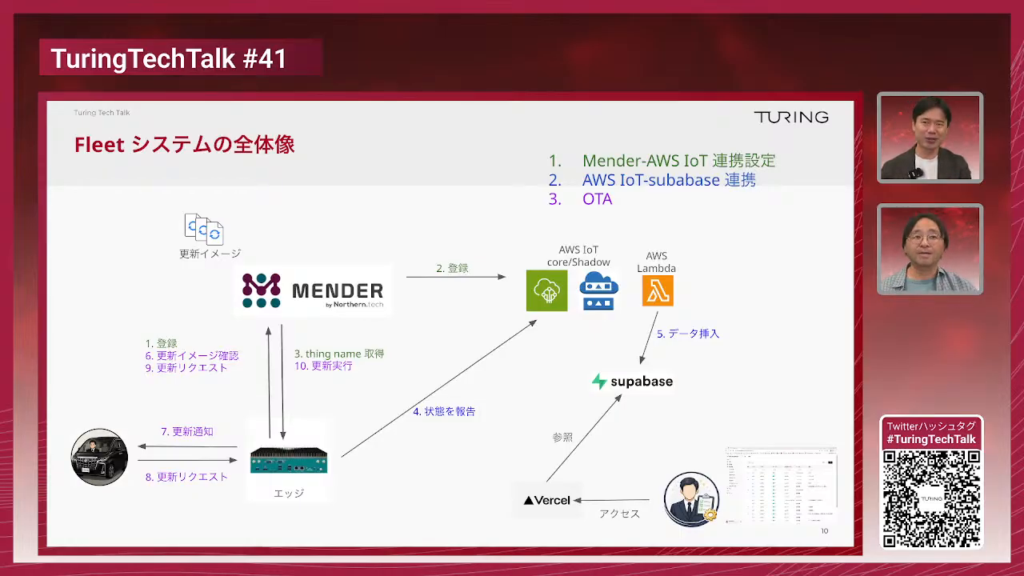
安部:OTA基盤は、AWSとMenderを中心に構成しています。フロントエンドにはVercel、データベースにはSupabaseを採用しています。MenderはOTAの配信や進捗管理を担うサービスです。OTA基盤をすべて自前で実装するよりも、実績のあるサービスを活用した方が開発スピードを上げられると考え、採用しました。また、Menderと管理画面を連携させるためにAWS IoT Coreを利用しています。エッジから送られてくる車両の状態はIoT Coreを経由し、最終的にデータベースへ反映されます。

山口:MenderはOTAイメージを配信する役割を担っています。一方で、「どの車両にどのバージョンが入っているのか」といった情報は、AWS IoT Coreを経由してSupabaseへ保存し、Vercel上のWebアプリケーションで可視化しています。

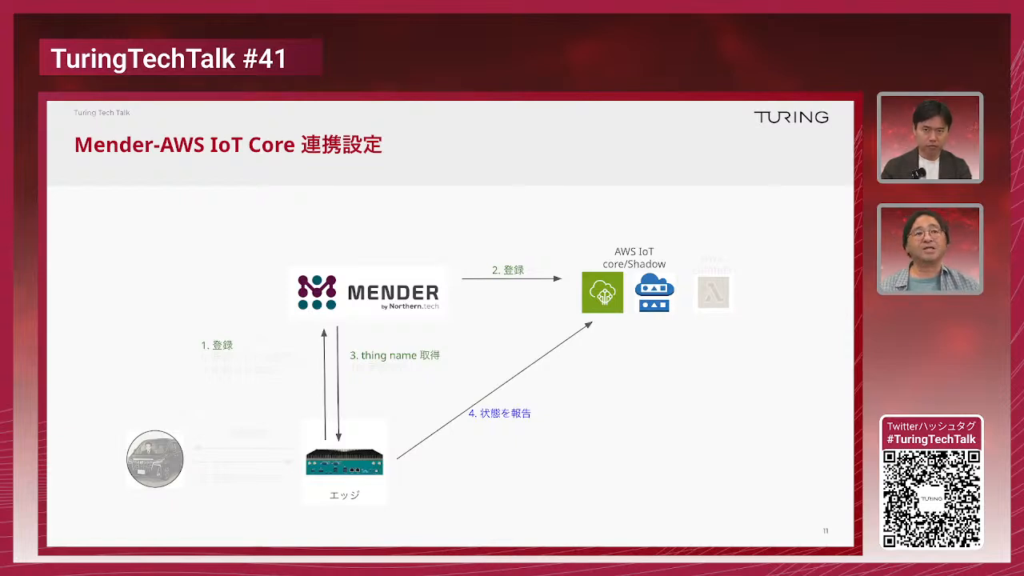
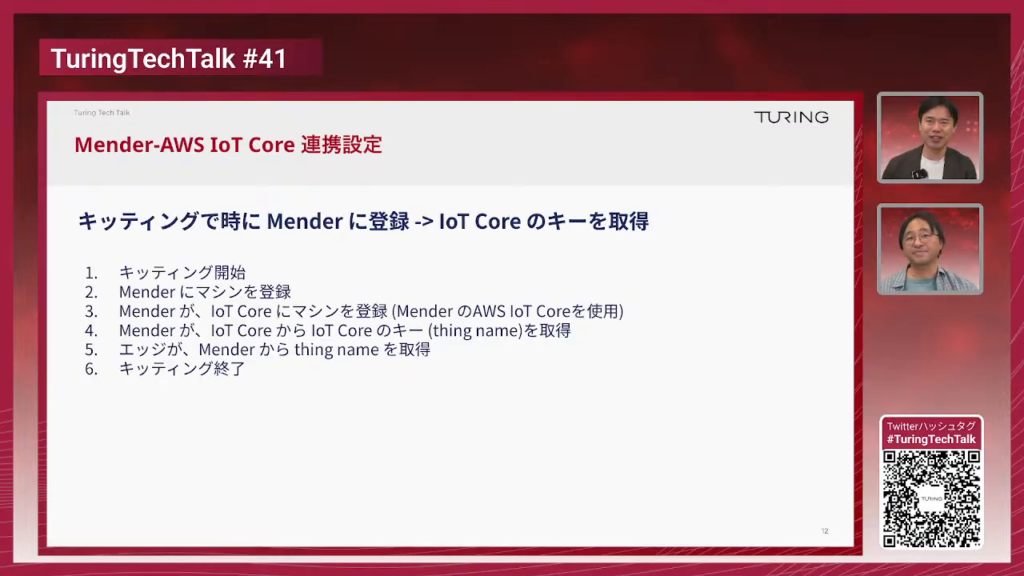
安部:車両を初期セットアップする際は、まずAnsibleでキッティングを行い、Menderへ登録します。

このときAWS IoT Coreにも自動でThing Nameが登録され、エッジはその識別子を使ってIoT Coreへ接続します。その後、接続されているセンサーやソフトウェアの状態をJSON形式でAWS IoT CoreのDevice Shadowへ1分ごとに送信しています。キッティングが完了すると、接続されているセンサーやソフトウェアの状態をJSON形式でAWS IoT CoreのDevice Shadowへ1分ごとに送信します。

山口:1分ごとの更新はかなり頻度が高いですね。

安部:目的はバージョン管理だけではありません。センサーの故障や接続断などを検知したり、エッジが正常に稼働しているかを監視したりするためにも利用しています。

山口:AWS側ではどのように処理しているのでしょうか。

安部:Device Shadowへデータが届くとAWS Lambdaが実行され、Supabaseの情報を更新します。送信するデータは1KB程度なので、負荷も非常に小さく運用できています。


OTA更新の仕組み

山口:実際のOTA更新はどのような流れで行われるのでしょうか。

安部:車両を起動すると、新しいソフトウェアがある場合はディスプレイへ通知が表示されます。ドライバーが更新を開始すると、エッジがMenderへリクエストを送り、OTAが実行されます。更新イメージは約5GBあります。LTE回線ではなく、車両基地のWi-Fiを利用して配信しており、更新時間は約10分です。ドライバーが朝出社して更新を開始し、その間に準備をしているとアップデートが完了するイメージです。

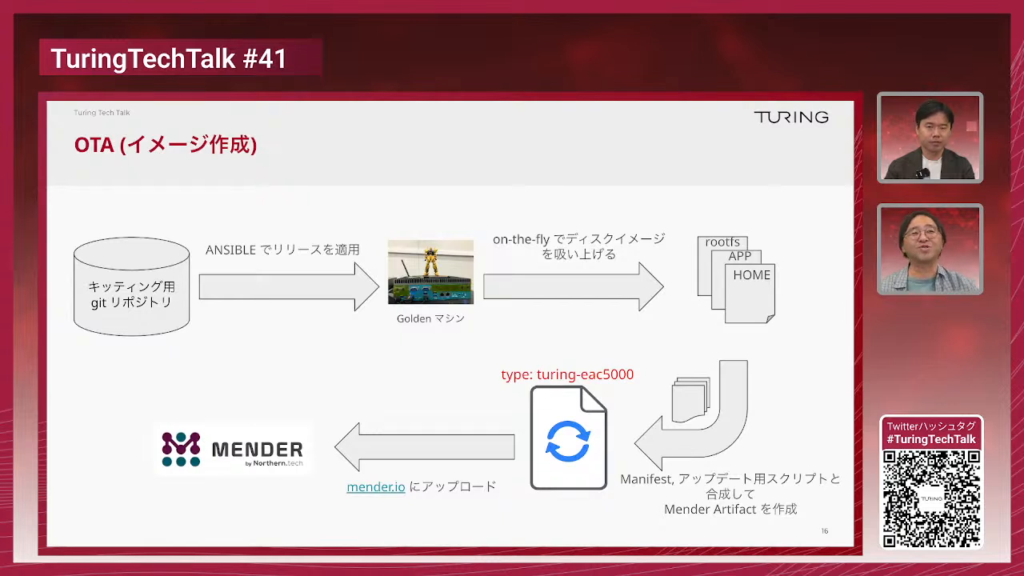
安部:ソフトウェアの作成方法も見直しました。以前のように各車両へAnsibleで個別更新するのではなく、「ゴールデンイメージ」となる基準環境を作成し、そのイメージをOTAで配信しています。

山口:ゴールデンイメージをアップロードした後は、各車両がバージョンを比較し、必要な場合だけ更新する仕組みになっています。

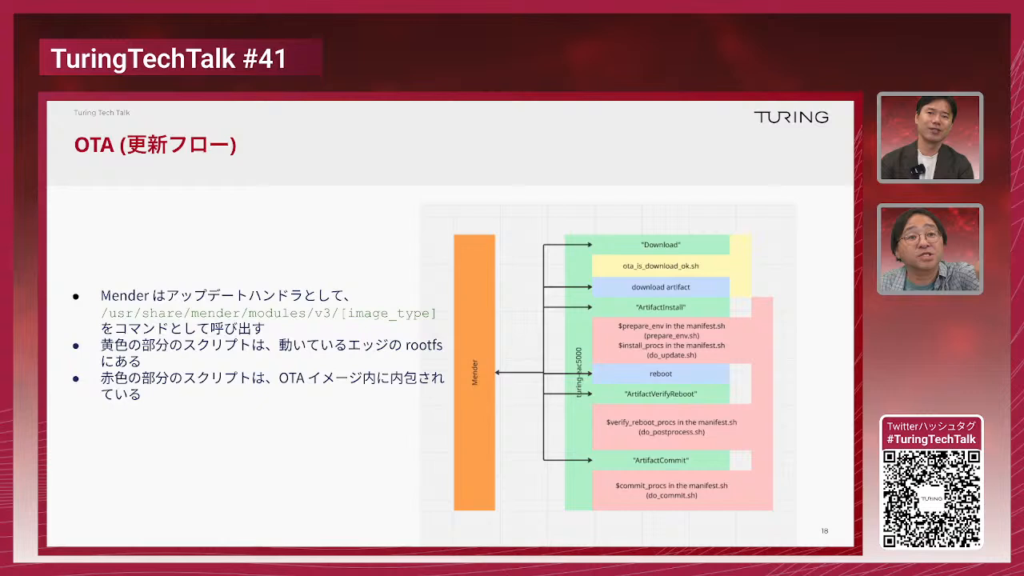
安部: 更新処理では、MenderがOTAの更新ハンドラを呼び出します。

Mender自体は更新処理の入口を担当しており、実際の更新処理はOTAイメージ内に含まれているスクリプトが実行します。

イメージのダウンロード後、更新スクリプトの実行、再起動、起動確認まで順番に処理が進み、最後に正常に起動したことを確認して更新が完了します。


A/Bアップデートによる安全な更新

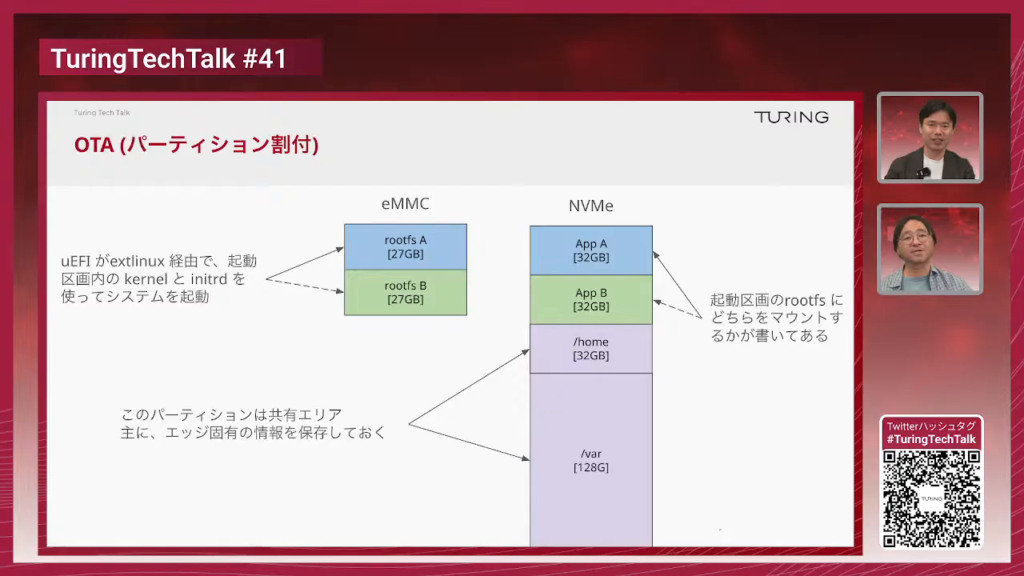
安部:OTAでは、更新に失敗して車両が起動しなくなることは避けなければなりません。そのため、エッジにはeMMCとNVMeを搭載し、システム領域はA/Bの2つのパーティションに分けています。

例えばA領域で動作している場合は、B領域へ新しいイメージを書き込みます。更新が正常に完了したことを確認してから起動先をBへ切り替えるため、万が一失敗しても元のA領域から起動できます。SSHキーなどの固有情報は共通領域へ保存しているため、更新後もそのまま利用できます。

山口:スマートフォンのOSアップデートと同じ考え方ですね。

安部:Menderは更新処理の入り口を担当するだけで、実際の更新処理はイメージ内のスクリプトで制御しています。Dockerコンテナが正常に起動することまで確認し、問題があればエラーとして更新を中止し、元の環境へ戻るようにしています。

山口:Orinは最初からA/Bアップデートに対応していたのでしょうか。

安部:NVIDIAの開発キットでは対応していましたが、現在利用している車載計算機については、供給元に対応していただきました。

山口:現在はどのくらいの頻度で更新していますか。

安部:新しいリリースは月に1回程度です。運用管理チームと相談しながら展開し、およそ1週間で全車両への更新を完了しています。開発用の計算機は、エンジニアの作業状況に応じて更新を後回しにできるようにしています。


今後の展望

山口:自動運転業界ではSDV(Software Defined Vehicle)が進み、車載システム全体をOTAで更新することが当たり前になりつつあります。今後の改善点はありますか。

安部:現在は約5GBのイメージを配信していますが、変更のない部分まで毎回ダウンロードするのは効率的ではありません。今後は差分アップデートに対応し、更新が必要なモジュールだけを配信することで、数MBから数百MB程度まで通信量を削減できる仕組みを実現したいと考えています。

山口:車両が300台、1,000台と増えていくと、ネットワーク全体を考えた配信設計も重要になりますね。

安部:CDNやMenderのローリングアップデート機能を活用しながら、ネットワーク負荷を抑えつつ、安全に更新を展開できる仕組みへ発展させていきたいと思っています。


https://youtube.com/live/W_FeYLLch90

チューリングでは、完全自動運転の技術を共に創る仲間を募集しています。今日お話ししたDriving System 1チームはもちろんのこと、機械学習エンジニア、リサーチャー、ソフトウェアエンジニア、組み込みエンジニア、インフラエンジニアなど、非常に幅広いエンジニア職種で仲間を募集しています。ご興味のある方は、ぜひ採用ページをご確認ください。多様な職種がありますので、ご自身がどれに当てはまるか、ぜひチェックしてみてください。
TuringTechTalk#40 世界モデル時代の自動運転 ──2026年の最新トレンドとリアルタイム処理技術

この記事に登場する人
CTO
山口 祐 Yu Yamaguchi
産業技術総合研究所 研究員/米国NIST客員研究員として研究する傍ら、独自にゲームAIの深層学習の開発を開始。日本の囲碁AIプロジェクトの開発代表として、最大1100GPUの並列分散強化学習を設計・開発し、世界大会準優勝、将棋AIでも世界大会優勝などの実績がある。HEROZ株式会社 執行役員を経て、2022年、チューリングに創業メンバーとして参画。2024年8月、CTO就任。基盤AIチームマネージャー兼任。
Driving AI3チームリーダー
石原 啓志 Keishi Ishihara
豊橋技術科学大学大学院と東フィンランド大学のダブルディグリープログラムを修了し、修士(工学)および MSc in Computer Science and Engineering を取得。修了後、本田技術研究所に新卒入社し、先進安全支援システムの機能開発・検証に従事。その後、株式会社ALBERT(のちにアクセンチュアに統合)に入社し、E2E自動運転におけるTrajectory予測の研究や、大規模言語モデルの研究開発に取り組む。2024年、チューリング入社。E2E自動運転モデルおよび世界モデルの研究開発を推進し、自動運転向けVQAデータセットSTRIDE-QAを提案した論文をAAAI 2026で口頭発表。

はじめに

チューリングでは、環境認識から経路計画、運転制御までを単一のAIで行うE2E(End-to-End)自動運転と、大規模基盤モデルの研究開発を進めています。2026年はVLAの次の潮流として、動画生成モデルや世界モデル(World Model)をロボットや自動運転へ接続する研究が急速に盛り上がっています。

今回のTechTalkでは、CTOの山口と、Driving AI3チームの石原が登壇。2026年現在の世界モデルの外部トレンドを整理し、世界モデルタスクで学習する重要性を議論。更にチューリングとしての見立てと今後の方針をご紹介します。

※本記事はTuringTechTalk#40の内容を元に一部編集してお届けします。

今回は「世界モデル」回

山口:皆さん、こんにちは。TuringTechTalk第40回「世界モデル時代の自動運転──2026年の最新トレンドとリアルタイム処理技術」を開始します。本日は世界モデルを開発しているチームリーダーの石原さんに来てもらってます。石原さん、今日はよろしくお願いします。

石原:よろしくお願いします。

山口:今回は世界モデル回ということで、このテックトークでは世界モデルについてこれまで何度か取り上げてきたんですけれども、どの回も結構人気があって、今回も非常にご注目をいただいているところかなと思っております。それでは石原さん、簡単に自己紹介をお願いします。

石原:はい。Driving AI 3チームのチームリーダーをやっております石原と申します。2021年に大学院を卒業した後、本田技術研究所に新卒で入社しまして、栃木の四輪のR&Dセンターで務めておりました。そちらでは、いわゆるADAS(Advanced Driver-Assistance Systems)、車の安全支援システムの一部の機能開発を担当しておりました。その後転職をしまして、株式会社ALBERTというところに入社しまして、そちらではE2E(End-to-End)の自動運転開発をテーマにした研究をやっておりました。その後会社がアクセンチュアに統合になりましたので、自分自身も転籍という形で移動して、そちらで1年半ほど働いた後、2024年の10月にチューリングに入社したという経歴になっております。

山口:石原さんは一貫してリサーチ寄りのことを担当するチームに所属していたのかなと思っていて、最初期の方は例えば強化学習とかVLM(Vision-Language Model)とか、こういったところのデータセットを作るみたいなところとか、世界モデルみたいなところも当然入った当初からいろいろとやっていて、多分最初にチューリングでやった仕事はその世界モデルのベンチマークを作るみたいなところが論文として出ていたところかなと思います。合ってますよね。

石原:はい。その通りですね。

山口:チューリングの中でも非常に世界モデルに造詣が深いというところですね。今日はこの世界モデルの開発、あるいは最近のトレンドですね、2025年から2026年にかけていろんな世界モデルが広がりを持ってきているというところなので、この辺りのトレンドについて是非色々と聞いていこうかなと思っております。


世界モデルとは何か

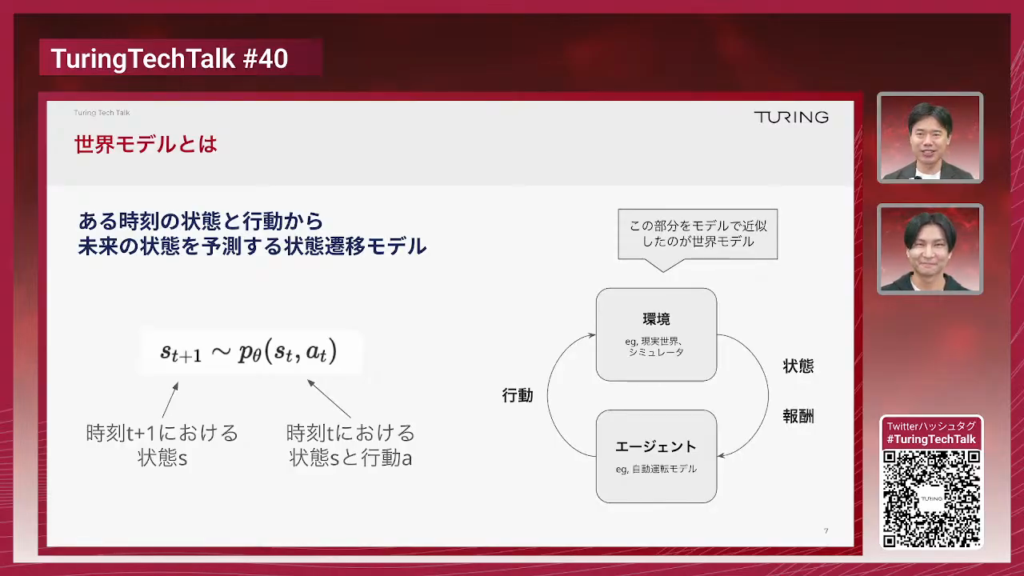
石原:まず、世界モデルの話をする上で絶対毎回話さなきゃいけないと思うんですが、世界モデルとは何かということです。ある時刻の状態と行動から未来の状態を予測する、状態遷移モデルであるという定義が一番標準的な定義かなと思っております。今回のTech Talkでもこの定義に則って話を進めていく予定です。

山口:いきなり数式が出てきて半分ぐらいの人がブラウザバックしてしまったんじゃないかと心配なので、もう少し説明を聞きたいなと思います。右の図の方が多分分かりやすいかなと思うので聞いていこうと思うんですが、これはよくある強化学習の……

石原:そうですね。マルコフ連鎖的な、環境とエージェントが決定的に相互作用してくぞみたいな感じです。

山口:このエージェントって書いてるのが例えば人間だったりAIだったりするんですが、要するになんか自律的に行動するものだという風に想像していいかなと思うんですけれども、それは自分の意思で動かせると。で、自分の意思で動かせないけど、なんか影響与えられるものとして要するに周囲の環境、エンバイラメントというものがあるという、そういう想定ですよね。

石原:はい。

山口:このエンバイラメントは、例えばゲームで言うと将棋だったら将棋盤、囲碁だったらその碁盤と碁石で、自動運転だったら本当に道路とか周りの車とか信号機とか歩行者とかそういったものがこう環境になっていくというイメージで合ってますか?

石原:はい、合ってます。

山口:エージェントはそれを例えば将棋だったらプレイヤーだったり、自動運転だったら車を運転する人がこうエージェントになってくるというところですよね。この環境、世界と言い替えていいと思うんですけど、この世界をモデル化したのがつまり…。

石原:世界モデルです。

山口:完全に理解しました。数式のところで言いますと、とにかく未来の世界がどうなっているかを予測するモデルですね。

石原:はい。その通りです。

山口:これが世界モデルと言って、平たく言っていいかなと思っていて、人間も頭の中で無意識のうちにシミュレートしてるかなと思っていて、例えばそのガラスのコップを適当にこの辺で放り投げたらどういう風な軌跡を描いて落ちて割れるみたいな、そういった想像ができる能力は当然人間は持ってますし、椅子に座るとかドアを開けるとかそういったものでも実はなんとなく未来の予想をしてたり、当然運転でも今ここでハンドルをこういう風に切ったらどういう風に車が動くかみたいなところをイメージしながら人間は運転して、それが現実の世界とちょっとずつ補正をしながら動いてるみたいな。そんな感じで大丈夫ですか?

石原:そんな感じで大丈夫だと思います。


2026年に世界モデルが急増した背景

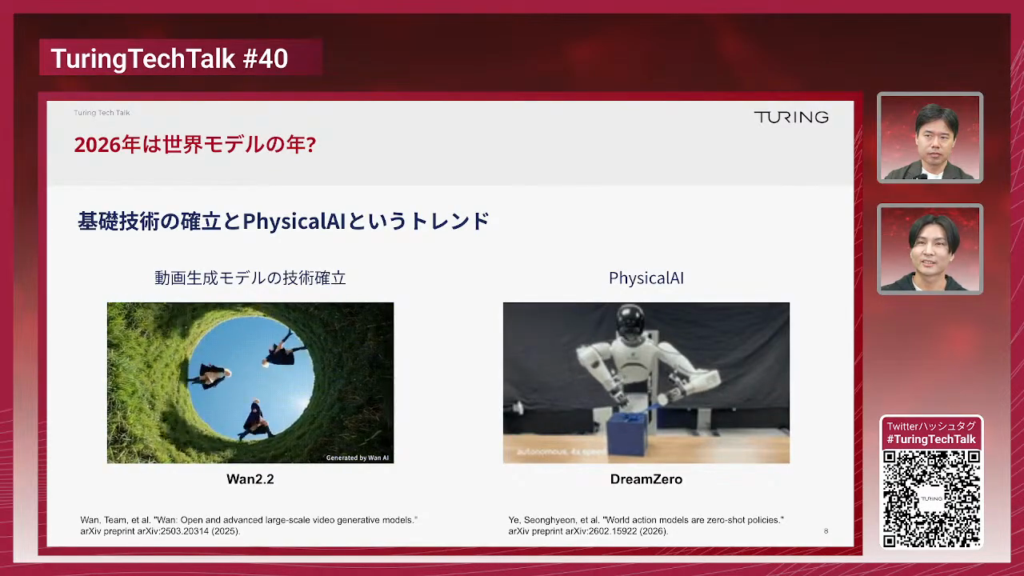
石原:2026年になってからかなりの世界モデルが登場しているという状況になってきておりまして、これがなぜなのかという背景を自分なりに考えてみたんですけれども、2つあるかなと思っていて、1つは基礎的な技術が確立してきたということと、もう1つがフィジカルAIというトレンドが来ているということがあるかなと思います。

石原:基礎技術の確立の方なんですけれども、これは冒頭で山口さんからもご説明があった動画生成モデルの技術の確立というところだと思います。動画生成モデルというと、プロンプトを投げると動画を作ってくれるAIというのが一般的に知られているところだと思うんですけれども、これは非常に大量の動画を使って非常にたくさんの計算資源を投入して作らなきゃいけないものなので、基本的にはOpenAIとか、クローズドなAIとして開発がされてきたんですけれども、最近はこれがオープンなモデルというのもポツポツ出てきています。その1つが「Wan」という、中国のAlibabaが出したオープンな動画生成モデルで、これは研究者が自分で使って開発とか研究に役立てることができると。オープンなモデルが登場してきているのが1つの要素になっているんじゃないかと思います。

もう1つがフィジカルAIですね。ロボットアームのタスクとかヒューマノイドのタスクを考えたとしても、例えばコップを離すと落ちていって割れるかもしれないみたいなことを事前に学習できている世界モデルがあれば、フィジカルAI・ロボットのAIを作る方にも役立てることができるんじゃないかというところで、そちらにも応用が進んでいます。基礎が成り立ってきていて、フィジカルAIというトレンドが来ている、だから世界モデルが求められているという仮説を持っております。

山口:動画のモデルで言うと一般的には、例えばOpenAIが出しているSoraとかが最近なんかサービス終了しちゃいましたけれども一時期すごい話題になって、すごいリアルな映像を出せるぞみたいなところで話題になりましたし、オープンソースの文脈で言うとそのOpenSoraというSoraをオープンソースで作るぞみたいなプロジェクトも昔あったような気がしていますけれども、これがいろんな研究が進んできて、本当に実用的に使えるようなオープンな動画生成モデルが一般的になってきた。テクニカルにはコモディティ化してきたといったところですよね。

ロボティクス・フィジカルAIという文脈でロボティクスの話が出てきましたけれども、車載カメラの例みたいなやつっていうのはこれまでもなんかあったんですか?

石原:そうですね。いくつかあったかなと思いますね。今パッと思いつくところで言うと、我々の競合ですけれどもWayveですね。Wayveはよく動画を使った研究プロジェクトというのをたくさんやってきていて、自分が今覚えている範囲で言うと2018年あたりから動画を応用する研究というのは出してきたりしていましたね。


自動運転×世界モデル:各社の最新動向

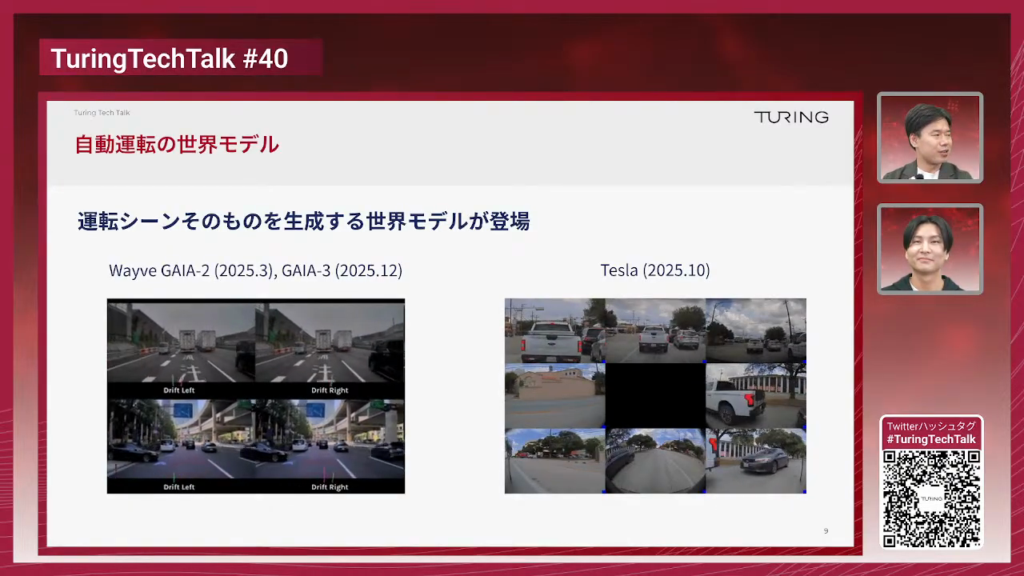
石原:自動運転の世界モデルを語る上では外せないと思うんですけど、このGAIAシリーズというのはWayveがGAIA-1、2、3と出しているんですが、これは自動運転の世界モデルとして外せないところかなと思っています。GAIA-3は特に画像のクオリティが非常に高くて、かつ世界モデルなのでこう動画入力とアクションの入力があるんですけども、この入力したアクション(トラジェクトリ)に忠実に行動を再現した世界を生成することができるという風に言われています。

山口:GAIA-1は2023年に出ていますよね。CVPRという画像系のトップカンファレンスがあるんですけれども、23年のワークショップで発表されたのが基本的には最初かなと思っています。私たまたま現地(バンクーバー)で行ってそこのワークショップに参加していたんですよ。当時はWayveのことあんまり知らなくて、プレゼンしていたのはWayveのCEOのAlex Kendallさんだったんですけども、その人がバンとこの動画のスライドを出してきて、もうなんかカメラ映像いっぱい撮ってんなと思ったらそれは全部生成動画だったみたいな話をプレゼンで始めて、非常に当時印象に残っていますね。そこから非常にWayveの知名度も上がっていったのかなと思っています。

Teslaも去年のICCV(International Conference on Computer Vision)、ハワイであったICCVで、久しぶりにTeslaのAIの責任者の人がなんか2年ぶりぐらいこういった場に出てくるみたいなところで発表したのがTeslaのワールドモデルの話でしたよね。各社結構こういうの作っているというところですね。

ちょっと聞いておきたいんですけど、いわゆる世界モデルと動画生成モデルの違いですね。アクションにこう追随するみたいなところは別に普通の動画生成モデルでもできるところはあると思うんですけど、それとワールドモデルの厳密な区別みたいなやつがあったりするんでしょうか?

石原:厳密な区別は個人的に結構難しいかなとは思うんですけど。動画生成モデルというのは基本的にはテキストのプロンプトを入れて、ある場合はスタートのフレームがあってそこから先を作ってくれるというものですね。ただし世界モデルになると毎フレームその時のアクションを入れなきゃいけないというのが大きな違いになるかなと思います。

山口:つまり映像生成のモデルは無からも作れるし、テキストの指示も出せるし、アクションとか動作を入れることもできるしいろんな入力がありますけど、世界モデルはどっちかというと今この状態があって、その状態が未来どうなっていくかみたいなところに基本的にフォーカスしているという、目的の違いみたいなやつがあるということですかね。

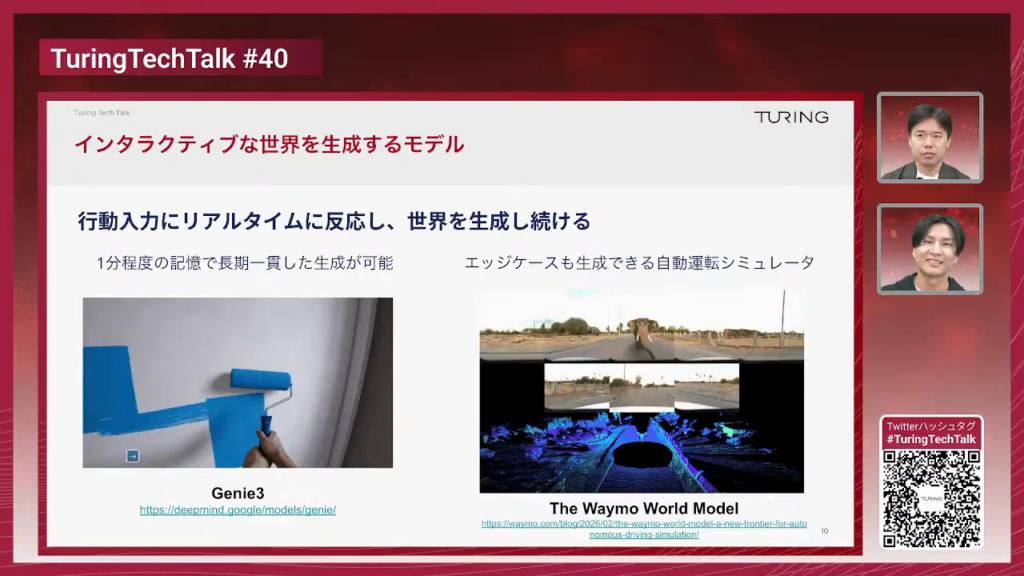
石原:一括にテキストプロンプトを入れて、ある場合は最初のフレームを指定して数秒間の動画を作るというのがこれまでの動画生成モデルでした。ここで紹介しているのはですね、インタラクティブな世界を生成することができるモデルということで、一括に長い動画を作るのではなく、リアルタイムで行動入力に反応し続けながら次のフレームを逐次的に作っていく世界モデルというのが特に今年凄くホットな分野になっております。

山口:リアルタイムにこういったものを生成することってできるんですか?

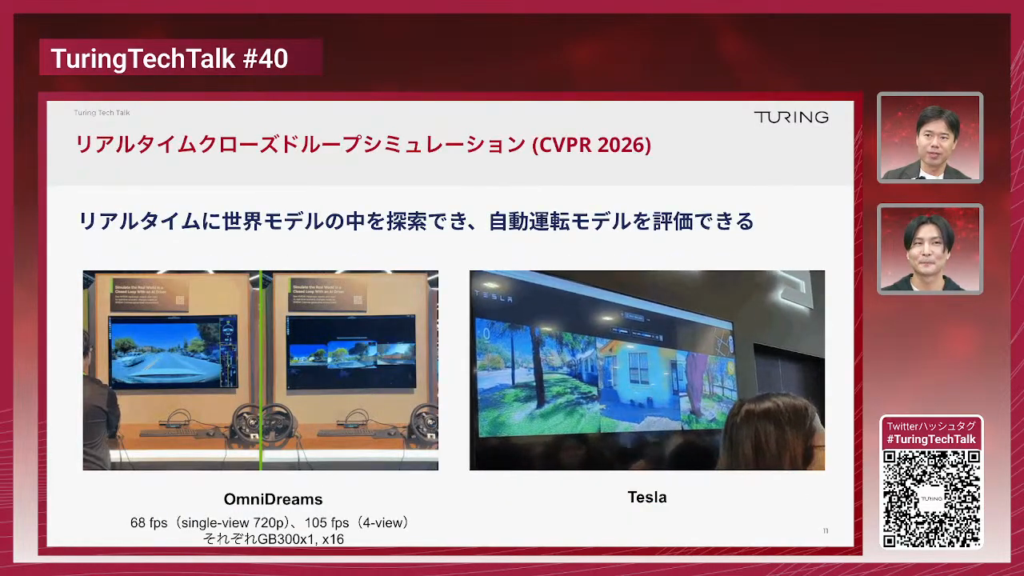
石原:これはできます。技術的には難しいんですけど、それができるようになってきたのが2026年です。

石原:左がNVIDIAが出しているOmniDreamsで、右がTeslaの展示ですね。

山口:CVPR 2026というのは先々週、アメリカのデンバーで行われていて、チューリングからも論文発表があったので何人か社員が行っていたんですが、そこでNVIDIAとTeslaがブースを出していて、その展示を撮ってきたというところになりますね。Teslaの方を見るとどうですか?ちょっと荒いですか?なんか見た目。

石原:ちょっとタイミングが悪かったのかもしれないんですけど、道路じゃなくて変なところに入っていて。苦手なところだったかもしれないんですけれども、バックして道に戻るみたいな動作も生成できているっぽいので、かなりこれはすごいなと思っております。

山口:ちょっと段差乗り越えるみたいな動きも、カメラのところだと地面の凹凸を拾ってそうな動きもしていますね。結構リアルな印象があります。

石原:結構リアルですね。


チューリングで開発している世界モデル

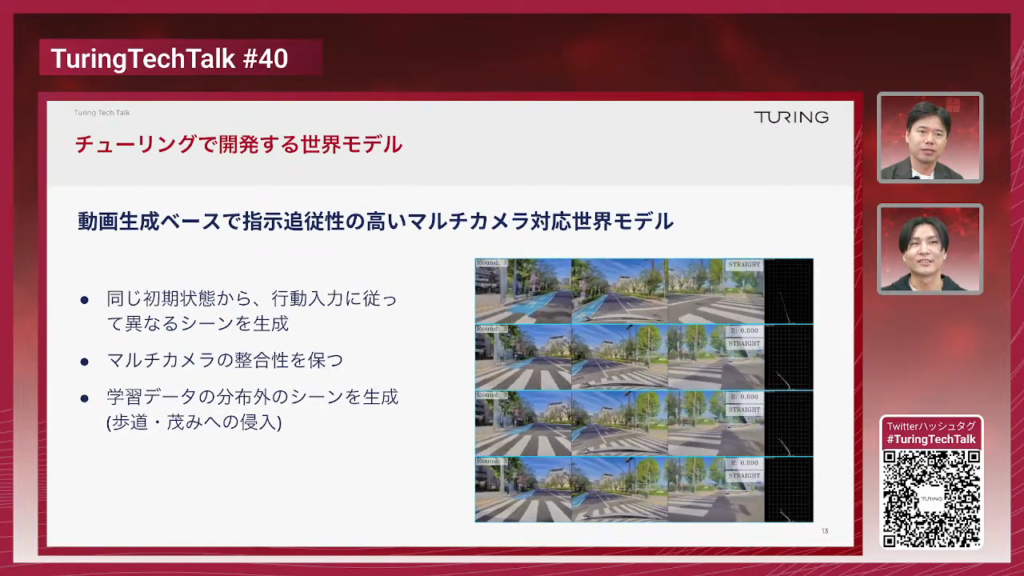
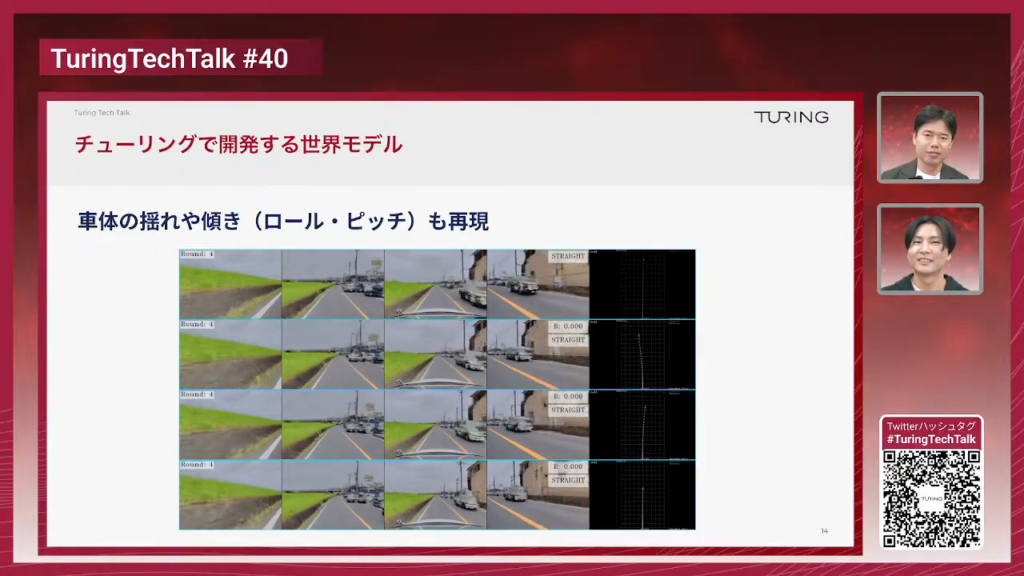
石原:チューリングで開発している世界モデルの紹介になります。この世界モデルが生成しているシーンは、動画生成ベースで、指示追従性(アクションへの指示への追従性)が高くかつマルチカメラで生成できる世界モデルシミュレータということになっております。

右側の動画の一番右端に出ている黒いところにトラジェクトリが映っていると思うんですけど、これで条件付けをした世界が生成されていまして、4段あると思うんですけど、それぞれ違うアクションを指示していて違うシーンが生成されているという例になっております。

山口:オリジナルのカメラ映像、この場合だとカメラが3つあってフロントと斜め左・斜め右みたいな感じでカメラが付いていて、そのオリジナルの映像から途中からこんな感じで動いているみたいな指示をこの右側の線のように指示を行って、その通りに映像が出てきている様子がこの4つで比較できるということですね。一番下とかはこれ止まるように指示しているということですか?

石原:そうです。これはまさに止まるように指示をしていて、右側に出ているトラジェクトリを見ると短くなっていって、最後は完全に停止するというアクションになっています。

山口:ちゃんと止まれるし走れるし曲がれるというところで、車の動きをちゃんと再現できるというようなマルチカメラの世界モデルを作っているということですね。

石原:もう1つ例をあげているんですけれども、こちらは車体の揺れ、カメラがよく見ると横に揺れたりとか縦方向に揺れたりとかというのがよく見ると分かる例になっておりまして、特に2段目のところは最初のフレームは道の真ん中にいてそこから左側にはみ出るようなアクションを入れています。そうすると左側の斜めになっているところに乗り上げていって車体もちょっと右に傾いているみたいな映像が生成できていたりとか、一番下とかは完全に停止したら左側の草木がいい感じに揺れているシーンとかも結構再現できていて、よく生成できている例かなと思っております。

山口:単純にその車が水平移動していくだけじゃなくて、車の車体としてのリアルな映像を生成するみたいなところですね。実際の車ってずっと同じ視点で動いていくわけじゃなくて、ブレーキかけたらちょっと前荷重になってカメラとしてはこのピッチ方向が下になって、逆に加速すると後ろ荷重になってちょっと上向くみたいなのは皆さんも直感的に分かるかなと思いますし、カーブする時も、例えば右カーブで曲がっていくような時には車ってこう微妙に遠心力というか外側に基本的に傾いたりしますし、そういったところの情報もなんとなく再現しているということですね。でも傾きの情報とかは別に指示を与えていなくてなんかよしなにやってくれているみたいな感じなんですか?

石原:これはもう完全にモデルが学習してくれていて、言ってしまえばよしなにやってくれているということになりますね。

山口:道を走っているうちは多分いいと思うんですけど、草むらに突っ込んでいったりとか建物に突っ込んでいったりとかするとさすがに崩れてしまうというのは仕方ないところですか?

石原:これは仕方ないところだと思っております。基本的にこの学習データはチューリング社内で実際の道を走行して収集した走行データを元にこの世界モデルの学習を行っているんですけれども、基本的にはこのE2Eのモデル開発をするために収集した走行なので、プロのドライバーさんが素晴らしい運転をして完璧な走行データを取ってくれています。なので、右の歩道に突っ込んでいくとかのデータは当然普通に運転していたら得られないような映像なので学習データとしては少ない。学習データとして少ないとなかなか再現するのは一般的には難しくなりますね。


インタラクティブドライビングシミュレータの実現

石原:先ほどの世界モデルをインタラクティブに世界の中を動き回ることができるように追加の学習を行ったものを、実際にドライビングシミュレータとして使えるようにセットアップしたというのがこのスライドになっています。

山口:これはさっき話していたCVPR 2026でテスラとNVIDIAが展示していたやつと基本的には同じようなものなんですね。

石原:そうですね。基本的には同じようなレシピで作られたものだと思っていただければ。

山口:聞いたところによるとNVIDIAのブース展示していたやつはかなりデータセンター向けのハイパワーのGPUを何台も使ってリアルタイム推論を実現していたと思うんですけども、今回の我々のやつはどのくらいのマシンパワーでリアルタイムで動かしているんですか?

石原:これ実はですね、RTX 4090というGPUを1つ使っているだけですね。

山口:NVIDIA製のいわゆるコンシューマー向けのGPUですね。一般の人がゲームとかやるPCとかに組み込む用の、今5090というのが一番最新の世代なんですけど、その1個前の世代の一番ハイエンドのやつを使っているということですかね。家庭用のGPU 1個でも結構このくらいのモデルをリアルタイムで動かすことができるようになっているということですね。

石原:できるようになってきました。

山口:もうちょっと自慢してもいいんじゃないですか?

石原:そうですね…(笑)。これ結構リアルタイムとは言っているんですけど、NVIDIAが出しているOmniDriveの方がやはりかなり推論の画像の更新頻度、FPSは高いです。こっちの方がまだまだ完全にリアルタイムではないんですけれども。

山口:そうですね。まあ1Hz、2Hzぐらいですかね。アクセル踏んだりハンドル切ったりした時のちょっと遅延ある感じ。

石原:そうですね。アクションの入力に対する反応性がまだちょっと改善のポイントになっています。

山口:今後に期待というところですね。


世界モデルの開発レシピ

石原:ここからは今のシミュレーターをどうやって作っていったかというところで、動画生成モデルをベースとしたマルチカメラモデルをどうやって作ったかというところから簡単にご紹介させていただきます。これが世界モデルのモデルの全体像でして、もしかしたら気が付くかもしれないんですけれども、かなりGAIA-2を意識したアーキテクチャになっております。入力としてマルチカメラのカメラ映像が左から入ってきまして、エンコーダーというのがあるんですけれども、エンコーダーで画像をレイテントの表現に圧縮をして、そこで大きなトランスフォーマーを動かして、将来の映像を生成してデコーダーでピクセル空間に復元するという動きをするモデルになっております。

山口:この辺の話は一般的な動画生成モデルとかでフレームのコンディショニングをしていくみたいな時でも似たような感じになっていますか?それともGAIA-2などの特有のアーキテクチャになっていますか?

石原:GAIA-2として特有のアーキテクチャになっているところで言うと、普通の動画生成モデルと大きく違うところは、基本的にはマルチカメラを扱うところと、アクションの条件付けが入力されているというところで、真ん中の水色で書いているところですね。行動の入力というのが追加されているというのが一番大きな分かりやすい違いになっています。

石原:先ほどの図で、エンコード・デコードをするというところがあったと思うんですが、実際にそれを行っているのがこのVideo Tokenizerです。なぜこのVideo Tokenizerが必要かというと、マルチカメラの映像をそのまま使うとかなり情報量が大きいので、これを強く圧縮して小さい表現にする必要があります。それを行っているのがVideo Tokenizer、VAE(Variational Autoencoder)という技術です。

石原:このVAE・Video Tokenizerとその前に紹介した世界モデル本体の2つでようやくパーツが揃ったということで、じゃあこれをどうやって学習するかということを説明しているのがこのスライドで、Flow Matchingという生成モデルを作るための学習手法を使っています。やっていることは何かというと、ノイズからデータへ向かう方向を予測するモデルです。この世界モデルというのが、ノイズを入力に受け取って、トラジェクトリの条件付けを入れて将来の映像を生成するということを行っています。

山口:よく対比として言われるDiffusion Model・拡散モデルと何が違うのかという話があると思っていて、拡散モデルも基本的にはノイズからなんかちょっとずつノイズを取り除く、デノイズするというのが基本的な考え方かなんですけれども、拡散モデルとFlow Matchingの関係についてちょっと教えてもらっていいですか?

石原:Diffusion ModelとFlow Matchingというのは非常に近い生成モデルの学習のやり方でして、拡散モデルというのは基本的にはノイズを徐々にデノイズしていくのでノイズのちょっとデノイズした先のまだノイズのデータを生成するというのを繰り返していくんですけれども、Flow Matchingの場合はノイズのちょっとデノイズした先ではなくてデノイズする方向を予測しているという違いがあります。

山口:そうすると何が嬉しいんでしょうか?

石原:一般的によく言われるのは拡散モデルよりも安定した学習ができるというのと、生成が早いというこの2つの大きな利点があるかなと思います。


石原:1番最初の方で話した一般的な動画生成モデルというのは、ある程度長い動画を一気に作るモデルという話をしたんですけれども、これを次のフレーム、次のフレームと徐々に生成させるために必要な学習のやり方をここに書いています。

まず、学習時にCausal Attention Maskというのを入れてコーザルという処理を行います。これは言語モデルでは一般的にやられていることなんですけれども、何をやっているかというと、今まで入力した過去の動画を見つつ次の将来の動画を生成するんですが、将来の動画トークンは過去の動画トークンを参照できないという制約をトランスフォーマーに加えて学習するというやり方がここに書いてある話です。

山口:機械学習に詳しい人はこの図を見てCausal Attention Maskはすぐ分かると思うんですけど、多分普通の人はこのマス目を見ても何も分からないと思うんですが、要するに未来の予想をするのに未来の情報を使ったらそれはなんかチートしてしまうから、見えないようにちょっと隠して学習したらうまく未来予想が学習できるよね、ということですよね。

石原:はい。そうです。

山口:で、次のKV Cacheですね。これもまたちょっと専門的な話になってきましたけど。

石原:はい。このKV Cacheというのも同じく言語モデルではもう定番になっている技術なんですけれども、今話した未来を隠しながら学習をさせるということを行うとこのKV Cacheというものを使うことができるようになります。これは何かというと、推論時に生成を速くするためのテクニックになっていまして、逐次的に画像フレームを生成していく際に、一度生成したところの計算結果を保存しておいて、次のステップの計算にその保存しておいた結果を再利用して次のフレームの生成を行うというテクニックです。これをすると推論がめちゃくちゃ高速になります。

山口:推論が早いのは嬉しいですね。これはプログラミングの話で言うといわゆるメモ化とかキャッシュみたいなところに当たるかなと思っていて、トランスフォーマーと呼ばれるアーキテクチャだとこの形式を取ってこう計算がどんどんされていくわけなんですが、入力した情報に対して毎回毎回計算していると物凄く時間がかかってしまうので、いい感じに昔計算したやつを再利用できるやつは取っておいて、必要になった時に呼び出せばその無駄に何回も計算するのを省けるから単純に早くなるよねということで、それが劇的にこの実際に動かす時に効果があるというのがこのKV Cacheで、最近のLLMとかでもほぼほぼこのKV Cacheで高速化するというのは一般的には行っているところかなと思います。

石原:今日話してきているリアルタイムに世界の中を動き回る世界モデルを作るためには必須の技術になっていて、いろんな世界モデルが出ていると思うんですけど、おそらくもうほとんど全てのこの世界モデルがこれを実際に行っています。

具体的に中身の説明をしていくと、逐次的に生成するようにできるのはいいんですけれども、モデル自身が生成した次のフレームを実際に入力にまた渡してさらにその次を生成していくということを繰り返して長いシーンを作っているんですけれども、こうすると何が難しいかというと、モデル自身が生成したシーンというのは必ずしも100%正しいわけじゃなくて、ハルシネーションをしていたりとかアーティファクトが出てしまったりすることがあるので、それをモデル自身が理解してちょっとずつ修正していくような能力を獲得するために必要な学習手法になっています。また、Flow Matchingのモデルというのは新しいシーンを作るためには何回も推論を行う必要があるので、これが多いとリアルタイム推論が間に合わないということになってくるので、これは減らしたい。このモデル自体の推論の回数を減らしつつかつ自分のこう間違いを徐々に修正していくことができるようにするための魔法のようなテクニックになっています。

山口:なんから自分自身のエラーが積み重なっていくというのは基本的にそうなのかなと思っていて、自分が予想したものをまた利用してどんどんやっていくから、一個間違いがあるとそれがどんどん広がっていくというのは直感的には分かる部分かなと思っていて、それをうまく修正するように学習できたらいい感じになんか整った予想ができるというのはその通りかなと思っていて、具体的にどうやってこのエラー修正をしているんですか?

石原:そうですね。具体的にどうやっているかというと、普通学習時はTeacher Forcingと言って実際のデータを持ってきて、それを入力して将来を生成させるというのが普通のやり方なんですけれども、ここでこう入力に実際の映像を入れてしまうと推論時もこの実際の映像が出てくるんじゃないかと期待してしまうわけですね。なのでどうするかというと、モデル自身が実際に生成したちょっと劣化したデータ・映像というのも作ります。そしてこれを実際の学習時の入力に当てはめるということを行います。こうするとエラーを含んでしまった映像から本当に良いシーンを生成するための学習、つまりエラー訂正ができるような学習ができるという仕組みになっています。

山口:なるほど。元々のオリジナルの綺麗なものが入力が入ってそれにこうスポイルされていると、実際に動かす時にそんなものが入力で常に来るわけではないのでなんかエラーがどんどん膨らんでしまうけれども、元々なんか自分が生成したものを学習時にもインプットとして入れるようにしておけば、その拡大はおそらく抑えられるんじゃないかという発想で、これは結構腑に落ちるところであります。

それとこのTeacher Forcingの、マルチステップからもう少し小さなステップに蒸留する部分は、どう関係があるんでしょうか?

石原:言ってしまうとちょっと独立した物事ではあるんですけれども、この蒸留をやっている理由は目的として小ステップで生成をできるようにしたいというのがあります。これはですね、Teacherと書いているのは先ほどお話した長い動画を一括で生成するモデルで、Studentと書いているのは逐次的に生成をするモデルですね。この逐次的に生成するモデルを細かく見ていくと、実際本当にやらなきゃいけないのは何回もこのモデルを推論させて新しいシーンを生成するということなんですけど、この推論のステップ数を減らしたいという目的でこのTeacher Studentという枠組みを入れて蒸留を行うということをやっています。

山口:発想としては蒸留の方が先にやりたい話としてはあるのかなと思っていて、やっぱりその推論を早くするというのは生成モデルに関してはかなり重要なステップかなと思っていて、ただそのまま蒸留するとモデルの学習とかディストレーション自体の安定化とかもかなり難しくなるので、そこでうまくその修正をするような仕組みを入れると蒸留がかなりうまくいくよみたいな流れの発想で作られたんじゃないかなというのはちょっとなんか想像はしますけれども。

石原:そうかもしれないですね。単純にその学習のステージをその分1個減らすことができるので、2つを組み合わせてやりやすかったというのもあるかもしれないです。


World-Action-Model(WAM)と実車公道走行

石原:最近よく話題になっているのがWorld-Action-Model(WAM)というものが登場しています。これは何かというと、これまではVLA(Vision-Language-Action)モデルというのがずっとトレンドとしてあったと思います。弊社もそれに取り組んできたんですけれども、2026年からこの世界モデルをバックボーンとしてアクションを生成させることができるように改変したモデル、これがワールドアクションモデルと呼ばれるパラダイムになっています。

これを何故取り上げたかというと、この紹介している論文が言っていることなんですけれども、単純にアクションを生成させるだけの学習をするよりも世界モデルタスクというのを同時に入れて学習させることで、同じデータ量で学習しても、より世界モデルタスクを含めた方が性能がぐんと上がるということを主張している論文になっています。なので我々も今後のトレンドとしてこのWAMというものにフォーカスを当てて、必要な技術を取り込んでE2Eのモデル開発に役立てる必要があるんじゃないかということで、この話題を取り上げさせてもらいました。

山口:世界モデルでアクションを出すということで、この世界モデルというのはこの映像を生成するとかアクションのコンディショニングをして、それに順じたシミュレータとして使うだけじゃなくて、何かアクションさせる。ロボットだったら何か物を掴むとかそういったところが、ロボティクスとかでも結構出てるところがあると思いますし、自動運転でもできるはず、つまり世界モデルに車を運転させることができるはずということですね。

石原:できると思います。

山口:お、何か来ました。何ですか?

石原:はい。私のいるDriving AI 3チームでは、実際にこのWAMという技術を使ってE2Eのモデル開発を行っています。そして先週、実際に車両にこのWAMで作った自動運転モデルをデプロイして、公道の試験まで行ってきました。

山口:これ運転してるのは、もしかして石原さん本人ですか?

石原:はい。そうですね。

山口:自分で作ったモデルを自分で試験をしているということで、チューリングの社員の人結構これ運転していますよね。これがまさに先ほど言っていた、自分たちで学習した世界モデルがあって、それにアクションのエクスパートの部分をつけて車を運転できるようにした、つまり車載でリアルタイムで推論できるようにと、そういったモデルを作って実際に自動運転システムの方に搭載したということですよね。アクセルとかブレーキとかステアリングも自動で動いてくれるということなんですか?

石原:はい。全て自動で動きます。

山口:素晴らしいですね。ロボットとかだとこのWAMでマニピュレーターとかを動かすとかは見たことがあるんですけれども、車でこう動かしているみたいな例というのは、かなり珍しいというかほとんど見たことないなと思っていて、実際この自動運転の文脈でこのWAMを実車で動かしたみたいな例というのは聞いたことがないですが、前例はあるのでしょうか。

石原:自分が知る限りは、パッと思いつくものはないですね。

山口:つまり世界初…。

石原:まあ全てのことを知る手段はないので分からないですけど(笑)。

山口:もうちょっと自慢してもいいのかなと思いますが(笑)。さらっと出てきたんで流されそうになっていましたけど、とにかく世界モデルを使って実際に車を走らせるぐらいのところまでチューリングの中では内部的に技術開発が進んでいるということですよね。

石原:はい。

山口:この辺の詳細がまた別の機会でどういう風になっているかというところをご紹介する機会もあるのかなと思いますけど、今日のところは実際に車を動かしていますよという紹介のところですね。この世界モデルの開発、今のチームでやり始めてどのくらいですかね?

石原:今のチームができたのが4月なので2ヶ月半ぐらいです。

山口:それでもう車を動かすところまで行っているということで、結構期待が持てる技術かなと思いますが、具体的にWAMとして車載にデプロイする過程での難しさはありましたか?

石原:一番難しかったところで言うと、やっぱり推論速度ですね。車載のコンピューターはOrinというもので動いているんですけれども、Orinに搭載可能なサイズで、かつリアルタイムに推論することができるという状態まで持っていくところが非常に難しかったです。基本的に世界モデルというのはかなり大きなモデルでして、小さいものでもおそらく2B(Billion)とか少なくともそれくらいのサイズはあるんですけど、さすがにこの大きさを車両に持っていくことはできないということで、車両でリアルタイムに動くアーキテクチャというものを最初に見繕っておいて、そこから学習するという手順で開発を進めました。

それをやると実際にリアルタイムで動かせるアーキテクチャを見つけることはできるんですけれども、やっぱりサイズが小さくなるということもあるので、動画生成モデルというのは基本的にモデルが大きくないとなかなか動画を作ったりすることができないというところで、その小さいモデルでうまく学習をするかというところも難しかった点だという風に感じていますね。

山口:元々車載で動く用にコンパクトに作らなきゃいけないというのが、普通のいわゆる動画生成のモデルとかのプレトレーニングされた動画をファインチューンしますよみたいなやつだとこれ全然乗らないみたいな話になるので、そもそもコンパクトになるようにうまく狙って作らなきゃいけなかったということですよね。


今後の展望

山口:なぜ世界モデルを使うのかという理由付けとして、我々で言うと今東京とか最近だと大阪とか名古屋でE2Eの自動運転モデルは動かしているんですが、そことの差、つまりパラメーターサイズもリアルタイムで動かそうとすると大体まあ似たような形になると思うんですが、世界モデルを使うと何が嬉しいでしょうか。

石原:チューリングは自社でデータ収集を行っているんですけれども、プロのドライバーさんも雇っていますし車両自体の数も限られているので、自分たちが使えるデータというのはやっぱり量が限られてしまいます。ですが、自分たちの競合であるWayveとかTeslaみたいなところというのは膨大にデータを持っているわけなんですよね。そこに勝つためにはどうすればいいかということを考えた時に、自分たちが持っているデータから得られる学習信号・情報、自動運転のモデルを作るための情報を最大限抽出しようというモチベーションがあります。

チューリングがメインストリームで開発しているモデルは基本的にアクションを使って模倣学習をしているんですけれども、WAMになってくるとその動画そのものも学習と学習の信号として使えます。そして動画は非常に大きな情報量があるのでこの学習信号を逃すのはもったいないというところで、持てるデータを最大限生かすためのアプローチとして私はこれを考えています。

山口:メインストリームで開発しているE2E自動運転は、いわゆるBehavior Cloningが中心になっていて、人間のドライバーのデータをうまく模倣するために基本的に学習しているんですが、そうではなくて、例えばバックボーンとして使うモデルとしてプレトレーニングでいろんな動画データをたくさん使うような形ができたら、もっと賢い運転・自動運転モデルの性能が上がるんじゃないかという仮説があって、そのアプローチとして世界モデルというのがその動画の情報量を一番使えるということで合ってますか?

石原:合ってます。

山口:世界モデルのところ、2026年はトレンドになってくるんじゃないかなという風に思っていますし、最近で言うとVLAと世界モデルを組み合わせる、例えばVLAのロスでワールド的なロスを加えるとか、それらを融合して学習するみたいな話も出ていますし、先日NVIDIAがCosmos 3というのを発表していましたよね。あれはなんか双子みたいな感じになっていて、片や生成モデル、片や言語モデルでそのクロスアテンションを共有して両方できるぞみたいな感じで出てきたんですけれども、世界モデルと言語モデルというのは技術的に系統としてちょっと異なるモデルではあるんですが、それが徐々に近づいていくみたいな話も技術トレンドとしてはもしかしたらあるのかなということをちょっと感じています。

両方ともロボティクスとか自動運転の分野では昔から注目されていた部分ではあるかなと思うので、この辺が今後どういう風に展開していくかというのは非常に楽しみなポイントがありますね。


Q&A一覧(一部抜粋)

以降は視聴者のQAに回答していきました。詳しくは動画をご覧ください。

  • 世界モデルはピクセル描画の精度の優先度、または完全に捨てるかで派閥が分かれている理解をしていますが、自動運転に関連する世界モデルにおいてはどれくらいピクセル再構成は重視されているのでしょうか?
  • WAMとVLAの関連の言及がありましたが、チューリングさんとしては今世界モデルは現行のE2Eとは独立したアプローチとして研究しているのでしょうか。
  • WAMの世界モデルヘッド(動画生成)は、推論時にも実際に未来映像を生成しているんでしょうか?それとも学習時の表現学習のためだけで、推論ではアクションエクスパートだけ動かしているんでしょうか?

チューリングでは、完全自動運転の技術を共に創る仲間を募集しています。今日お話しした世界モデルに取り組んでいるDriving AI 3チームはもちろんのこと、機械学習エンジニア、リサーチャー、ソフトウェアエンジニア、組み込みエンジニア、インフラエンジニアなど、非常に幅広いエンジニア職種で仲間を募集しています。ご興味のある方は、ぜひ採用ページをご確認ください。多様な職種がありますので、ご自身がどれに当てはまるか、ぜひチェックしてみてください。